
opción
Hogar
Última hora
Contenido
RyanLopez
RyanLopez
25 de mayo de 2026

Un equipo conjunto de la Universidad de Tsinghua y Tencent ganó el campeonato mundial en el desafío de optimización de inferencia de modelos MoE de MLSys2026, organizado por el Ministerio de Educación. Desarrollaron una solución de optimización completa para modelos MoE con billones de parámetros, utilizando hardware NPU, y incorporaron estrategias innovadoras como la partición E-Shard y la concurrencia mediante PSUM/GEMV. Gracias a un optimizador automático llamado Knight, su enfoque redujo el tiempo total de inferencia de 14.91 segundos a 3.56 segundos, lo que representa una aceleración del rendimiento de 4.1 veces. Este resultado constituye un modelo técnico clave para la implementación de modelos MoE de gran escala en futuras plataformas de computación de super-nodos.
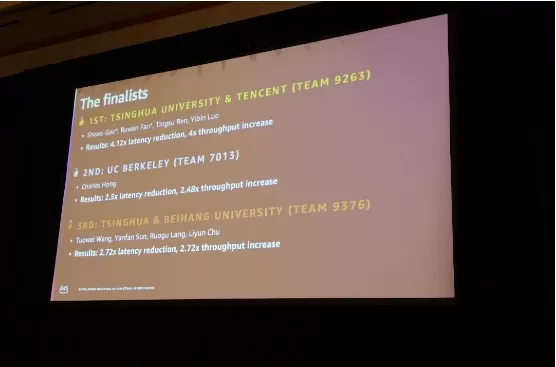
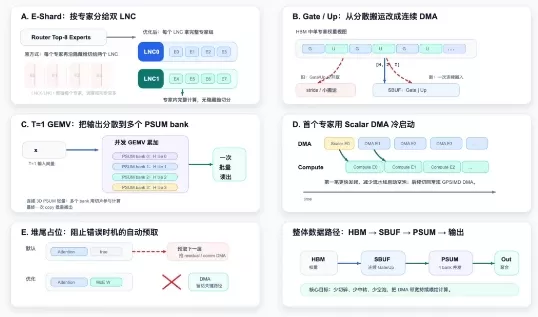
Un equipo conjunto de la Universidad de Tsinghua y Tencent ganó el campeonato mundial en el desafío de optimización de inferencia de modelos MoE de MLSys2026, organizado por el Ministerio de Educación. Desarrollaron una solución de optimización completa para modelos MoE con billones de parámetros, utilizando hardware NPU, y incorporaron estrategias innovadoras como la partición E-Shard y la concurrencia mediante PSUM/GEMV. Gracias a un optimizador automático llamado Knight, su enfoque redujo el tiempo total de inferencia de 14.91 segundos a 3.56 segundos, lo que representa una aceleración del rendimiento de 4.1 veces. Este resultado constituye un modelo técnico clave para la implementación de modelos MoE de gran escala en futuras plataformas de computación de super-nodos. Un equipo conjunto de la Universidad de Tsinghua y Tencent ganó el campeonato mundial en el desafío de optimización de inferencia de modelos MoE de MLSys2026, organizado por el Ministerio de Educación. Desarrollaron una solución de optimización completa para modelos MoE con billones de parámetros, utilizando hardware NPU, y incorporaron estrategias innovadoras como la partición E-Shard y la concurrencia mediante PSUM/GEMV. Gracias a un optimizador automático llamado Knight, su enfoque redujo el tiempo total de inferencia de 14.91 segundos a 3.56 segundos, lo que representa una aceleración del rendimiento de 4.1 veces. Este resultado constituye un modelo técnico clave para la implementación de modelos MoE de gran escala en futuras plataformas de computación de super-nodos.
comentario (0)
0/300
OR