Descubra ferramentas de qualidade de qualidade
Reunir as principais ferramentas de inteligência artificial do mundo para ajudar a melhorar a eficiência do trabalho

Artigos publicados por RyanLopez
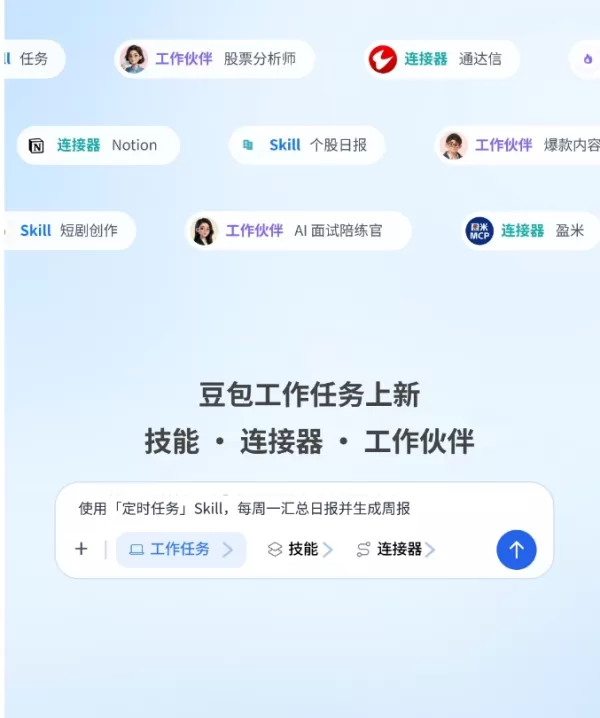
A Doubao lançou uma atualização significativa em seu modo de tarefas, introduzindo três novos recursos (habilidades, conectores e parceiros de trabalho) para aprimorar suas funcionalidades de escritório colaborativo. A plataforma agora oferece mais de 200 habilidades e conectores prontos, além de permitir que os usuários criem habilidades personalizadas para fluxos de trabalho padronizados. As habilidades permitem que os usuários salvem métodos de trabalho personalizados, como padrões de formatação de documentos, facilitando seu uso repetido. Os conectores integram a Doubao a outras ferramentas de escritório, permitindo que os usuários busquem informações e gerenciem tarefas diretamente no aplicativo, sem precisar alternar páginas ou fazer upload manual de arquivos. Os parceiros de trabalho disponibilizam agentes inteligentes especializados em áreas como análise de dados, planejamento de conteúdo, pesquisa e finanças, ajudando os usuários a montar equipes para projetos complexos. Esses recursos podem ser utilizados individualmente ou combinados, contribuindo para simplificar os fluxos de trabalho e aumentar a eficiência no ambiente de escritório. Os usuários podem acessá-los por meio da opção “Habilidades · Conectores · Parceiros” na versão desktop da Doubao. Essa atualização marca a transição da Doubao de uma assistente conversacional para uma plataforma inteligente de escritório.
A Doubao lançou uma atualização significativa em seu modo de tarefas, introduzindo três novos recursos (habilidades, conectores e parceiros de trabalho) para aprimorar suas funcionalidades de escritório colaborativo. A plataforma agora oferece mais de 200 habilidades e conectores prontos, além de permitir que os usuários criem habilidades personalizadas para fluxos de trabalho padronizados. As habilidades permitem que os usuários salvem métodos de trabalho personalizados, como padrões de formatação de documentos, facilitando seu uso repetido. Os conectores integram a Doubao a outras ferramentas de escritório, permitindo que os usuários busquem informações e gerenciem tarefas diretamente no aplicativo, sem precisar alternar páginas ou fazer upload manual de arquivos. Os parceiros de trabalho disponibilizam agentes inteligentes especializados em áreas como análise de dados, planejamento de conteúdo, pesquisa e finanças, ajudando os usuários a montar equipes para projetos complexos. Esses recursos podem ser utilizados individualmente ou combinados, contribuindo para simplificar os fluxos de trabalho e aumentar a eficiência no ambiente de escritório. Os usuários podem acessá-los por meio da opção “Habilidades · Conectores · Parceiros” na versão desktop da Doubao. Essa atualização marca a transição da Doubao de uma assistente conversacional para uma plataforma inteligente de escritório.
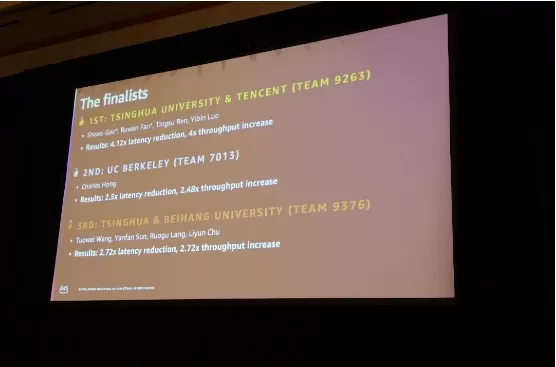
Uma equipe conjunta da Universidade Tsinghua e da Tencent venceu o campeonato global no desafio de otimização de inferência de modelos MoE da MLSys2026. Eles desenvolveram uma solução de otimização completa para modelos MoE com trilhões de parâmetros em hardware NPU, utilizando estratégias inovadoras como partição E-Shard e concorrência PSUM/GEMV. Com a ajuda de um otimizador automatizado chamado Knight, seu método reduziu o tempo total de inferência de 14,91 segundos para 3,56 segundos, alcançando uma aceleração de desempenho de 4,1 vezes. Isso representa um paradigma engenhosístico importante para a implementação de modelos MoE de grande escala em futuras plataformas de computação de super-nós.
Uma equipe conjunta da Universidade Tsinghua e da Tencent venceu o campeonato global no desafio de otimização de inferência de modelos MoE da MLSys2026. Eles desenvolveram uma solução de otimização completa para modelos MoE com trilhões de parâmetros em hardware NPU, utilizando estratégias inovadoras como partição E-Shard e concorrência PSUM/GEMV. Com a ajuda de um otimizador automatizado chamado Knight, seu método reduziu o tempo total de inferência de 14,91 segundos para 3,56 segundos, alcançando uma aceleração de desempenho de 4,1 vezes. Isso representa um paradigma engenhosístico importante para a implementação de modelos MoE de grande escala em futuras plataformas de computação de super-nós.
A OpenAI lançou o GPT-5.5Instant como o novo modelo padrão do ChatGPT, substituindo o GPT-5.O 3Instant apresenta um raciocínio aprimorado, com pontuações mais altas nos benchmarks AIME2025 e MMMU-Pro, além de reduzir vieses cognitivos nas áreas de direito, medicina e finanças. Os principais recursos incluem gerenciamento de contexto aprimorado, utilizando ferramentas de pesquisa para respostas personalizadas, e um mecanismo de fonte de memória visualizado para maior transparência. O modelo já está disponível para usuários do Web PlusPro, com um lançamento mais amplo planejado. O GPT-5.5 será oferecido via API como chat-latest, enquanto o GPT-5.3Instant continua sendo uma opção paga por três meses
A OpenAI lançou o GPT-5.5Instant como o novo modelo padrão do ChatGPT, substituindo o GPT-5.O 3Instant apresenta um raciocínio aprimorado, com pontuações mais altas nos benchmarks AIME2025 e MMMU-Pro, além de reduzir vieses cognitivos nas áreas de direito, medicina e finanças. Os principais recursos incluem gerenciamento de contexto aprimorado, utilizando ferramentas de pesquisa para respostas personalizadas, e um mecanismo de fonte de memória visualizado para maior transparência. O modelo já está disponível para usuários do Web PlusPro, com um lançamento mais amplo planejado. O GPT-5.5 será oferecido via API como chat-latest, enquanto o GPT-5.3Instant continua sendo uma opção paga por três meses
A Honor lançou o YOYO Claw, seu agente de IA para dispositivos móveis desenvolvido internamente, que será introduzido pela primeira vez na série MagicBook. Segundo a empresa, a tecnologia reduz o consumo total de tokens em 50%, com base em testes realizados pela própria empresa, com o objetivo de diminuir os custos para o usuário e melhorar a acessibilidade dos recursos de IA
A Honor lançou o YOYO Claw, seu agente de IA para dispositivos móveis desenvolvido internamente, que será introduzido pela primeira vez na série MagicBook. Segundo a empresa, a tecnologia reduz o consumo total de tokens em 50%, com base em testes realizados pela própria empresa, com o objetivo de diminuir os custos para o usuário e melhorar a acessibilidade dos recursos de IA

A Nvidia investiu mais US$ 2 bilhões na provedora de nuvem CoreWeave para acelerar a construção de data centers de IA. A parceria ampliada inclui a construção conjunta de fábricas de IA e a integração dos próximos chips Rubin da Nvidia. As ações da CoreWeave subiram mais de 15% após o anúncio.
A Nvidia investiu mais US$ 2 bilhões na provedora de nuvem CoreWeave para acelerar a construção de data centers de IA. A parceria ampliada inclui a construção conjunta de fábricas de IA e a integração dos próximos chips Rubin da Nvidia. As ações da CoreWeave subiram mais de 15% após o anúncio.
A Nvidia investe US$ 2 bilhões na empresa de data centers de IA CoreWeave para acelerar a construção de mais de 5 gigawatts de capacidade de computação de IA até 2030. As empresas construirão conjuntamente data centers de IA usando os próximos chips Rubin, CPUs e sistemas de armazenamento da Nvidia. As ações da CoreWeave subiram mais de 15% com a notícia do acordo.
A Nvidia investe US$ 2 bilhões na empresa de data centers de IA CoreWeave para acelerar a construção de mais de 5 gigawatts de capacidade de computação de IA até 2030. As empresas construirão conjuntamente data centers de IA usando os próximos chips Rubin, CPUs e sistemas de armazenamento da Nvidia. As ações da CoreWeave subiram mais de 15% com a notícia do acordo.
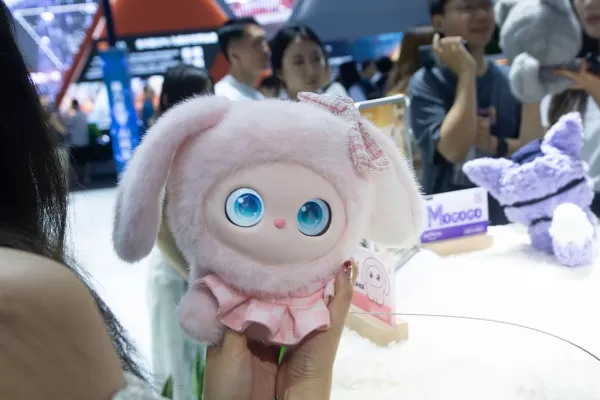
O senador da Califórnia Steve Padilla apresentou o projeto de lei SB 867, que propõe uma proibição de quatro anos à venda e fabricação de brinquedos com chatbots de IA para menores de 18 anos. O objetivo é dar tempo para desenvolver regulamentos de segurança em meio a preocupações com interações perigosas enfrentadas por menores. Exemplos de problemas incluem brinquedos anteriores que promoviam temas prejudiciais.
O senador da Califórnia Steve Padilla apresentou o projeto de lei SB 867, que propõe uma proibição de quatro anos à venda e fabricação de brinquedos com chatbots de IA para menores de 18 anos. O objetivo é dar tempo para desenvolver regulamentos de segurança em meio a preocupações com interações perigosas enfrentadas por menores. Exemplos de problemas incluem brinquedos anteriores que promoviam temas prejudiciais.
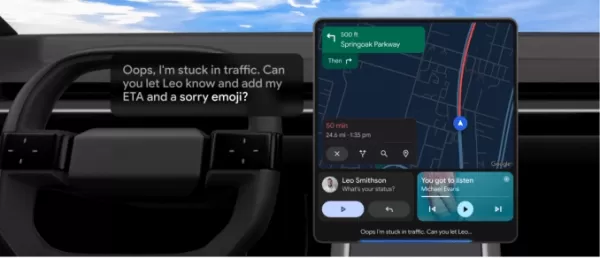
O Google está substituindo o Google Assistant por sua IA Gemini no Android Auto para carros A implementação começa agora globalmente em 45 idiomas, permitindo que os usuários tenham conversas naturais para concluir tarefas como encontrar restaurantes ao longo de uma rota, resumir mensagens e e-mails e criar listas de reprodução de músicas
O Google está substituindo o Google Assistant por sua IA Gemini no Android Auto para carros A implementação começa agora globalmente em 45 idiomas, permitindo que os usuários tenham conversas naturais para concluir tarefas como encontrar restaurantes ao longo de uma rota, resumir mensagens e e-mails e criar listas de reprodução de músicas
A Tigris Data levanta US$ 25 milhões da Série A liderada pela Spark Capital para sua plataforma de armazenamento distribuído nativo de IA, desafiando a AWS, o Google Cloud e o Azure ao eliminar taxas de saída e reduzir a latência. Voltada para startups de IA que precisam de acesso de baixa latência, a Tigris dimensiona as cargas de trabalho de computação globalmente e, ao mesmo tempo, aborda as preocupações com o controle de dados em setores regulamentados. A empresa planeja expansão nos EUA, Europa e Ásia.
A Tigris Data levanta US$ 25 milhões da Série A liderada pela Spark Capital para sua plataforma de armazenamento distribuído nativo de IA, desafiando a AWS, o Google Cloud e o Azure ao eliminar taxas de saída e reduzir a latência. Voltada para startups de IA que precisam de acesso de baixa latência, a Tigris dimensiona as cargas de trabalho de computação globalmente e, ao mesmo tempo, aborda as preocupações com o controle de dados em setores regulamentados. A empresa planeja expansão nos EUA, Europa e Ásia.
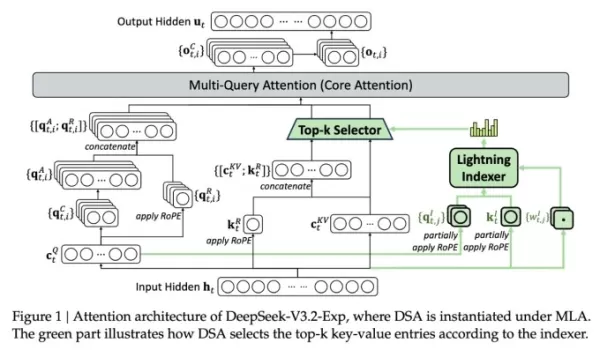
Os pesquisadores do DeepSeek lançaram o V3.2-exp, um modelo com DeepSeek Sparse Attention para reduzir os custos de inferência de contexto longo em até 50%, usando um indexador relâmpago e um sistema de seleção de token. Com peso aberto no Hugging Face, ele visa otimizar a eficiência do transformador.
Os pesquisadores do DeepSeek lançaram o V3.2-exp, um modelo com DeepSeek Sparse Attention para reduzir os custos de inferência de contexto longo em até 50%, usando um indexador relâmpago e um sistema de seleção de token. Com peso aberto no Hugging Face, ele visa otimizar a eficiência do transformador.