
Option
Heim
Eilmeldung
Inhalt
RyanLopez
RyanLopez
25. Mai 2026

Ein gemeinsames Team der Tsinghua-Universität und von Tencent gewann den weltweiten Wettbewerb bei der MLSys2026’s MoE Model Inference Optimization Challenge. Sie entwickelten eine Lösung für die Optimierung vollständiger Ketten von MoE-Modellen mit Billionen von Parametern auf NPU-Hardware, wobei sie neuartige Strategien wie die E-Shard-Partitionierung sowie die Parallelisierung mittels PSUM/GEMV einsetzten. Mit Hilfe eines automatisierten Optimierers namens Knight konnten sie die Gesamtzeit für die Ausführung der Berechnungen von 14,91 Sekunden auf 3,56 Sekunden reduzieren – das entspricht einer Leistungssteigerung um den Faktor 4,1. Diese Entwicklung bietet einen wichtigen Ansatz dafür, große MoE-Modelle auf zukünftigen Superknotenrechnersystemen einzusetzen.
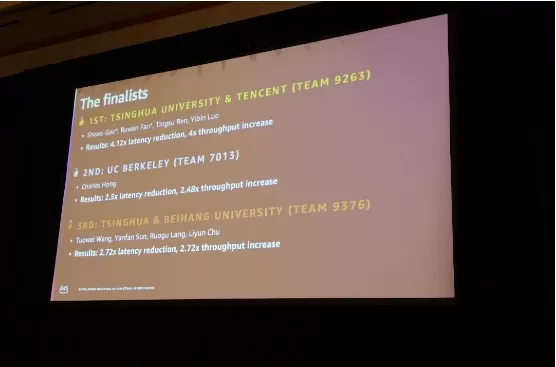
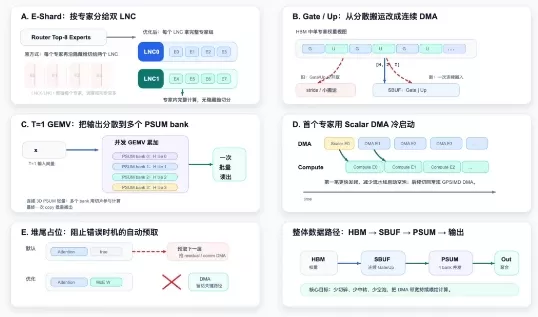
Ein gemeinsames Team der Tsinghua-Universität und von Tencent gewann den weltweiten Wettbewerb bei der MLSys2026’s MoE Model Inference Optimization Challenge. Sie entwickelten eine Lösung für die Optimierung vollständiger Ketten von MoE-Modellen mit Billionen von Parametern auf NPU-Hardware, wobei sie neuartige Strategien wie die E-Shard-Partitionierung sowie die Parallelisierung mittels PSUM/GEMV einsetzten. Mit Hilfe eines automatisierten Optimierers namens Knight konnten sie die Gesamtzeit für die Ausführung der Berechnungen von 14,91 Sekunden auf 3,56 Sekunden reduzieren – das entspricht einer Leistungssteigerung um den Faktor 4,1. Diese Entwicklung bietet einen wichtigen Ansatz dafür, große MoE-Modelle auf zukünftigen Superknotenrechnersystemen einzusetzen. Ein gemeinsames Team der Tsinghua-Universität und von Tencent gewann den weltweiten Wettbewerb bei der MLSys2026’s MoE Model Inference Optimization Challenge. Sie entwickelten eine Lösung für die Optimierung vollständiger Ketten von MoE-Modellen mit Billionen von Parametern auf NPU-Hardware, wobei sie neuartige Strategien wie die E-Shard-Partitionierung sowie die Parallelisierung mittels PSUM/GEMV einsetzten. Mit Hilfe eines automatisierten Optimierers namens Knight konnten sie die Gesamtzeit für die Ausführung der Berechnungen von 14,91 Sekunden auf 3,56 Sekunden reduzieren – das entspricht einer Leistungssteigerung um den Faktor 4,1. Diese Entwicklung bietet einen wichtigen Ansatz dafür, große MoE-Modelle auf zukünftigen Superknotenrechnersystemen einzusetzen.
Kommentare (0)
0/300
OR