


 Lar
A NVIDIA torna o PAIR de código aberto para unir Macs e PCs com RTX em um único cluster de IA
A NVIDIA lançou o software Personal AI Router (PAIR) em uma versão beta de código aberto, que funciona como um agendador de rede local que direciona as solicitações de IA para os computadores disponíveis.
Detecção automática de dispositivos e alocação de solicitações: benefícios diretos para o Ollama e o LM Studio
Em hardware compatível, incluindo Macs M4+, PCs com NVIDIA RTX e DGX Spark, o PAIR oferece uma interface unificada para ferramentas locais de IA, como o Ollama e o LM Studio. Isso permite que os usuários distribuam várias tarefas independentes de IA entre dispositivos ociosos em uma rede doméstica ou de escritório.
Projetado como um agendador local de solicitações, o PAIR detecta automaticamente os computadores conectados e atribui tarefas aos recursos disponíveis. Como os modelos continuam sendo executados via Ollama ou LM Studio no dispositivo de destino, os usuários evitam configurar cada máquina individualmente. Se um dispositivo estiver ocupado, o PAIR redireciona as solicitações para outros nós emparelhados. Por exemplo, agentes de IA que processam vários documentos podem atribuir tarefas independentes a computadores diferentes. A NVIDIA esclarece que isso distribui cargas de trabalho simultâneas e não acelera respostas individuais de IA por meio da combinação de poder de computação.
Teste de desempenho: divisão de tarefas reduz o tempo de 18 minutos para 8 minutos e 48 segundos
A demonstração da NVIDIA mostrou que, ao usar o Ollama com o modelo Qwen 3.6 35B A3B no Hermes, a divisão de tarefas entre cinco subagentes de IA reduziu o tempo médio de conclusão para um único laptop RTX Spark de 18 minutos para 8 minutos e 48 segundos após a adição de um DGX Spark e uma RTX 5090.
Artigo relacionado
 A startup de IA do Reino Unido, Emulate, inicia captação de recursos com meta de até US$ 700 milhões e avaliação de US$ 3,7 bilhões
Na quarta-feira, 16 de setembro, a startup britânica de inteligência artificial Emulate anunciou uma nova rodada de investimentos que visa até US$ 700 milhões, alcançando uma avaliação pós-investimento de aproximadamente US$ 3,7 bilhões. A rodada foi
Fundadores de IA debatem modelos abertos versus fechados no TechCrunch Disrupt 2026
Para startups de IA, a seleção de um modelo não é mais apenas uma escolha arquitetural única.Os modelos abertos estão ficando melhores. As APIs de ponta continuam melhorando. Os modelos podem ser adaptados para tarefas específicas, e algumas empresas
O Kimi K2.5 da Moonshot AI, o primeiro modelo multimodal com um trilhão de parâmetros, será descontinuado no final do mês
A Moonshot anunciou através do Weibo oficial do Kimi que seu primeiro modelo multimodal de trilhão de parâmetros, o Kimi K2.5, será descontinuado até o final deste mês. Lançado e disponibilizado como código aberto em janeiro, o K2.5 é o modelo mais v
Recomendações de tópicos especiais relacionados
Produtividade
 As melhores ferramentas de triagem de e-mails com IA para a produtividade da equipe
As melhores e mais bem avaliadas ferramentas de triagem de e-mails com IA de 2026 para aumentar a produtividade da equipe! A XIX.AI seleciona um conjunto poderoso e revolucionário de ferramentas imperdíveis que ajudam as equipes a classificar rapidamente grandes volumes de e-mails, aumentar a eficiência na redação e economizar inúmeras horas por semana. Nossos rigorosos testes práticos e rankings atualizados garantem que você encontre a opção perfeita para o seu fluxo de trabalho. Explore agora para aproveitar ao máximo as vantagens da IA!
 10 ferramentas
 xix.ai
Composição musical
Os melhores assistentes de composição musical com IA: crie letras, acordes e melodias
Os melhores assistentes de composição musical com IA de 2026, com as melhores avaliações, já estão disponíveis no XIX.AI! Esta lista selecionada apresenta ferramentas extremamente eficientes, submetidas a testes práticos para oferecer letras, acordes e melodias de alta qualidade com facilidade. Confira uma comparação entre as versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades criativas. Explore agora mesmo e descubra como a IA pode impulsionar sua criação musical!
12 ferramentas
xix.ai
automação
Principais criadores de agentes de IA: crie automações de negócios em várias etapas
2026: Os melhores criadores de agentes de IA mais bem avaliados para a criação de automações empresariais em várias etapas. Esta lista selecionada apresenta ferramentas poderosas e revolucionárias que passam por rigorosos testes no mundo real. Você encontrará comparações detalhadas entre versões gratuitas e pagas, classificações abrangentes e análises atualizadas semanalmente para ajudá-lo a escolher a solução perfeita que aumentará significativamente sua produtividade. Explore agora no XIX.AI para aproveitar ao máximo sua vantagem em IA!
11 ferramentas
xix.ai
Produtividade
Ferramentas de planejamento de tarefas com IA para profissionais ocupados
As melhores e mais bem avaliadas ferramentas de planejamento de tarefas com IA de 2026 para profissionais ocupados! A XIX.AI selecionou um conjunto poderoso e inovador de ferramentas altamente eficientes que ajudam os usuários a otimizar fluxos de trabalho, aumentar a produtividade e superar os desafios diários de agendamento. Cada opção passa por testes rigorosos em condições reais para garantir sua confiabilidade. Veja uma comparação entre versões gratuitas e pagas e descubra a ferramenta perfeita para aproveitar ao máximo sua vantagem com IA. Explore agora!
15 ferramentas
xix.ai
chatbot
Principais Chatbots de Atendimento ao Cliente com IA: Responda a Perguntas Frequentes e Qualifique Leads 24 horas por dia, 7 dias por semana
Os chatbots de atendimento ao cliente por IA mais bem avaliados de 2026, destacados nesta lista curada, são as melhores soluções para responder instantaneamente às perguntas frequentes dos clientes e qualificar leads 24 horas por dia. A XIX.AI realizou testes rigorosos no mundo real para oferecer uma comparação detalhada entre as versões gratuita e paga, juntamente com classificações atualizadas, ajudando você a encontrar uma ferramenta poderosa e transformadora que aumenta significativamente a produtividade. Explore agora para descobrir sua solução perfeita de chatbot com IA!
9 ferramentas
xix.ai
Design e Arte
Geradores de storyboards com IA para equipes de criação publicitária
Os melhores geradores de storyboards com IA de 2026 para equipes de criação publicitária! A XIX.AI selecionou uma lista dos melhores e mais poderosos geradores de storyboards com IA — ferramentas revolucionárias que ajudam as equipes a criar conteúdos visuais impressionantes com mais rapidez, por meio de testes práticos e rankings rigorosos atualizados semanalmente. Confira uma comparação entre opções gratuitas e pagas para encontrar a solução perfeita para o seu fluxo de trabalho. Explore agora para aproveitar toda a vantagem da IA na criação de anúncios!
8 ferramentas
xix.ai

 Comentários (0)
A NVIDIA lançou o software Personal AI Router (PAIR) em uma versão beta de código aberto, que funciona como um agendador de rede local que direciona as solicitações de IA para os computadores disponíveis.
Detecção automática de dispositivos e alocação de solicitações: benefícios diretos para o Ollama e o LM Studio
Em hardware compatível, incluindo Macs M4+, PCs com NVIDIA RTX e DGX Spark, o PAIR oferece uma interface unificada para ferramentas locais de IA, como o Ollama e o LM Studio. Isso permite que os usuários distribuam várias tarefas independentes de IA entre dispositivos ociosos em uma rede doméstica ou de escritório.
Projetado como um agendador local de solicitações, o PAIR detecta automaticamente os computadores conectados e atribui tarefas aos recursos disponíveis. Como os modelos continuam sendo executados via Ollama ou LM Studio no dispositivo de destino, os usuários evitam configurar cada máquina individualmente. Se um dispositivo estiver ocupado, o PAIR redireciona as solicitações para outros nós emparelhados. Por exemplo, agentes de IA que processam vários documentos podem atribuir tarefas independentes a computadores diferentes. A NVIDIA esclarece que isso distribui cargas de trabalho simultâneas e não acelera respostas individuais de IA por meio da combinação de poder de computação.
Teste de desempenho: divisão de tarefas reduz o tempo de 18 minutos para 8 minutos e 48 segundos
A demonstração da NVIDIA mostrou que, ao usar o Ollama com o modelo Qwen 3.6 35B A3B no Hermes, a divisão de tarefas entre cinco subagentes de IA reduziu o tempo médio de conclusão para um único laptop RTX Spark de 18 minutos para 8 minutos e 48 segundos após a adição de um DGX Spark e uma RTX 5090.








 A startup de IA do Reino Unido, Emulate, inicia captação de recursos com meta de até US$ 700 milhões e avaliação de US$ 3,7 bilhões
Na quarta-feira, 16 de setembro, a startup britânica de inteligência artificial Emulate anunciou uma nova rodada de investimentos que visa até US$ 700 milhões, alcançando uma avaliação pós-investimento de aproximadamente US$ 3,7 bilhões. A rodada foi
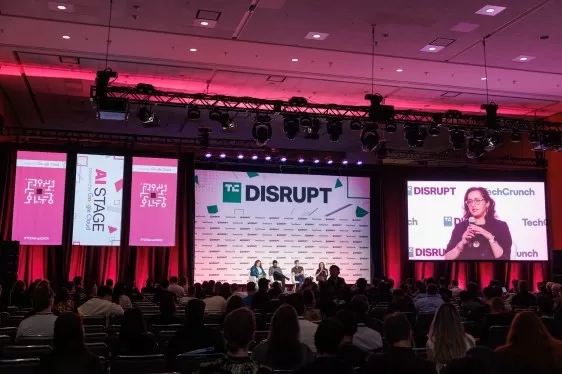 Fundadores de IA debatem modelos abertos versus fechados no TechCrunch Disrupt 2026
Para startups de IA, a seleção de um modelo não é mais apenas uma escolha arquitetural única.Os modelos abertos estão ficando melhores. As APIs de ponta continuam melhorando. Os modelos podem ser adaptados para tarefas específicas, e algumas empresas
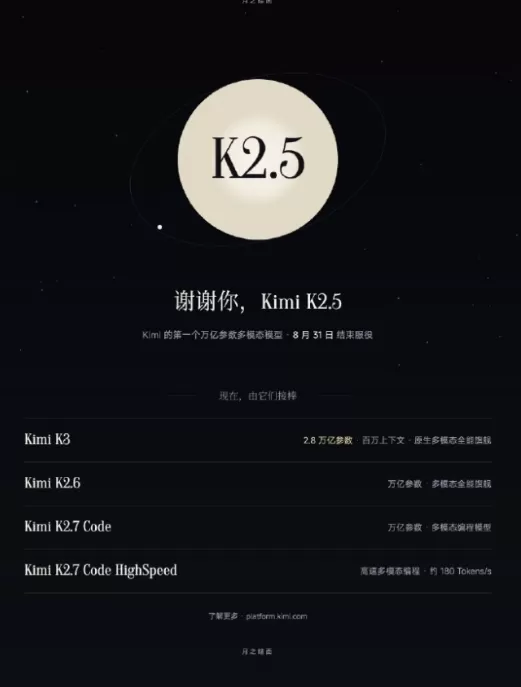 O Kimi K2.5 da Moonshot AI, o primeiro modelo multimodal com um trilhão de parâmetros, será descontinuado no final do mês
A Moonshot anunciou através do Weibo oficial do Kimi que seu primeiro modelo multimodal de trilhão de parâmetros, o Kimi K2.5, será descontinuado até o final deste mês. Lançado e disponibilizado como código aberto em janeiro, o K2.5 é o modelo mais v
As melhores e mais bem avaliadas ferramentas de triagem de e-mails com IA de 2026 para aumentar a produtividade da equipe! A XIX.AI seleciona um conjunto poderoso e revolucionário de ferramentas imperdíveis que ajudam as equipes a classificar rapidamente grandes volumes de e-mails, aumentar a eficiência na redação e economizar inúmeras horas por semana. Nossos rigorosos testes práticos e rankings atualizados garantem que você encontre a opção perfeita para o seu fluxo de trabalho. Explore agora para aproveitar ao máximo as vantagens da IA!
10 ferramentas
xix.ai
Os melhores assistentes de composição musical com IA de 2026, com as melhores avaliações, já estão disponíveis no XIX.AI! Esta lista selecionada apresenta ferramentas extremamente eficientes, submetidas a testes práticos para oferecer letras, acordes e melodias de alta qualidade com facilidade. Confira uma comparação entre as versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades criativas. Explore agora mesmo e descubra como a IA pode impulsionar sua criação musical!
12 ferramentas
xix.ai
2026: Os melhores criadores de agentes de IA mais bem avaliados para a criação de automações empresariais em várias etapas. Esta lista selecionada apresenta ferramentas poderosas e revolucionárias que passam por rigorosos testes no mundo real. Você encontrará comparações detalhadas entre versões gratuitas e pagas, classificações abrangentes e análises atualizadas semanalmente para ajudá-lo a escolher a solução perfeita que aumentará significativamente sua produtividade. Explore agora no XIX.AI para aproveitar ao máximo sua vantagem em IA!
11 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de planejamento de tarefas com IA de 2026 para profissionais ocupados! A XIX.AI selecionou um conjunto poderoso e inovador de ferramentas altamente eficientes que ajudam os usuários a otimizar fluxos de trabalho, aumentar a produtividade e superar os desafios diários de agendamento. Cada opção passa por testes rigorosos em condições reais para garantir sua confiabilidade. Veja uma comparação entre versões gratuitas e pagas e descubra a ferramenta perfeita para aproveitar ao máximo sua vantagem com IA. Explore agora!
15 ferramentas
xix.ai
Os chatbots de atendimento ao cliente por IA mais bem avaliados de 2026, destacados nesta lista curada, são as melhores soluções para responder instantaneamente às perguntas frequentes dos clientes e qualificar leads 24 horas por dia. A XIX.AI realizou testes rigorosos no mundo real para oferecer uma comparação detalhada entre as versões gratuita e paga, juntamente com classificações atualizadas, ajudando você a encontrar uma ferramenta poderosa e transformadora que aumenta significativamente a produtividade. Explore agora para descobrir sua solução perfeita de chatbot com IA!
9 ferramentas
xix.ai
Os melhores geradores de storyboards com IA de 2026 para equipes de criação publicitária! A XIX.AI selecionou uma lista dos melhores e mais poderosos geradores de storyboards com IA — ferramentas revolucionárias que ajudam as equipes a criar conteúdos visuais impressionantes com mais rapidez, por meio de testes práticos e rankings rigorosos atualizados semanalmente. Confira uma comparação entre opções gratuitas e pagas para encontrar a solução perfeita para o seu fluxo de trabalho. Explore agora para aproveitar toda a vantagem da IA na criação de anúncios!
8 ferramentas
xix.ai












