


 Hogar
NVIDIA convierte PAIR en código abierto para unir los Mac y los ordenadores con RTX en un único clúster de IA
NVIDIA ha lanzado el software Personal AI Router (PAIR) en una versión beta de código abierto, que funciona como un programador de red local que dirige las solicitudes de IA a los ordenadores disponibles.
Detección automática de dispositivos y asignación de solicitudes: ventajas directas para Ollama y LM Studio
En hardware compatible, como los Mac M4+, los PC con NVIDIA RTX y DGX Spark, PAIR ofrece una interfaz unificada para herramientas de IA locales como Ollama y LM Studio. Esto permite a los usuarios distribuir múltiples tareas de IA independientes entre los dispositivos inactivos de una red doméstica o de oficina.
Diseñado como un programador de solicitudes local, PAIR detecta automáticamente los ordenadores conectados y asigna tareas a los recursos disponibles. Dado que los modelos siguen ejecutándose a través de Ollama o LM Studio en el dispositivo de destino, los usuarios evitan tener que configurar cada máquina individualmente. Si un dispositivo está ocupado, PAIR redirige las solicitudes a otros nodos emparejados. Por ejemplo, los agentes de IA que procesan varios documentos pueden asignar tareas independientes a diferentes ordenadores. NVIDIA aclara que esto distribuye las cargas de trabajo simultáneas y no acelera las respuestas individuales de IA mediante la combinación de potencia de cálculo.
Prueba de rendimiento: la división de tareas reduce el tiempo de 18 minutos a 8 minutos y 48 segundos
La demostración de NVIDIA mostró que, al utilizar Ollama con el modelo Qwen 3.6 35B A3B en Hermes, la división de tareas entre cinco subagentes de IA redujo el tiempo medio de finalización para un único portátil RTX Spark de 18 minutos a 8 minutos y 48 segundos tras añadir un DGX Spark y una RTX 5090.
Artículo relacionado
 La startup británica de inteligencia artificial Emulate inicia una ronda de financiación con un objetivo de hasta 700 millones de dólares y una valoración de 3.700 millones de dólares
El miércoles 16 de septiembre, la startup de inteligencia artificial con sede en el Reino Unido Emulate anunció una nueva ronda de financiación que busca hasta 700 millones de dólares, alcanzando una valoración posterior a la ronda de aproximadamente
Los fundadores de empresas de IA debaten sobre modelos abiertos frente a modelos cerrados en TechCrunch Disrupt 2026
Para las startups de inteligencia artificial, seleccionar un modelo ya no es solo una decisión arquitectónica puntual.Los modelos abiertos están mejorando. Las APIs de vanguardia siguen perfeccionándose. Los modelos pueden adaptarse a tareas específi
El Kimi K2.5 de Moonshot AI, el primer modelo multimodal con un billón de parámetros, se retira a finales de mes
Moonshot anunció a través de la cuenta oficial de Weibo de Kimi que su primer modelo multimodal de billones de parámetros, Kimi K2.5, será retirado a finales de este mes. Lanzado y de código abierto en enero, K2.5 se posiciona como el modelo más vers
Recomendaciones de temas especiales relacionados
Productividad
 Las mejores herramientas de clasificación de correos electrónicos con IA para la productividad del equipo
¡Las mejores herramientas de clasificación de correos electrónicos con IA mejor valoradas de 2026 para la productividad de los equipos! XIX.AI selecciona una potente colección de herramientas revolucionarias que no te puedes perder y que ayudan a los equipos a clasificar rápidamente grandes volúmenes de correos electrónicos, mejorar la eficiencia a la hora de redactar y ahorrar innumerables horas cada semana. Nuestras rigurosas pruebas en condiciones reales y nuestras clasificaciones actualizadas te garantizan que encontrarás la herramienta perfecta para tu flujo de trabajo. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
 10 herramientas
 xix.ai
composicion musical
Los mejores asistentes de IA para componer canciones: crea letras, acordes y melodías
¡Ya están aquí, en XIX.AI, los mejores asistentes de composición musical con IA de 2026, los más valorados! Esta lista seleccionada incluye herramientas tremendamente eficaces que han superado pruebas en el mundo real para ofrecer letras, acordes y melodías de alta calidad sin esfuerzo. Consigue una comparación entre las versiones gratuitas y de pago para encontrar la que mejor se adapte a tus necesidades creativas. ¡Explora ahora mismo y descubre tu ventaja con la IA en la creación musical!
12 herramientas
xix.ai
automatización
Los mejores creadores de agentes de IA: diseña automatizaciones empresariales de varios pasos
Los mejores creadores de agentes de IA mejor valorados de 2026 para crear automatizaciones empresariales de varios pasos. Esta lista seleccionada incluye herramientas potentes y revolucionarias que se someten a rigurosas pruebas en el mundo real. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, clasificaciones exhaustivas e información actualizada semanalmente que te ayudarán a elegir la solución perfecta para aumentar significativamente tu productividad. ¡Explora ahora en XIX.AI para sacar el máximo partido a tu ventaja en IA!
11 herramientas
xix.ai
Productividad
Herramientas de planificación de tareas basadas en IA para profesionales con una agenda apretada
¡Las mejores herramientas de planificación de tareas con IA mejor valoradas de 2026 para profesionales ocupados! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias y altamente eficientes que ayudan a los usuarios a optimizar los flujos de trabajo, aumentar la productividad y superar los retos diarios de planificación. Cada opción se somete a rigurosas pruebas en condiciones reales para garantizar su fiabilidad. Consigue una comparación entre las versiones gratuitas y de pago y descubre la herramienta perfecta para sacar el máximo partido a la IA. ¡Explora ahora!
15 herramientas
xix.ai
chatbot
Principales chatbots de atención al cliente con IA: Responder preguntas frecuentes y calificar prospectos 24/7
2026 Últimas chatbots de atención al cliente con IA mejor valoradas destacadas en esta lista seleccionada son las mejores soluciones para responder instantáneamente a las preguntas frecuentes de los clientes y calificar prospectos las 24 horas del día. XIX.AI ha realizado pruebas rigurosas en el mundo real para ofrecer una comparación detallada entre versión gratuita y de pago junto con clasificaciones actualizadas, ayudándote a encontrar una poderosa herramienta que cambia las reglas del juego y aumenta significativamente la productividad. Explora ahora para descubrir tu solución perfecta de chatbot con IA!
9 herramientas
xix.ai
Diseño y Arte
Generadores de guiones gráficos basados en IA para equipos creativos publicitarios
¡Los mejores generadores de storyboards con IA de 2026 para equipos creativos publicitarios! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los equipos a crear contenidos visuales impresionantes más rápidamente, gracias a pruebas en el mundo real y a rigurosas clasificaciones que se actualizan semanalmente. Disfruta de una comparación entre las opciones gratuitas y las de pago para encontrar la que mejor se adapte a tu flujo de trabajo. ¡Explora ahora mismo para sacar el máximo partido a la IA en la creación publicitaria!
8 herramientas
xix.ai

 comentario (0)
0/500
NVIDIA ha lanzado el software Personal AI Router (PAIR) en una versión beta de código abierto, que funciona como un programador de red local que dirige las solicitudes de IA a los ordenadores disponibles.
Detección automática de dispositivos y asignación de solicitudes: ventajas directas para Ollama y LM Studio
En hardware compatible, como los Mac M4+, los PC con NVIDIA RTX y DGX Spark, PAIR ofrece una interfaz unificada para herramientas de IA locales como Ollama y LM Studio. Esto permite a los usuarios distribuir múltiples tareas de IA independientes entre los dispositivos inactivos de una red doméstica o de oficina.
Diseñado como un programador de solicitudes local, PAIR detecta automáticamente los ordenadores conectados y asigna tareas a los recursos disponibles. Dado que los modelos siguen ejecutándose a través de Ollama o LM Studio en el dispositivo de destino, los usuarios evitan tener que configurar cada máquina individualmente. Si un dispositivo está ocupado, PAIR redirige las solicitudes a otros nodos emparejados. Por ejemplo, los agentes de IA que procesan varios documentos pueden asignar tareas independientes a diferentes ordenadores. NVIDIA aclara que esto distribuye las cargas de trabajo simultáneas y no acelera las respuestas individuales de IA mediante la combinación de potencia de cálculo.
Prueba de rendimiento: la división de tareas reduce el tiempo de 18 minutos a 8 minutos y 48 segundos
La demostración de NVIDIA mostró que, al utilizar Ollama con el modelo Qwen 3.6 35B A3B en Hermes, la división de tareas entre cinco subagentes de IA redujo el tiempo medio de finalización para un único portátil RTX Spark de 18 minutos a 8 minutos y 48 segundos tras añadir un DGX Spark y una RTX 5090.








 La startup británica de inteligencia artificial Emulate inicia una ronda de financiación con un objetivo de hasta 700 millones de dólares y una valoración de 3.700 millones de dólares
El miércoles 16 de septiembre, la startup de inteligencia artificial con sede en el Reino Unido Emulate anunció una nueva ronda de financiación que busca hasta 700 millones de dólares, alcanzando una valoración posterior a la ronda de aproximadamente
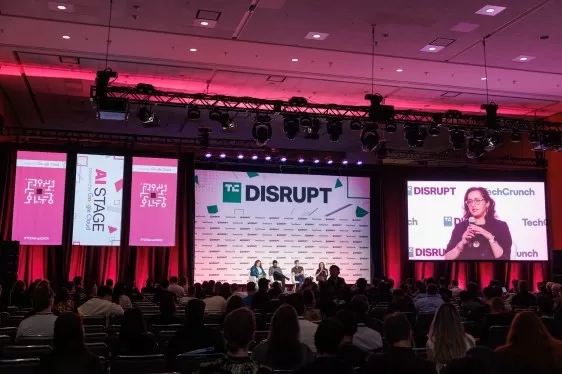 Los fundadores de empresas de IA debaten sobre modelos abiertos frente a modelos cerrados en TechCrunch Disrupt 2026
Para las startups de inteligencia artificial, seleccionar un modelo ya no es solo una decisión arquitectónica puntual.Los modelos abiertos están mejorando. Las APIs de vanguardia siguen perfeccionándose. Los modelos pueden adaptarse a tareas específi
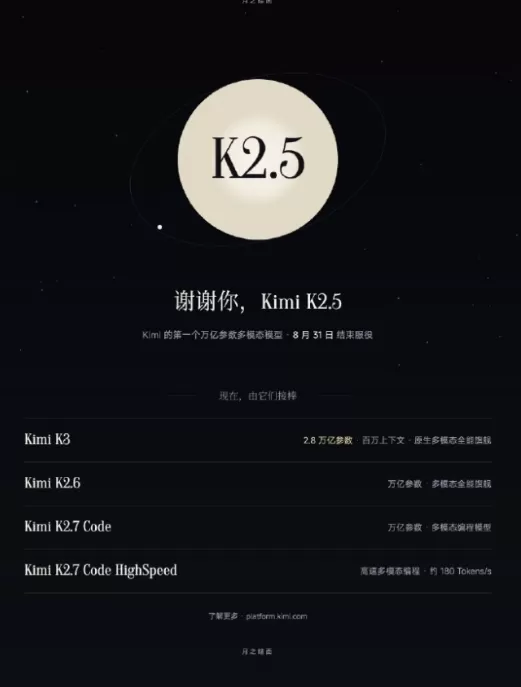 El Kimi K2.5 de Moonshot AI, el primer modelo multimodal con un billón de parámetros, se retira a finales de mes
Moonshot anunció a través de la cuenta oficial de Weibo de Kimi que su primer modelo multimodal de billones de parámetros, Kimi K2.5, será retirado a finales de este mes. Lanzado y de código abierto en enero, K2.5 se posiciona como el modelo más vers
¡Las mejores herramientas de clasificación de correos electrónicos con IA mejor valoradas de 2026 para la productividad de los equipos! XIX.AI selecciona una potente colección de herramientas revolucionarias que no te puedes perder y que ayudan a los equipos a clasificar rápidamente grandes volúmenes de correos electrónicos, mejorar la eficiencia a la hora de redactar y ahorrar innumerables horas cada semana. Nuestras rigurosas pruebas en condiciones reales y nuestras clasificaciones actualizadas te garantizan que encontrarás la herramienta perfecta para tu flujo de trabajo. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
10 herramientas
xix.ai
¡Ya están aquí, en XIX.AI, los mejores asistentes de composición musical con IA de 2026, los más valorados! Esta lista seleccionada incluye herramientas tremendamente eficaces que han superado pruebas en el mundo real para ofrecer letras, acordes y melodías de alta calidad sin esfuerzo. Consigue una comparación entre las versiones gratuitas y de pago para encontrar la que mejor se adapte a tus necesidades creativas. ¡Explora ahora mismo y descubre tu ventaja con la IA en la creación musical!
12 herramientas
xix.ai
Los mejores creadores de agentes de IA mejor valorados de 2026 para crear automatizaciones empresariales de varios pasos. Esta lista seleccionada incluye herramientas potentes y revolucionarias que se someten a rigurosas pruebas en el mundo real. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, clasificaciones exhaustivas e información actualizada semanalmente que te ayudarán a elegir la solución perfecta para aumentar significativamente tu productividad. ¡Explora ahora en XIX.AI para sacar el máximo partido a tu ventaja en IA!
11 herramientas
xix.ai
¡Las mejores herramientas de planificación de tareas con IA mejor valoradas de 2026 para profesionales ocupados! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias y altamente eficientes que ayudan a los usuarios a optimizar los flujos de trabajo, aumentar la productividad y superar los retos diarios de planificación. Cada opción se somete a rigurosas pruebas en condiciones reales para garantizar su fiabilidad. Consigue una comparación entre las versiones gratuitas y de pago y descubre la herramienta perfecta para sacar el máximo partido a la IA. ¡Explora ahora!
15 herramientas
xix.ai
2026 Últimas chatbots de atención al cliente con IA mejor valoradas destacadas en esta lista seleccionada son las mejores soluciones para responder instantáneamente a las preguntas frecuentes de los clientes y calificar prospectos las 24 horas del día. XIX.AI ha realizado pruebas rigurosas en el mundo real para ofrecer una comparación detallada entre versión gratuita y de pago junto con clasificaciones actualizadas, ayudándote a encontrar una poderosa herramienta que cambia las reglas del juego y aumenta significativamente la productividad. Explora ahora para descubrir tu solución perfecta de chatbot con IA!
9 herramientas
xix.ai
¡Los mejores generadores de storyboards con IA de 2026 para equipos creativos publicitarios! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los equipos a crear contenidos visuales impresionantes más rápidamente, gracias a pruebas en el mundo real y a rigurosas clasificaciones que se actualizan semanalmente. Disfruta de una comparación entre las opciones gratuitas y las de pago para encontrar la que mejor se adapte a tu flujo de trabajo. ¡Explora ahora mismo para sacar el máximo partido a la IA en la creación publicitaria!
8 herramientas
xix.ai












