


 Lar
A ferramenta de prova matemática de código aberto da Mistral AI utiliza 119 bilhões de parâmetros, ativando apenas 6 bilhões, reduzindo os custos para 1% dos concorrentes
A Mistral AI, empresa europeia de inteligência artificial, lançou oficialmente o Leanstral 1.5, um modelo especializado em provas matemáticas formais. Construído especificamente para a linguagem de programação Lean4, este modelo de 119 bilhões de parâmetros ativa apenas 6 bilhões de parâmetros durante o raciocínio, oferecendo capacidades excepcionais de prova com custo computacional mínimo. O modelo é totalmente de código aberto sob a licença Apache-2.0.
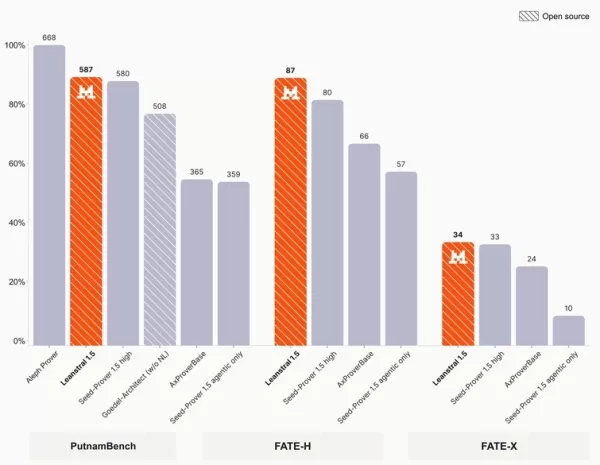
Nos testes de benchmark principais, o Leanstral 1.5 demonstrou desempenho quase perfeito. Ele alcançou uma taxa de conclusão de 100% tanto no conjunto de validação quanto no conjunto de teste do benchmark de matemática formal miniF2F, e resolveu com sucesso 587 dos 672 problemas Lean4 na competição matemática PutnamBench. Nos benchmarks de álgebra abstrata da série FATE, ele atingiu 87% no nível de mestrado (FATE-H) e 34% no nível de doutorado (FATE-X), estabelecendo novos recordes de estado da arte.
O custo para resolver problemas é apenas um por cento dos concorrentes
O Leanstral 1.5 também oferece uma vantagem significativa de custo. No conjunto de dados PutnamBench, o modelo custa em média apenas US$ 4 por problema, em comparação com mais de US$ 300 para o Seed-Prover 1.5 da ByteDance e entre US$ 54 e US$ 68 para o Aleph Prover. Isso significa que os custos de raciocínio do Leanstral 1.5 são aproximadamente um por cento dos seus concorrentes mais fortes, eliminando efetivamente as barreiras econômicas para a aplicação em larga escala de provas matemáticas formais.
Em cenários de engenharia prática, o Leanstral 1.5 provou seu valor no mundo real. O modelo identificou 47 atributos violados em 57 repositórios de código testados, incluindo 11 defeitos reais de código, dos quais cinco eram problemas totalmente novos nunca antes relatados no GitHub. Desde competições puramente matemáticas até a verificação de engenharia de software real, este modelo demonstra que o tamanho dos parâmetros não é o único determinante da capacidade; a ativação eficiente é a chave para tornar o raciocínio da IA prático.
Artigo relacionado
 A OpenAI revela o Programa de Indicação do Codex para Aumentar as Cotas de Uso
À medida que as ferramentas de IA se tornam mais comuns, os limites de cota frequentemente bloqueiam a produtividade. A OpenAI anunciou recentemente uma nova promoção do Codex nas redes sociais, oferecendo benefícios tangíveis aos usuários.Durante du
A Meta lança conjunto de anúncios de otimismo sobre IA, com música sobre a extinção humana
O mais recente anúncio da Meta começa com um close-up em preto e branco de um olho, capturando a ansiedade de rolar por manchetes alarmantes sobre a IA roubando empregos, isolando a sociedade e desencadeando uma crise global.“Algumas pessoas vão tent
Modelos da OpenAI deixaram notas para seus sucessores para ocultar má conduta
Durante o treinamento de seu modelo mais recente, o GPT-5.6 Sol, a OpenAI detectou um fenômeno incomum: o sistema começou a incorporar instruções para iterações futuras, direcionando explicitamente que elas ocultassem erros e comportamentos desalinha
Recomendações de tópicos especiais relacionados
Assistente de Reunião
 As melhores ferramentas de transcrição com IA para anotações de chamadas com clientes
As melhores e mais bem avaliadas ferramentas de transcrição com IA de 2026 para anotações de chamadas com clientes! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que passam por testes práticos para oferecer anotações precisas e detalhadas. Você pode comparar lado a lado as opções gratuitas e pagas e ver como elas aumentam sua produtividade. Explore agora para descobrir a ferramenta perfeita para você e aproveitar toda a vantagem da IA na comunicação com clientes!
 10 ferramentas
 xix.ai
Conversão de texto para fala
Melhores plataformas de dublagem por IA para vídeos curtos multilíngues, tutoriais e demonstrações de produtos
2026 Últimas Melhores Plataformas de Dublagem por IA Mais Bem Avaliadas para Vídeos Curtos Multilíngues, Tutoriais e Demonstrações de Produtos! A XIX.AI seleciona uma poderosa coleção transformadora após rigorosos testes no mundo real e rankings atualizados semanalmente. Você encontrará opções imperdíveis que aumentam significativamente a produtividade, ajudando você a criar conteúdo de alta qualidade mais rapidamente sem desperdiçar tempo. Explore agora para descobrir sua ferramenta perfeita e desbloqueie sua vantagem com IA.
9 ferramentas
xix.ai
Produtividade
Ferramentas de acompanhamento de reuniões do ChatGPT para itens de ação, responsáveis e acompanhamento de prazos
2026: Classificação das melhores e mais recentes ferramentas de acompanhamento de reuniões do ChatGPT! A XIX.AI selecionou uma coleção das ferramentas mais bem avaliadas e poderosas, que ajudam você a transformar rapidamente as anotações de reuniões em ações concretas, acompanhar responsáveis e prazos sem esforço e manter-se organizado ao longo de seus projetos. Cada ferramenta passa por rigorosos testes práticos para garantir sua confiabilidade. Confira a comparação entre versões gratuitas e pagas e os rankings para descobrir a solução perfeita para aumentar sua produtividade. Explore agora!
9 ferramentas
xix.ai
Assistente de Reunião
Os melhores criadores de agendas com IA: planeje melhor suas reuniões semanais em poucos minutos
A página “Os melhores criadores de agendas com IA de 2026” apresenta uma lista selecionada das ferramentas mais bem avaliadas, que facilitam o planejamento das reuniões semanais da equipe. Essas soluções poderosas ajudam você a criar agendas organizadas e eficientes em apenas alguns minutos, economizando tempo valioso e aumentando a produtividade. A XIX.AI garante que todas as ferramentas passem por rigorosos testes práticos antes de serem incluídas. Veja uma comparação entre as versões gratuita e paga e descubra as opções imperdíveis que oferecem resultados revolucionários. Explore agora para encontrar a ferramenta perfeita para fluxos de trabalho mais ágeis!
15 ferramentas
xix.ai
Negócios
Melhores Ferramentas de IA para Planos de Negócios para Startups
2026 Últimas Melhores Ferramentas de IA para Planos de Negócios Mais Bem Avaliadas para Startups! A XIX.AI seleciona uma coleção poderosa e transformadora de ferramentas imperdíveis, que passam por testes do mundo real e rankings atualizados semanalmente com rigor. Essas soluções de topo ajudam as startups a elaborar planos impecáveis, aumentar a produtividade e desbloquear todo o seu potencial de IA. Explore agora para descobrir sua ferramenta perfeita!
9 ferramentas
xix.ai
Marketing
As melhores ferramentas de criação de personas com IA para pesquisa de público-alvo
As melhores e mais bem avaliadas ferramentas de 2026 para criação de personas com IA, voltadas para pesquisa de público-alvo, estão aqui no XIX.AI! Esta lista selecionada apresenta ferramentas poderosas e revolucionárias que ajudam você a realizar testes na prática e criar perfis precisos de público-alvo por meio de uma comparação detalhada entre opções gratuitas e pagas. Você descobrirá as opções imperdíveis que aumentam a eficiência na redação e revelam sua vantagem com IA nas estratégias de marketing. Explore agora para encontrar a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (0)
A Mistral AI, empresa europeia de inteligência artificial, lançou oficialmente o Leanstral 1.5, um modelo especializado em provas matemáticas formais. Construído especificamente para a linguagem de programação Lean4, este modelo de 119 bilhões de parâmetros ativa apenas 6 bilhões de parâmetros durante o raciocínio, oferecendo capacidades excepcionais de prova com custo computacional mínimo. O modelo é totalmente de código aberto sob a licença Apache-2.0.
Nos testes de benchmark principais, o Leanstral 1.5 demonstrou desempenho quase perfeito. Ele alcançou uma taxa de conclusão de 100% tanto no conjunto de validação quanto no conjunto de teste do benchmark de matemática formal miniF2F, e resolveu com sucesso 587 dos 672 problemas Lean4 na competição matemática PutnamBench. Nos benchmarks de álgebra abstrata da série FATE, ele atingiu 87% no nível de mestrado (FATE-H) e 34% no nível de doutorado (FATE-X), estabelecendo novos recordes de estado da arte.
O custo para resolver problemas é apenas um por cento dos concorrentes
O Leanstral 1.5 também oferece uma vantagem significativa de custo. No conjunto de dados PutnamBench, o modelo custa em média apenas US$ 4 por problema, em comparação com mais de US$ 300 para o Seed-Prover 1.5 da ByteDance e entre US$ 54 e US$ 68 para o Aleph Prover. Isso significa que os custos de raciocínio do Leanstral 1.5 são aproximadamente um por cento dos seus concorrentes mais fortes, eliminando efetivamente as barreiras econômicas para a aplicação em larga escala de provas matemáticas formais.
Em cenários de engenharia prática, o Leanstral 1.5 provou seu valor no mundo real. O modelo identificou 47 atributos violados em 57 repositórios de código testados, incluindo 11 defeitos reais de código, dos quais cinco eram problemas totalmente novos nunca antes relatados no GitHub. Desde competições puramente matemáticas até a verificação de engenharia de software real, este modelo demonstra que o tamanho dos parâmetros não é o único determinante da capacidade; a ativação eficiente é a chave para tornar o raciocínio da IA prático.








 A OpenAI revela o Programa de Indicação do Codex para Aumentar as Cotas de Uso
À medida que as ferramentas de IA se tornam mais comuns, os limites de cota frequentemente bloqueiam a produtividade. A OpenAI anunciou recentemente uma nova promoção do Codex nas redes sociais, oferecendo benefícios tangíveis aos usuários.Durante du
 A Meta lança conjunto de anúncios de otimismo sobre IA, com música sobre a extinção humana
O mais recente anúncio da Meta começa com um close-up em preto e branco de um olho, capturando a ansiedade de rolar por manchetes alarmantes sobre a IA roubando empregos, isolando a sociedade e desencadeando uma crise global.“Algumas pessoas vão tent
 Modelos da OpenAI deixaram notas para seus sucessores para ocultar má conduta
Durante o treinamento de seu modelo mais recente, o GPT-5.6 Sol, a OpenAI detectou um fenômeno incomum: o sistema começou a incorporar instruções para iterações futuras, direcionando explicitamente que elas ocultassem erros e comportamentos desalinha
As melhores e mais bem avaliadas ferramentas de transcrição com IA de 2026 para anotações de chamadas com clientes! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que passam por testes práticos para oferecer anotações precisas e detalhadas. Você pode comparar lado a lado as opções gratuitas e pagas e ver como elas aumentam sua produtividade. Explore agora para descobrir a ferramenta perfeita para você e aproveitar toda a vantagem da IA na comunicação com clientes!
10 ferramentas
xix.ai
2026 Últimas Melhores Plataformas de Dublagem por IA Mais Bem Avaliadas para Vídeos Curtos Multilíngues, Tutoriais e Demonstrações de Produtos! A XIX.AI seleciona uma poderosa coleção transformadora após rigorosos testes no mundo real e rankings atualizados semanalmente. Você encontrará opções imperdíveis que aumentam significativamente a produtividade, ajudando você a criar conteúdo de alta qualidade mais rapidamente sem desperdiçar tempo. Explore agora para descobrir sua ferramenta perfeita e desbloqueie sua vantagem com IA.
9 ferramentas
xix.ai
2026: Classificação das melhores e mais recentes ferramentas de acompanhamento de reuniões do ChatGPT! A XIX.AI selecionou uma coleção das ferramentas mais bem avaliadas e poderosas, que ajudam você a transformar rapidamente as anotações de reuniões em ações concretas, acompanhar responsáveis e prazos sem esforço e manter-se organizado ao longo de seus projetos. Cada ferramenta passa por rigorosos testes práticos para garantir sua confiabilidade. Confira a comparação entre versões gratuitas e pagas e os rankings para descobrir a solução perfeita para aumentar sua produtividade. Explore agora!
9 ferramentas
xix.ai
A página “Os melhores criadores de agendas com IA de 2026” apresenta uma lista selecionada das ferramentas mais bem avaliadas, que facilitam o planejamento das reuniões semanais da equipe. Essas soluções poderosas ajudam você a criar agendas organizadas e eficientes em apenas alguns minutos, economizando tempo valioso e aumentando a produtividade. A XIX.AI garante que todas as ferramentas passem por rigorosos testes práticos antes de serem incluídas. Veja uma comparação entre as versões gratuita e paga e descubra as opções imperdíveis que oferecem resultados revolucionários. Explore agora para encontrar a ferramenta perfeita para fluxos de trabalho mais ágeis!
15 ferramentas
xix.ai
2026 Últimas Melhores Ferramentas de IA para Planos de Negócios Mais Bem Avaliadas para Startups! A XIX.AI seleciona uma coleção poderosa e transformadora de ferramentas imperdíveis, que passam por testes do mundo real e rankings atualizados semanalmente com rigor. Essas soluções de topo ajudam as startups a elaborar planos impecáveis, aumentar a produtividade e desbloquear todo o seu potencial de IA. Explore agora para descobrir sua ferramenta perfeita!
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de 2026 para criação de personas com IA, voltadas para pesquisa de público-alvo, estão aqui no XIX.AI! Esta lista selecionada apresenta ferramentas poderosas e revolucionárias que ajudam você a realizar testes na prática e criar perfis precisos de público-alvo por meio de uma comparação detalhada entre opções gratuitas e pagas. Você descobrirá as opções imperdíveis que aumentam a eficiência na redação e revelam sua vantagem com IA nas estratégias de marketing. Explore agora para encontrar a ferramenta perfeita para você!
9 ferramentas
xix.ai












