


 Lar
É apresentado o modelo de geração de vídeo Douba Seedance 2.5; lançamento oficial previsto para o início de julho
Durante a Conferência ByteDance Engine FORCE Original Power 2026, que terminou recentemente, foi anunciado um grande avanço nos modelos de grande escala para geração de vídeo. A Douyin, subsidiária da ByteDance, revelou o modelo de geração de vídeo Seedance2.5, agora disponível para testes beta corporativos em todo o mundo, com lançamento oficial previsto para o início de julho.
Com essa atualização, o Seedance2.5 oferece desempenho líder do setor em várias métricas-chave. Sua conquista mais notável é a duração dos vídeos gerados: vídeos individuais agora podem chegar a até 30 segundos, a maior duração do mundo. Enquanto os modelos de vídeo atuais costumam ser limitados a um teto criativo de 15 a 20 segundos, o Seedance2.5 não apenas aprimora a continuidade da expressão das cenas, mas também possibilita a produção de curtas-metragens narrativos de longa duração.
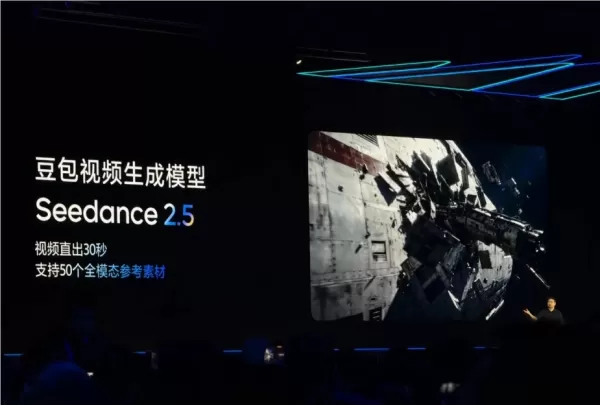
Para maior flexibilidade criativa, o Seedance 2.5 introduz um processamento multimodal de materiais altamente competitivo, suportando até 50 materiais multimodais para entrada conjunta. Os criadores podem importar recursos de imagem de vários atores simultaneamente, e o modelo lida automaticamente com o arranjo e o agendamento, simplificando significativamente o fluxo de trabalho, desde a matéria-prima até a saída final. Além disso, o modelo oferece um recurso de “redesenho local” que permite ajustes localizados — como alterar fundos, substituir produtos ou trocar modelos — sem afetar a imagem como um todo. Durante as demonstrações, esse recurso resolveu com eficácia cenários comuns e complexos de substituição em publicidade de comércio eletrônico.
Além do modelo de vídeo, o ByteDance Engine também apresentou o modelo de criação de imagens Seedream5.0Pro e o modelo de geração de áudio Seed-Audio1.0. O primeiro se destaca na edição interativa e precisa, no design em camadas e na geração nativa de texto, permitindo a produção direta de esboços de design editáveis. O último apresenta recursos de referência multimodal “zero-shot”, suportando a geração simultânea de diálogos vívidos para vários personagens, música de fundo e efeitos sonoros.
Com uma abordagem abrangente que engloba vídeo, imagem e áudio, os modelos da série Douyin estão consolidando ainda mais sua liderança tecnológica no campo da IA generativa por meio de uma profunda colaboração multimodal. Como essas ferramentas devem ser lançadas oficialmente no início de julho, a eficiência de produção do setor de criação de vídeos poderá sofrer mais uma aceleração.
Artigo relacionado
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m
Recomendações de tópicos especiais relacionados
escrita
 Ferramentas de IA para esboço de artigos em formato longo
2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
 9 ferramentas
 xix.ai
chatbot
Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

 Comentários (0)
Durante a Conferência ByteDance Engine FORCE Original Power 2026, que terminou recentemente, foi anunciado um grande avanço nos modelos de grande escala para geração de vídeo. A Douyin, subsidiária da ByteDance, revelou o modelo de geração de vídeo Seedance2.5, agora disponível para testes beta corporativos em todo o mundo, com lançamento oficial previsto para o início de julho.
Com essa atualização, o Seedance2.5 oferece desempenho líder do setor em várias métricas-chave. Sua conquista mais notável é a duração dos vídeos gerados: vídeos individuais agora podem chegar a até 30 segundos, a maior duração do mundo. Enquanto os modelos de vídeo atuais costumam ser limitados a um teto criativo de 15 a 20 segundos, o Seedance2.5 não apenas aprimora a continuidade da expressão das cenas, mas também possibilita a produção de curtas-metragens narrativos de longa duração.
Para maior flexibilidade criativa, o Seedance 2.5 introduz um processamento multimodal de materiais altamente competitivo, suportando até 50 materiais multimodais para entrada conjunta. Os criadores podem importar recursos de imagem de vários atores simultaneamente, e o modelo lida automaticamente com o arranjo e o agendamento, simplificando significativamente o fluxo de trabalho, desde a matéria-prima até a saída final. Além disso, o modelo oferece um recurso de “redesenho local” que permite ajustes localizados — como alterar fundos, substituir produtos ou trocar modelos — sem afetar a imagem como um todo. Durante as demonstrações, esse recurso resolveu com eficácia cenários comuns e complexos de substituição em publicidade de comércio eletrônico.
Além do modelo de vídeo, o ByteDance Engine também apresentou o modelo de criação de imagens Seedream5.0Pro e o modelo de geração de áudio Seed-Audio1.0. O primeiro se destaca na edição interativa e precisa, no design em camadas e na geração nativa de texto, permitindo a produção direta de esboços de design editáveis. O último apresenta recursos de referência multimodal “zero-shot”, suportando a geração simultânea de diálogos vívidos para vários personagens, música de fundo e efeitos sonoros.
Com uma abordagem abrangente que engloba vídeo, imagem e áudio, os modelos da série Douyin estão consolidando ainda mais sua liderança tecnológica no campo da IA generativa por meio de uma profunda colaboração multimodal. Como essas ferramentas devem ser lançadas oficialmente no início de julho, a eficiência de produção do setor de criação de vídeos poderá sofrer mais uma aceleração.








 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m

2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai












