


 Hogar
Se presenta el modelo de generación de vídeo Douba Seedance 2.5; su lanzamiento oficial está previsto para principios de julio
Durante la conferencia «ByteDance Engine FORCE Original Power 2026», que acaba de concluir, se anunció un importante avance en los modelos a gran escala de generación de vídeo. La filial de ByteDance, Douyin, presentó el modelo de generación de vídeo Seedance 2.5, que ya está disponible para pruebas beta a nivel mundial para empresas, y cuyo lanzamiento oficial está previsto para principios de julio.
Con esta actualización, Seedance2.5 ofrece un rendimiento líder en el sector en varios parámetros clave. Su logro más destacado es la duración de los vídeos generados: ahora, un solo vídeo puede alcanzar hasta 30 segundos, la mayor duración a nivel mundial. Mientras que los modelos de vídeo actuales suelen estar limitados a una duración máxima de entre 15 y 20 segundos, Seedance2.5 no solo mejora la continuidad de la expresión de las escenas, sino que también permite la creación de cortometrajes narrativos de larga duración.
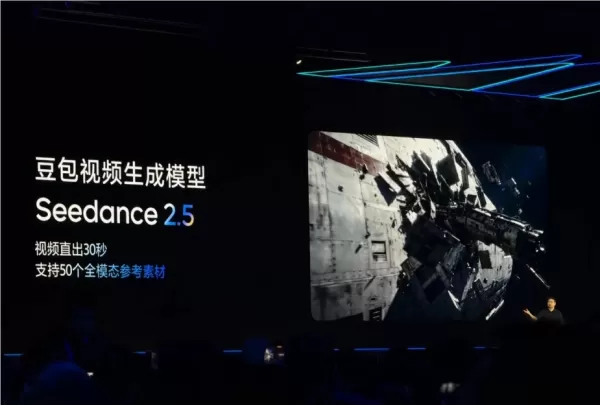
En cuanto a la flexibilidad creativa, Seedance 2.5 introduce un procesamiento multimodal de materiales altamente competitivo, que admite hasta 50 materiales de todos los modos para su entrada conjunta. Los creadores pueden importar recursos de imagen de varios actores simultáneamente, y el modelo se encarga automáticamente de la disposición y la planificación, lo que agiliza enormemente el flujo de trabajo desde los materiales en bruto hasta el resultado final. Además, el modelo ofrece una función de «redibujado local» que permite realizar ajustes localizados —como cambiar fondos, sustituir productos o cambiar de modelos— sin afectar a la imagen en su conjunto. Durante las demostraciones, esta función resolvió con eficacia situaciones comunes y complejas de sustitución en la publicidad del comercio electrónico.
Más allá del modelo de vídeo, ByteDance Engine también presentó el modelo de creación de imágenes Seedream5.0Pro y el modelo de generación de audio Seed-Audio1.0. El primero destaca por su edición interactiva y precisa, su diseño por capas y la generación nativa de texto, lo que permite la producción directa de bocetos de diseño editables. Este último cuenta con capacidades de referencia multimodal «zero-shot», que permiten la generación simultánea de diálogos vívidos para múltiples personajes, música de fondo y efectos de sonido.
Con una oferta integral que abarca vídeo, imagen y audio, los modelos de la serie Douyin están consolidando aún más su liderazgo tecnológico en el ámbito de la IA generativa a través de una profunda colaboración multimodal. Dado que el lanzamiento oficial de estas herramientas está previsto para principios de julio, la eficiencia productiva del sector de la creación de vídeos podría experimentar una nueva aceleración.
Artículo relacionado
 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz
Recomendaciones de temas especiales relacionados
composicion musical
 Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
 8 herramientas
 xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
Creación de cómics
Las mejores herramientas de burbujas de diálogo con IA para la narración visual
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai

 comentario (0)
0/500
Durante la conferencia «ByteDance Engine FORCE Original Power 2026», que acaba de concluir, se anunció un importante avance en los modelos a gran escala de generación de vídeo. La filial de ByteDance, Douyin, presentó el modelo de generación de vídeo Seedance 2.5, que ya está disponible para pruebas beta a nivel mundial para empresas, y cuyo lanzamiento oficial está previsto para principios de julio.
Con esta actualización, Seedance2.5 ofrece un rendimiento líder en el sector en varios parámetros clave. Su logro más destacado es la duración de los vídeos generados: ahora, un solo vídeo puede alcanzar hasta 30 segundos, la mayor duración a nivel mundial. Mientras que los modelos de vídeo actuales suelen estar limitados a una duración máxima de entre 15 y 20 segundos, Seedance2.5 no solo mejora la continuidad de la expresión de las escenas, sino que también permite la creación de cortometrajes narrativos de larga duración.
En cuanto a la flexibilidad creativa, Seedance 2.5 introduce un procesamiento multimodal de materiales altamente competitivo, que admite hasta 50 materiales de todos los modos para su entrada conjunta. Los creadores pueden importar recursos de imagen de varios actores simultáneamente, y el modelo se encarga automáticamente de la disposición y la planificación, lo que agiliza enormemente el flujo de trabajo desde los materiales en bruto hasta el resultado final. Además, el modelo ofrece una función de «redibujado local» que permite realizar ajustes localizados —como cambiar fondos, sustituir productos o cambiar de modelos— sin afectar a la imagen en su conjunto. Durante las demostraciones, esta función resolvió con eficacia situaciones comunes y complejas de sustitución en la publicidad del comercio electrónico.
Más allá del modelo de vídeo, ByteDance Engine también presentó el modelo de creación de imágenes Seedream5.0Pro y el modelo de generación de audio Seed-Audio1.0. El primero destaca por su edición interactiva y precisa, su diseño por capas y la generación nativa de texto, lo que permite la producción directa de bocetos de diseño editables. Este último cuenta con capacidades de referencia multimodal «zero-shot», que permiten la generación simultánea de diálogos vívidos para múltiples personajes, música de fondo y efectos de sonido.
Con una oferta integral que abarca vídeo, imagen y audio, los modelos de la serie Douyin están consolidando aún más su liderazgo tecnológico en el ámbito de la IA generativa a través de una profunda colaboración multimodal. Dado que el lanzamiento oficial de estas herramientas está previsto para principios de julio, la eficiencia productiva del sector de la creación de vídeos podría experimentar una nueva aceleración.








 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
 OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai












