


 家
学術チームがSFTでテック大手による独占を打破、OpenSeeker-v2が検索エージェントランキングで首位に
大規模言語モデル(LLM)の進化する状況において、ディープサーチ機能は高度なインテリジェントエージェントにとって決定的な優位性となっています。しかし、この分野は長きにわたり、豊富な資金力を持つ業界大手企業によって支配されてきました。 従来の開発アプローチは、通常、事前学習、継続的事前学習(CPT)、教師あり微調整(SFT)、強化学習(RL)を含む、リソースを大量に消費するパイプラインに依存している。
最近、ある学術研究者チームが最新の研究成果「OpenSeeker-v2」を発表し、この定説に根本的な挑戦を突きつけた。彼らの報告によると、高品質かつ難易度の高いタスクの軌跡を用いたトレーニングを行うことで、単純な教師あり微調整(SFT)アプローチであっても、トップクラスの検索エージェントを生み出すことが可能になるという。
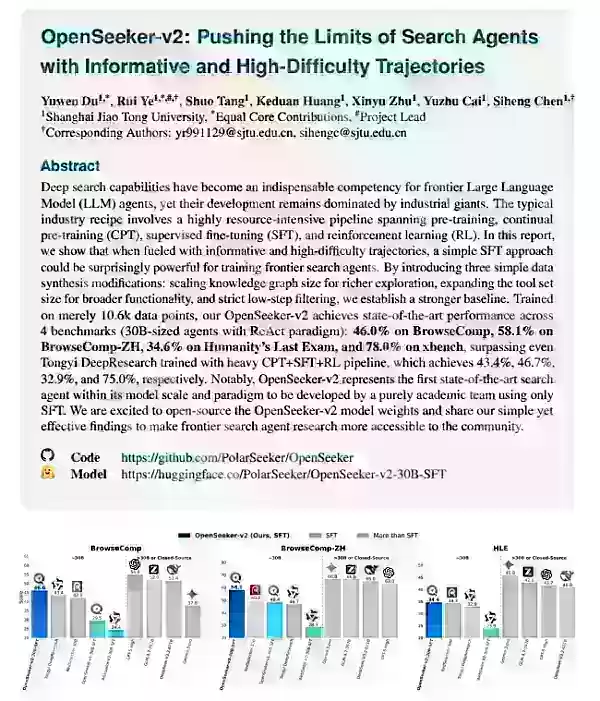
同チームは、データ合成に関する3つの主要な最適化戦略を提示した。第一に、ナレッジグラフを拡張して探索空間を広げる。第二に、ツールキットのレパートリーを大幅に拡充して機能的な限界を押し広げる。そして最後に、トレーニングデータの品質と効率を保証するために、厳格な低ステップフィルタリングを適用することである。
実験結果によると、わずか10,600個のデータポイントで学習されたOpenSeeker-v2(パラメータ数30B、ReActアーキテクチャ)は、4つの主要ベンチマークすべてにおいて圧倒的な性能を発揮した。BrowseCompで46.0%、BrowseComp-ZHで58.1%、 「Humanity’s Last Exam」で34.6%、xbenchで78.0%を記録した。これらの数値は新記録を樹立しただけでなく、CPT、SFT、RLを組み合わせた重厚なパイプラインに依存するTongyi DeepResearchなどの業界モデルを全面的に上回った。
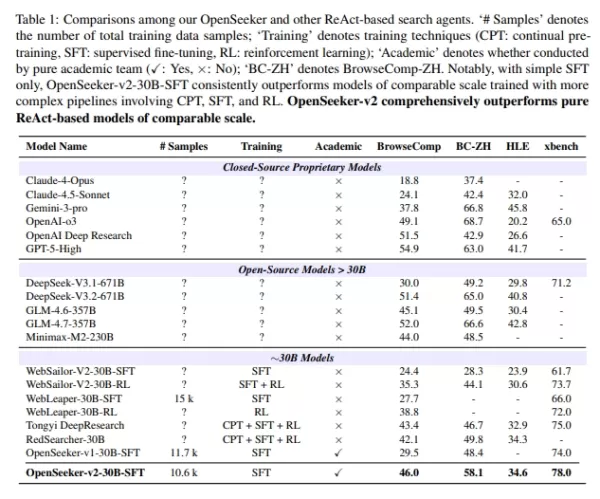
特筆すべきは、これが同じモデル規模とアーキテクチャにおいて、SFTのみを用いて完全に学術チームによって開発された初の最先端(SOTA)検索エージェントであるという点だ。 同チームは現在、OpenSeeker-v2のモデル重みをオープンソース化しています。この画期的な成果により、高度な検索エージェントの研究開発のハードルが大幅に下がり、学術界およびオープンソースコミュニティの両方にとって、より利用しやすく軽量な開発経路が提供されます。
論文:https://arxiv.org/pdf/2605.04036
関連記事
 ユーザーからの反発を受け、MetaはAI写真編集機能を削除
Meta、ソーシャルメディアの巨人は、人工知能とユーザープライバシーの微妙なバランスをめぐる公的な論争に再び巻き込まれている。TechCrunch によると、Meta の Superintelligence Labs は今週初めに新しい AI 画像ジェネレーター「Muse Image」を導入した。しかし、ユーザーが「@」記号でタグ付けすることで、公開されている Instagram アカウントから画像を修正・生成できるという、高い評価を受けた主要機能は、適切な通知メカニズムの欠如により、ユーザー
DeepMindのCEOハサビス氏:1日6時間睡眠し、通常午前1時頃に活力を感じます。
フォーチュンは最近、Google DeepMindのCEOであるデミス・ハサビスへのインタビューを掲載し、彼の休息と生産性に対する非伝統的なアプローチを明らかにした。ハサビスは、睡眠時間が非常に短いことを明かし、覚醒時間を2つの明確な作業ブロックに構造化していると語った。彼の睡眠習慣について、ハサビスは「6時間の睡眠を目標としているが、私の習慣は典型的ではない。一日中効果的に機能できる」と述べた。彼は、6時間未満の睡眠は脳の健康に悪影響を及ぼすことを強調した。2010年にDeepMindを共
OpenAIとAnthropic、収益の伸び悩みにもかかわらず市場シェア争いを繰り広げる
OpenAIが収益目標を達成できなかったとする最近の報道を受け、今週火曜日にハイテク株に売り圧力が生じたにもかかわらず、AI研究機関への民間投資家は依然として堅調だ。経験豊富な出資者たちは、メディアによる否定的な報道にもかかわらず、投資額を減らすつもりはないことを明らかにしている。アナリストらは、現在のAI競争はまだ初期段階にあると見ており、「勝者総取り」という結末はあり得ないと見ている。高いコン
関連特集おすすめ
アニメーション制作
 ソーシャルメディア向けコンテンツ用のAIシーンアニメーションツール
XIX.AIが厳選した、2026年のソーシャルメディア向けコンテンツ制作に最適なAIシーンアニメーションツールをここに紹介します。これらの画期的なツールは、実環境でのテスト結果や無料版と有料版の詳細な比較情報を提供しており、クリエイターの生産性を大幅に向上させるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう。
 9 ツール
 xix.ai
動画作成
Reels、Shorts、および製品ローンチキャンペーン向けのAIショート動画フック生成ツール
2026年最新!ReelsやShorts、製品ローンチキャンペーンに最適なAIショート動画フック生成ツール!XIX.AIは、実地テストを通じて「必ず試すべき」結果をもたらす、高評価で画期的なツールを厳選しています。毎週更新されるこのページでは、無料版と有料版の比較ランキングを掲載しており、コンテンツの創造性と生産性を高める最適なソリューションを見つけるお手伝いをします。 今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai
書き込み
長文執筆のためのAI記事構成ツール
2026年最新・最高評価のAIアウトラインツール:長文執筆に最適!この厳選コレクションには、執筆効率を大幅に向上させる、実証済みのテストを経て正確かつ構造化されたアウトラインを生成する、強力で画期的なツールが紹介されています。XIX.AIもこの厳選されたツールの一つです。 無料版と有料版の比較表を入手して、最適なツールの選択に役立ててください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
チャットボット
言語練習、面接対策、そして日常の流暢さのための最高のAIロールプレイチャットアプリ
2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai
作曲
リミックス制作、サンプリングの準備、カラオケマスター作成のためのAIステム分離ツール
2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
データ分析
収益ダッシュボード、ファネル分析、および製品指標向けのAI SQLコピロット
2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai

 コメント (0)
0/500
大規模言語モデル(LLM)の進化する状況において、ディープサーチ機能は高度なインテリジェントエージェントにとって決定的な優位性となっています。しかし、この分野は長きにわたり、豊富な資金力を持つ業界大手企業によって支配されてきました。 従来の開発アプローチは、通常、事前学習、継続的事前学習(CPT)、教師あり微調整(SFT)、強化学習(RL)を含む、リソースを大量に消費するパイプラインに依存している。
最近、ある学術研究者チームが最新の研究成果「OpenSeeker-v2」を発表し、この定説に根本的な挑戦を突きつけた。彼らの報告によると、高品質かつ難易度の高いタスクの軌跡を用いたトレーニングを行うことで、単純な教師あり微調整(SFT)アプローチであっても、トップクラスの検索エージェントを生み出すことが可能になるという。
同チームは、データ合成に関する3つの主要な最適化戦略を提示した。第一に、ナレッジグラフを拡張して探索空間を広げる。第二に、ツールキットのレパートリーを大幅に拡充して機能的な限界を押し広げる。そして最後に、トレーニングデータの品質と効率を保証するために、厳格な低ステップフィルタリングを適用することである。
実験結果によると、わずか10,600個のデータポイントで学習されたOpenSeeker-v2(パラメータ数30B、ReActアーキテクチャ)は、4つの主要ベンチマークすべてにおいて圧倒的な性能を発揮した。BrowseCompで46.0%、BrowseComp-ZHで58.1%、 「Humanity’s Last Exam」で34.6%、xbenchで78.0%を記録した。これらの数値は新記録を樹立しただけでなく、CPT、SFT、RLを組み合わせた重厚なパイプラインに依存するTongyi DeepResearchなどの業界モデルを全面的に上回った。
特筆すべきは、これが同じモデル規模とアーキテクチャにおいて、SFTのみを用いて完全に学術チームによって開発された初の最先端(SOTA)検索エージェントであるという点だ。 同チームは現在、OpenSeeker-v2のモデル重みをオープンソース化しています。この画期的な成果により、高度な検索エージェントの研究開発のハードルが大幅に下がり、学術界およびオープンソースコミュニティの両方にとって、より利用しやすく軽量な開発経路が提供されます。
論文:https://arxiv.org/pdf/2605.04036








 ユーザーからの反発を受け、MetaはAI写真編集機能を削除
Meta、ソーシャルメディアの巨人は、人工知能とユーザープライバシーの微妙なバランスをめぐる公的な論争に再び巻き込まれている。TechCrunch によると、Meta の Superintelligence Labs は今週初めに新しい AI 画像ジェネレーター「Muse Image」を導入した。しかし、ユーザーが「@」記号でタグ付けすることで、公開されている Instagram アカウントから画像を修正・生成できるという、高い評価を受けた主要機能は、適切な通知メカニズムの欠如により、ユーザー
 DeepMindのCEOハサビス氏:1日6時間睡眠し、通常午前1時頃に活力を感じます。
フォーチュンは最近、Google DeepMindのCEOであるデミス・ハサビスへのインタビューを掲載し、彼の休息と生産性に対する非伝統的なアプローチを明らかにした。ハサビスは、睡眠時間が非常に短いことを明かし、覚醒時間を2つの明確な作業ブロックに構造化していると語った。彼の睡眠習慣について、ハサビスは「6時間の睡眠を目標としているが、私の習慣は典型的ではない。一日中効果的に機能できる」と述べた。彼は、6時間未満の睡眠は脳の健康に悪影響を及ぼすことを強調した。2010年にDeepMindを共
 OpenAIとAnthropic、収益の伸び悩みにもかかわらず市場シェア争いを繰り広げる
OpenAIが収益目標を達成できなかったとする最近の報道を受け、今週火曜日にハイテク株に売り圧力が生じたにもかかわらず、AI研究機関への民間投資家は依然として堅調だ。経験豊富な出資者たちは、メディアによる否定的な報道にもかかわらず、投資額を減らすつもりはないことを明らかにしている。アナリストらは、現在のAI競争はまだ初期段階にあると見ており、「勝者総取り」という結末はあり得ないと見ている。高いコン

XIX.AIが厳選した、2026年のソーシャルメディア向けコンテンツ制作に最適なAIシーンアニメーションツールをここに紹介します。これらの画期的なツールは、実環境でのテスト結果や無料版と有料版の詳細な比較情報を提供しており、クリエイターの生産性を大幅に向上させるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう。
9 ツール
xix.ai

2026年最新!ReelsやShorts、製品ローンチキャンペーンに最適なAIショート動画フック生成ツール!XIX.AIは、実地テストを通じて「必ず試すべき」結果をもたらす、高評価で画期的なツールを厳選しています。毎週更新されるこのページでは、無料版と有料版の比較ランキングを掲載しており、コンテンツの創造性と生産性を高める最適なソリューションを見つけるお手伝いをします。 今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

2026年最新・最高評価のAIアウトラインツール:長文執筆に最適!この厳選コレクションには、執筆効率を大幅に向上させる、実証済みのテストを経て正確かつ構造化されたアウトラインを生成する、強力で画期的なツールが紹介されています。XIX.AIもこの厳選されたツールの一つです。 無料版と有料版の比較表を入手して、最適なツールの選択に役立ててください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai

2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai












