


 Heim
Forschungsteam beendet mit SFT das Monopol der Tech-Giganten; OpenSeeker-v2 führt die Rangliste der Suchagenten an
In der sich ständig weiterentwickelnden Landschaft der großen Sprachmodelle (LLMs) sind Deep-Search-Fähigkeiten zum entscheidenden Vorteil für fortschrittliche intelligente Agenten geworden. Doch dieser Bereich wird seit langem von finanzstarken Branchenriesen beherrscht. Herkömmliche Entwicklungsansätze stützen sich in der Regel auf ressourcenintensive Pipelines, die Vortraining, fortgesetztes Vortraining (CPT), überwachtes Feintuning (SFT) und bestärkendes Lernen (RL) umfassen.
Ein Team aus akademischen Forschern hat kürzlich seine neueste Arbeit, OpenSeeker-v2, vorgestellt, die diese etablierte Sichtweise grundlegend in Frage stellt. Laut ihrem Bericht ermöglicht das Training anhand hochwertiger, hochkomplexer Aufgabenabläufe, dass selbst ein einfacher Ansatz des überwachten Feinabgleichs (SFT) einen Suchagenten der Spitzenklasse hervorbringt.
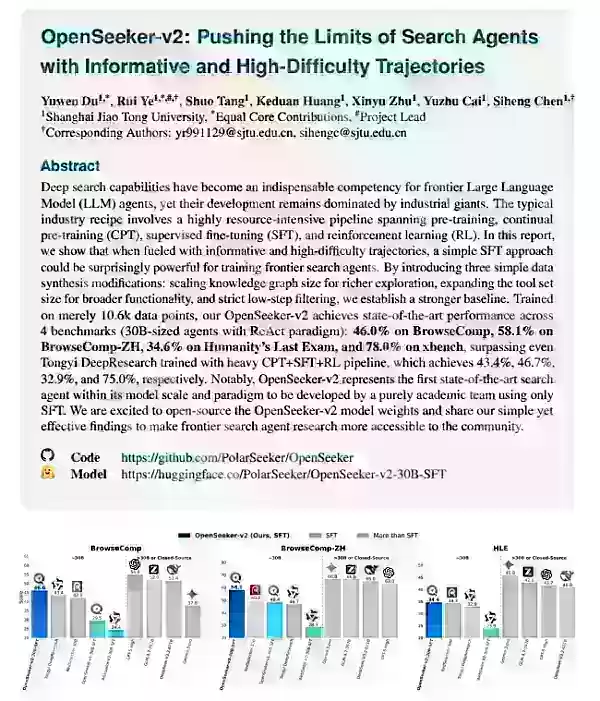
Das Team skizzierte drei zentrale Optimierungsstrategien für die Datensynthese: erstens die Erweiterung des Wissensgraphen, um einen breiteren Erkundungsraum zu schaffen; zweitens die erhebliche Erweiterung des Werkzeugrepertoires, um funktionale Grenzen zu verschieben; und schließlich die Anwendung einer strengen Low-Step-Filterung, um die Qualität und Effizienz der Trainingsdaten zu gewährleisten.
Die experimentellen Ergebnisse zeigen, dass OpenSeeker-v2 (mit 30 Milliarden Parametern und einer ReAct-Architektur), das auf lediglich 10.600 Datenpunkten trainiert wurde, bei vier zentralen Benchmarks eine überragende Leistung zeigte: Es erzielte 46,0 % bei BrowseComp, 58,1 % bei BrowseComp-ZH, 34,6 % bei „Humanity’s Last Exam“ und 78,0 % bei xbench. Diese Zahlen stellen nicht nur neue Rekorde auf, sondern übertreffen auch umfassend Branchenmodelle, die auf aufwendigen Pipelines basieren, welche CPT, SFT und RL kombinieren – wie beispielsweise Tongyi DeepResearch.
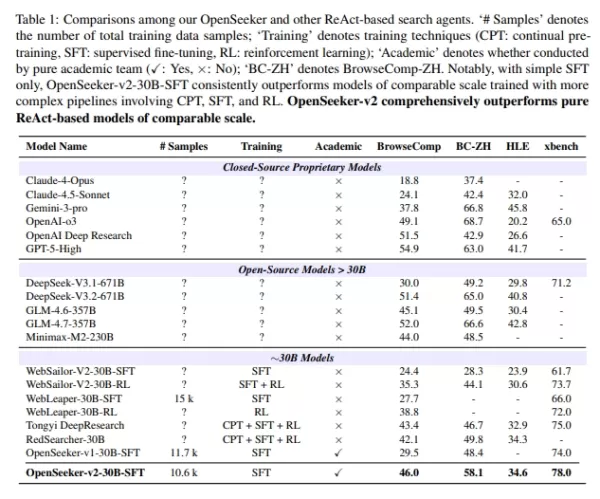
Bemerkenswert ist, dass dies der erste State-of-the-Art-Suchagent (SOTA) ist, der von einem rein akademischen Team ausschließlich unter Verwendung von SFT bei gleicher Modellgröße und Architektur entwickelt wurde. Das Team hat nun die Modellgewichte für OpenSeeker-v2 als Open Source veröffentlicht. Dieser Durchbruch senkt die Forschungs- und Entwicklungshürden für fortschrittliche Suchagenten erheblich und bietet sowohl der akademischen als auch der Open-Source-Community einen leichter zugänglichen, ressourcenschonenden Entwicklungsweg.
Artikel: https://arxiv.org/pdf/2605.04036
Verwandter Artikel
 Meta entfernt KI-Fotobearbeitungsfunktion nach Nutzerprotesten
Meta, der Social-Media-Riese, ist erneut in eine öffentliche Debatte über die heikle Balance zwischen künstlicher Intelligenz und dem Schutz der Privatsphäre der Nutzer verwickelt. Laut TechCrunch hat Meta’s Superintelligence Labs diese Woche einen n
DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Empfehlungen zu verwandten Spezialthemen
Videoerstellung
 KI-Generatoren für ansprechende Kurzvideos für Reels, Shorts und Produkteinführungskampagnen
Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
 11 Tools
 xix.ai
Schreiben
KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

 Kommentare (0)
In der sich ständig weiterentwickelnden Landschaft der großen Sprachmodelle (LLMs) sind Deep-Search-Fähigkeiten zum entscheidenden Vorteil für fortschrittliche intelligente Agenten geworden. Doch dieser Bereich wird seit langem von finanzstarken Branchenriesen beherrscht. Herkömmliche Entwicklungsansätze stützen sich in der Regel auf ressourcenintensive Pipelines, die Vortraining, fortgesetztes Vortraining (CPT), überwachtes Feintuning (SFT) und bestärkendes Lernen (RL) umfassen.
Ein Team aus akademischen Forschern hat kürzlich seine neueste Arbeit, OpenSeeker-v2, vorgestellt, die diese etablierte Sichtweise grundlegend in Frage stellt. Laut ihrem Bericht ermöglicht das Training anhand hochwertiger, hochkomplexer Aufgabenabläufe, dass selbst ein einfacher Ansatz des überwachten Feinabgleichs (SFT) einen Suchagenten der Spitzenklasse hervorbringt.
Das Team skizzierte drei zentrale Optimierungsstrategien für die Datensynthese: erstens die Erweiterung des Wissensgraphen, um einen breiteren Erkundungsraum zu schaffen; zweitens die erhebliche Erweiterung des Werkzeugrepertoires, um funktionale Grenzen zu verschieben; und schließlich die Anwendung einer strengen Low-Step-Filterung, um die Qualität und Effizienz der Trainingsdaten zu gewährleisten.
Die experimentellen Ergebnisse zeigen, dass OpenSeeker-v2 (mit 30 Milliarden Parametern und einer ReAct-Architektur), das auf lediglich 10.600 Datenpunkten trainiert wurde, bei vier zentralen Benchmarks eine überragende Leistung zeigte: Es erzielte 46,0 % bei BrowseComp, 58,1 % bei BrowseComp-ZH, 34,6 % bei „Humanity’s Last Exam“ und 78,0 % bei xbench. Diese Zahlen stellen nicht nur neue Rekorde auf, sondern übertreffen auch umfassend Branchenmodelle, die auf aufwendigen Pipelines basieren, welche CPT, SFT und RL kombinieren – wie beispielsweise Tongyi DeepResearch.
Bemerkenswert ist, dass dies der erste State-of-the-Art-Suchagent (SOTA) ist, der von einem rein akademischen Team ausschließlich unter Verwendung von SFT bei gleicher Modellgröße und Architektur entwickelt wurde. Das Team hat nun die Modellgewichte für OpenSeeker-v2 als Open Source veröffentlicht. Dieser Durchbruch senkt die Forschungs- und Entwicklungshürden für fortschrittliche Suchagenten erheblich und bietet sowohl der akademischen als auch der Open-Source-Community einen leichter zugänglichen, ressourcenschonenden Entwicklungsweg.
Artikel: https://arxiv.org/pdf/2605.04036








 Meta entfernt KI-Fotobearbeitungsfunktion nach Nutzerprotesten
Meta, der Social-Media-Riese, ist erneut in eine öffentliche Debatte über die heikle Balance zwischen künstlicher Intelligenz und dem Schutz der Privatsphäre der Nutzer verwickelt. Laut TechCrunch hat Meta’s Superintelligence Labs diese Woche einen n
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter

Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai












