


 Дом
Академическая команда положила конец монополии технологических гигантов с помощью SFT; OpenSeeker-v2 возглавил рейтинг поисковых агентов
В условиях постоянно развивающейся сферы крупных языковых моделей (LLM) возможности глубокого поиска стали решающим преимуществом для передовых интеллектуальных агентов. Однако эта сфера уже давно находится под контролем хорошо финансируемых отраслевых гигантов. Традиционные подходы к разработке, как правило, опираются на ресурсоемкие технологические цепочки, включающие предварительное обучение, продолжение предварительного обучения (CPT), контролируемую донастройку (SFT) и обучение с подкреплением (RL).
Команда научных исследователей недавно представила свою новейшую разработку — OpenSeeker-v2, которая кардинально оспаривает эту устоявшуюся точку зрения. Согласно их отчету, обучение на высококачественных траекториях задач повышенной сложности позволяет даже с помощью простого подхода с контролируемой тонкой настройкой (SFT) создать поискового агента высшего уровня.
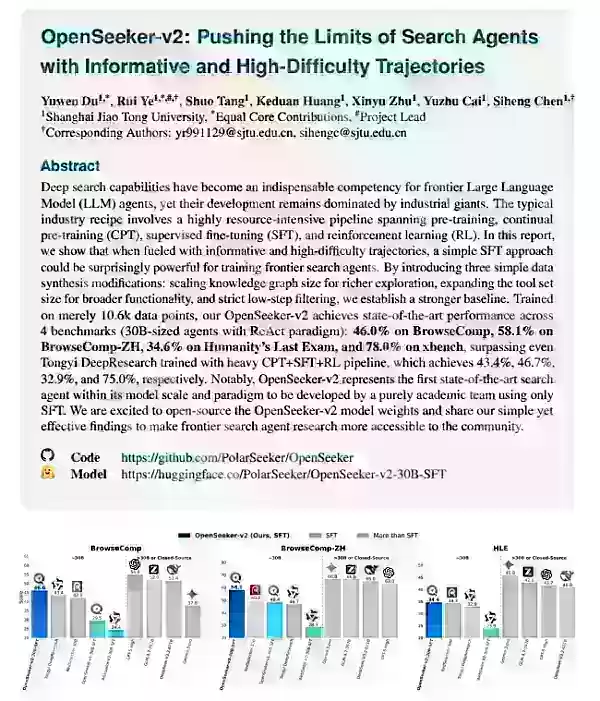
Команда обозначила три ключевые стратегии оптимизации синтеза данных: во-первых, увеличение масштаба графа знаний для создания более широкого пространства исследования; во-вторых, существенное расширение набора инструментов для расширения функциональных возможностей; и, наконец, применение строгой фильтрации с низким количеством шагов для обеспечения качества и эффективности обучающих данных.
Результаты экспериментов показывают, что OpenSeeker-v2 (с 30 млрд параметров и архитектурой ReAct), обученный всего на 10 600 точках данных, продемонстрировал впечатляющую производительность по четырём основным тестам: он набрал 46,0 % в BrowseComp, 58,1 % в BrowseComp-ZH, 34,6 % в тесте «Humanity’s Last Exam» и 78,0 % в xbench. Эти показатели не только установили новые рекорды, но и всесторонне превзошли отраслевые модели, основанные на сложных конвейерах, сочетающих CPT, SFT и RL, такие как Tongyi DeepResearch.
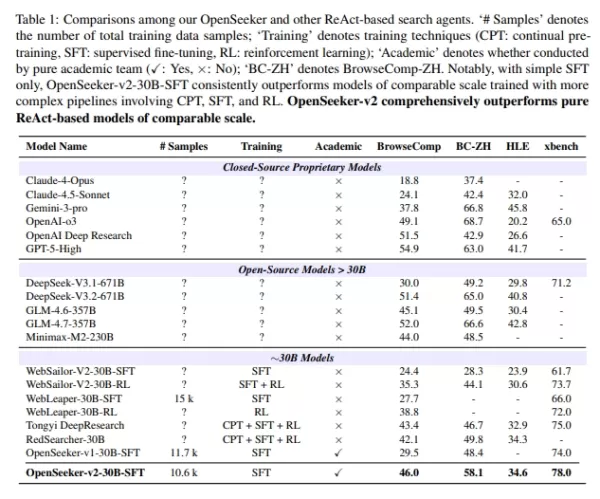
Примечательно, что это первый передовой (SOTA) поисковый агент, разработанный исключительно академической командой с использованием только SFT при том же масштабе и архитектуре модели. В настоящее время команда опубликовала веса модели OpenSeeker-v2 в открытом доступе. Этот прорыв значительно снижает барьеры для исследований и разработок в области передовых поисковых агентов и предлагает более доступный и облегчённый путь разработки как для академического сообщества, так и для сообщества открытого программного обеспечения.
Статья: https://arxiv.org/pdf/2605.04036
Связанная статья
 Суперинтеллект прибыл: впустим ли мы его?
Загрузка плеера…Компании, занимающиеся искусственным интеллектом, говорят о сверхинтеллектуальном ИИ так, будто это неизбежно, но недавние инциденты с безопасностью, такие как взлом Hugging Face компанией OpenAI, демонстрируют потенциальные опасност
iFLYTEK представляет общую большую модель Spark X2.5
1 сентября iFlytek откроет открытый доступ к двум большим языковым моделям, ориентированным на работу на периферийных устройствах: Xinghuo X2.5-4B и Xinghuo X2.5-1.7B, согласно последнему официальному заявлению. Обе модели изначально поддерживают кон
Meta удаляет функцию редактирования фотографий с помощью ИИ после негативной реакции пользователей
Meta, гигант социальных сетей, вновь оказалась в центре публичной дискуссии о хрупком балансе между искусственным интеллектом и конфиденциальностью пользователей. Согласно TechCrunch, подразделение Meta Superintelligence Labs представило новый генера
Рекомендации по связанным специальным темам
Создание анимации
 Инструменты искусственного интеллекта для анимации сцен в контенте социальных сетей
Здесь компания XIX.AI собрала лучшие и самые популярные инструменты 2026 года для создания анимации сцен с помощью ИИ, предназначенные для контента в социальных сетях. Эти мощные инструменты, способные кардинально изменить ситуацию в отрасли, прошли реальные тесты и сопровождаются подробным сравнением бесплатных и платных версий, что помогает авторам значительно повысить продуктивность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал в области ИИ.
 9 инструментов
 xix.ai
Создание видео
Генераторы привлекательных заглавий для коротких видеороликов с использованием ИИ: для Reels, Shorts и кампаний по запуску продуктов
2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
11 инструментов
xix.ai
письмо
Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

 Комментарии (0)
В условиях постоянно развивающейся сферы крупных языковых моделей (LLM) возможности глубокого поиска стали решающим преимуществом для передовых интеллектуальных агентов. Однако эта сфера уже давно находится под контролем хорошо финансируемых отраслевых гигантов. Традиционные подходы к разработке, как правило, опираются на ресурсоемкие технологические цепочки, включающие предварительное обучение, продолжение предварительного обучения (CPT), контролируемую донастройку (SFT) и обучение с подкреплением (RL).
Команда научных исследователей недавно представила свою новейшую разработку — OpenSeeker-v2, которая кардинально оспаривает эту устоявшуюся точку зрения. Согласно их отчету, обучение на высококачественных траекториях задач повышенной сложности позволяет даже с помощью простого подхода с контролируемой тонкой настройкой (SFT) создать поискового агента высшего уровня.
Команда обозначила три ключевые стратегии оптимизации синтеза данных: во-первых, увеличение масштаба графа знаний для создания более широкого пространства исследования; во-вторых, существенное расширение набора инструментов для расширения функциональных возможностей; и, наконец, применение строгой фильтрации с низким количеством шагов для обеспечения качества и эффективности обучающих данных.
Результаты экспериментов показывают, что OpenSeeker-v2 (с 30 млрд параметров и архитектурой ReAct), обученный всего на 10 600 точках данных, продемонстрировал впечатляющую производительность по четырём основным тестам: он набрал 46,0 % в BrowseComp, 58,1 % в BrowseComp-ZH, 34,6 % в тесте «Humanity’s Last Exam» и 78,0 % в xbench. Эти показатели не только установили новые рекорды, но и всесторонне превзошли отраслевые модели, основанные на сложных конвейерах, сочетающих CPT, SFT и RL, такие как Tongyi DeepResearch.
Примечательно, что это первый передовой (SOTA) поисковый агент, разработанный исключительно академической командой с использованием только SFT при том же масштабе и архитектуре модели. В настоящее время команда опубликовала веса модели OpenSeeker-v2 в открытом доступе. Этот прорыв значительно снижает барьеры для исследований и разработок в области передовых поисковых агентов и предлагает более доступный и облегчённый путь разработки как для академического сообщества, так и для сообщества открытого программного обеспечения.
Статья: https://arxiv.org/pdf/2605.04036








 Суперинтеллект прибыл: впустим ли мы его?
Загрузка плеера…Компании, занимающиеся искусственным интеллектом, говорят о сверхинтеллектуальном ИИ так, будто это неизбежно, но недавние инциденты с безопасностью, такие как взлом Hugging Face компанией OpenAI, демонстрируют потенциальные опасност
 iFLYTEK представляет общую большую модель Spark X2.5
1 сентября iFlytek откроет открытый доступ к двум большим языковым моделям, ориентированным на работу на периферийных устройствах: Xinghuo X2.5-4B и Xinghuo X2.5-1.7B, согласно последнему официальному заявлению. Обе модели изначально поддерживают кон
 Meta удаляет функцию редактирования фотографий с помощью ИИ после негативной реакции пользователей
Meta, гигант социальных сетей, вновь оказалась в центре публичной дискуссии о хрупком балансе между искусственным интеллектом и конфиденциальностью пользователей. Согласно TechCrunch, подразделение Meta Superintelligence Labs представило новый генера

Здесь компания XIX.AI собрала лучшие и самые популярные инструменты 2026 года для создания анимации сцен с помощью ИИ, предназначенные для контента в социальных сетях. Эти мощные инструменты, способные кардинально изменить ситуацию в отрасли, прошли реальные тесты и сопровождаются подробным сравнением бесплатных и платных версий, что помогает авторам значительно повысить продуктивность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал в области ИИ.
9 инструментов
xix.ai

2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
11 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai












