option
Maison
Flash info
Contenu
CarlPerez
CarlPerez
23 septembre 2026

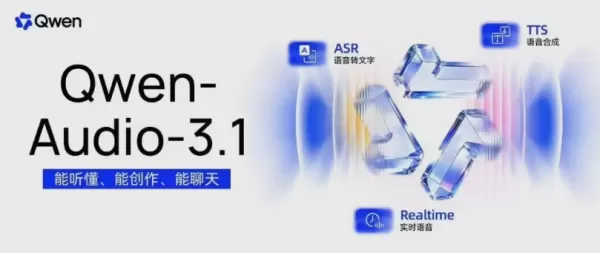
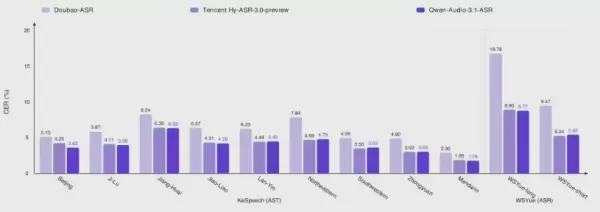
Alibaba Qwen a lancé Qwen-Audio-3.1, présentant cinq modèles couvrant la reconnaissance vocale, la synthèse vocale, l’interaction en temps réel et la création. Cette mise à jour réduit les prix de 70 à 95 %, rendant ainsi les technologies vocales très accessibles. Parmi les principales fonctionnalités, on retrouve la reconnaissance vocale (ASR) contextuelle avec correction native de la transcription, la prise en charge de 30 langues et de 16 dialectes chinois, ainsi qu’une latence ultra-faible. Le modèle TTS-Next permet la génération audio générale, combinant voix, effets sonores et bruits d’ambiance. L’interaction en temps réel prend en charge les conversations en duplex intégral avec reconnaissance des émotions et intégration d’outils. Cette suite complète réduit considérablement les coûts tout en améliorant la précision, la prise en charge multilingue et les capacités de production audio créative.
Alibaba Qwen a lancé Qwen-Audio-3.1, présentant cinq modèles couvrant la reconnaissance vocale, la synthèse vocale, l’interaction en temps réel et la création. Cette mise à jour réduit les prix de 70 à 95 %, rendant ainsi les technologies vocales très accessibles. Parmi les principales fonctionnalités, on retrouve la reconnaissance vocale (ASR) contextuelle avec correction native de la transcription, la prise en charge de 30 langues et de 16 dialectes chinois, ainsi qu’une latence ultra-faible. Le modèle TTS-Next permet la génération audio générale, combinant voix, effets sonores et bruits d’ambiance. L’interaction en temps réel prend en charge les conversations en duplex intégral avec reconnaissance des émotions et intégration d’outils. Cette suite complète réduit considérablement les coûts tout en améliorant la précision, la prise en charge multilingue et les capacités de production audio créative. Alibaba Qwen a lancé Qwen-Audio-3.1, présentant cinq modèles couvrant la reconnaissance vocale, la synthèse vocale, l’interaction en temps réel et la création. Cette mise à jour réduit les prix de 70 à 95 %, rendant ainsi les technologies vocales très accessibles. Parmi les principales fonctionnalités, on retrouve la reconnaissance vocale (ASR) contextuelle avec correction native de la transcription, la prise en charge de 30 langues et de 16 dialectes chinois, ainsi qu’une latence ultra-faible. Le modèle TTS-Next permet la génération audio générale, combinant voix, effets sonores et bruits d’ambiance. L’interaction en temps réel prend en charge les conversations en duplex intégral avec reconnaissance des émotions et intégration d’outils. Cette suite complète réduit considérablement les coûts tout en améliorant la précision, la prise en charge multilingue et les capacités de production audio créative.
commentaires (0)
0/300
OR