opción
Hogar
Última hora
Contenido
CarlPerez
CarlPerez
23 de septiembre de 2026

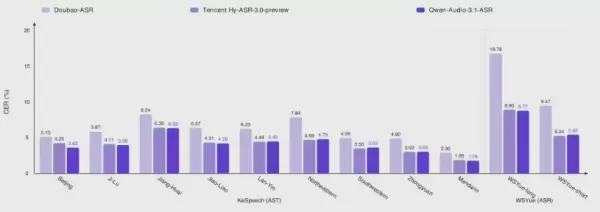
Alibaba Qwen ha lanzado Qwen-Audio-3.1, con el que presenta cinco modelos que abarcan el reconocimiento de voz, la síntesis, la interacción en tiempo real y la creación. La actualización reduce los precios entre un 70 % y un 95 %, lo que hace que la tecnología de voz sea muy accesible. Entre sus características principales se incluyen el reconocimiento automático de voz (ASR) sensible al contexto con pulido nativo de la transcripción, compatibilidad con 30 idiomas y 16 dialectos chinos, y una latencia ultrabaja. El modelo TTS-Next permite la generación de audio general, combinando voces, efectos de sonido y ruido ambiental. La interacción en tiempo real permite conversaciones full-duplex con reconocimiento de emociones e integración de herramientas. Este completo paquete reduce significativamente los costes al tiempo que mejora la precisión, la compatibilidad multilingüe y las capacidades de producción de audio creativa.
Alibaba Qwen ha lanzado Qwen-Audio-3.1, con el que presenta cinco modelos que abarcan el reconocimiento de voz, la síntesis, la interacción en tiempo real y la creación. La actualización reduce los precios entre un 70 % y un 95 %, lo que hace que la tecnología de voz sea muy accesible. Entre sus características principales se incluyen el reconocimiento automático de voz (ASR) sensible al contexto con pulido nativo de la transcripción, compatibilidad con 30 idiomas y 16 dialectos chinos, y una latencia ultrabaja. El modelo TTS-Next permite la generación de audio general, combinando voces, efectos de sonido y ruido ambiental. La interacción en tiempo real permite conversaciones full-duplex con reconocimiento de emociones e integración de herramientas. Este completo paquete reduce significativamente los costes al tiempo que mejora la precisión, la compatibilidad multilingüe y las capacidades de producción de audio creativa. Alibaba Qwen ha lanzado Qwen-Audio-3.1, con el que presenta cinco modelos que abarcan el reconocimiento de voz, la síntesis, la interacción en tiempo real y la creación. La actualización reduce los precios entre un 70 % y un 95 %, lo que hace que la tecnología de voz sea muy accesible. Entre sus características principales se incluyen el reconocimiento automático de voz (ASR) sensible al contexto con pulido nativo de la transcripción, compatibilidad con 30 idiomas y 16 dialectos chinos, y una latencia ultrabaja. El modelo TTS-Next permite la generación de audio general, combinando voces, efectos de sonido y ruido ambiental. La interacción en tiempo real permite conversaciones full-duplex con reconocimiento de emociones e integración de herramientas. Este completo paquete reduce significativamente los costes al tiempo que mejora la precisión, la compatibilidad multilingüe y las capacidades de producción de audio creativa.
comentario (0)
0/300
OR