Option
Heim
Eilmeldung
Inhalt
CarlPerez
CarlPerez
23. September 2026

Alibaba Qwen hat „Qwen-Audio-3.1“ eingeführt und damit fünf Modelle vorgestellt, die die Bereiche Spracherkennung, Sprachsynthese, Echtzeit-Interaktion und Sprachgenerierung abdecken. Das Update senkt die Preise um 70 bis 95 Prozent und macht Sprachtechnologie damit weitaus zugänglicher. Zu den wichtigsten Funktionen gehören kontextbezogene Spracherkennung (ASR) mit nativer Transkriptionsoptimierung, Unterstützung für 30 Sprachen und 16 chinesische Dialekte sowie extrem niedrige Latenzzeiten. Das Modell „TTS-Next“ ermöglicht die allgemeine Audiogenerierung und kombiniert dabei Stimmen, Soundeffekte und Umgebungsgeräusche. Die Echtzeit-Interaktion unterstützt Vollduplex-Gespräche mit Emotionserkennung und Tool-Integration. Diese umfassende Suite senkt die Kosten erheblich und verbessert gleichzeitig die Genauigkeit, die mehrsprachige Unterstützung sowie die Möglichkeiten zur kreativen Audioproduktion.
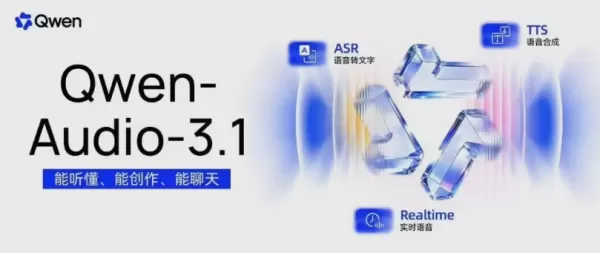
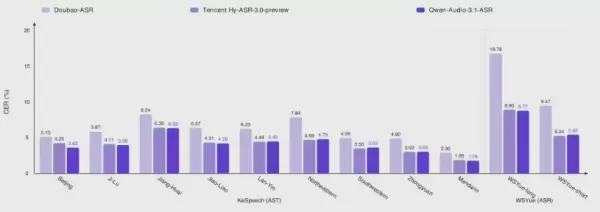
Alibaba Qwen hat „Qwen-Audio-3.1“ eingeführt und damit fünf Modelle vorgestellt, die die Bereiche Spracherkennung, Sprachsynthese, Echtzeit-Interaktion und Sprachgenerierung abdecken. Das Update senkt die Preise um 70 bis 95 Prozent und macht Sprachtechnologie damit weitaus zugänglicher. Zu den wichtigsten Funktionen gehören kontextbezogene Spracherkennung (ASR) mit nativer Transkriptionsoptimierung, Unterstützung für 30 Sprachen und 16 chinesische Dialekte sowie extrem niedrige Latenzzeiten. Das Modell „TTS-Next“ ermöglicht die allgemeine Audiogenerierung und kombiniert dabei Stimmen, Soundeffekte und Umgebungsgeräusche. Die Echtzeit-Interaktion unterstützt Vollduplex-Gespräche mit Emotionserkennung und Tool-Integration. Diese umfassende Suite senkt die Kosten erheblich und verbessert gleichzeitig die Genauigkeit, die mehrsprachige Unterstützung sowie die Möglichkeiten zur kreativen Audioproduktion. Alibaba Qwen hat „Qwen-Audio-3.1“ eingeführt und damit fünf Modelle vorgestellt, die die Bereiche Spracherkennung, Sprachsynthese, Echtzeit-Interaktion und Sprachgenerierung abdecken. Das Update senkt die Preise um 70 bis 95 Prozent und macht Sprachtechnologie damit weitaus zugänglicher. Zu den wichtigsten Funktionen gehören kontextbezogene Spracherkennung (ASR) mit nativer Transkriptionsoptimierung, Unterstützung für 30 Sprachen und 16 chinesische Dialekte sowie extrem niedrige Latenzzeiten. Das Modell „TTS-Next“ ermöglicht die allgemeine Audiogenerierung und kombiniert dabei Stimmen, Soundeffekte und Umgebungsgeräusche. Die Echtzeit-Interaktion unterstützt Vollduplex-Gespräche mit Emotionserkennung und Tool-Integration. Diese umfassende Suite senkt die Kosten erheblich und verbessert gleichzeitig die Genauigkeit, die mehrsprachige Unterstützung sowie die Möglichkeiten zur kreativen Audioproduktion.
Kommentare (0)
0/300
OR