opção
CarlPerez
CarlPerez
23 de Setembro de 2026

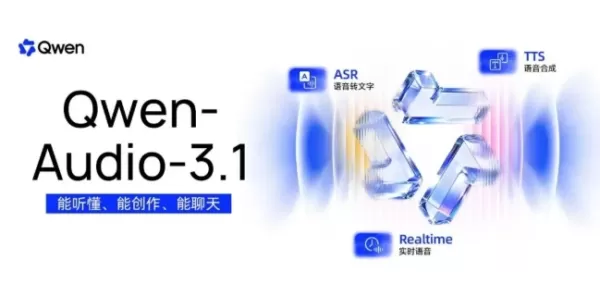
A Alibaba Qwen lançou o Qwen-Audio-3.1, apresentando cinco modelos que abrangem reconhecimento de fala, síntese, interação em tempo real e criação. A atualização reduz os preços em 70% a 95%, tornando a tecnologia de voz altamente acessível. Os principais recursos incluem ASR sensível ao contexto com refinamento nativo da transcrição, suporte a 30 idiomas e 16 dialetos chineses, além de latência ultrabaixa. O modelo TTS-Next permite a geração geral de áudio, combinando vozes, efeitos sonoros e ruídos ambientais. A interação em tempo real suporta conversas full-duplex com reconhecimento de emoções e integração de ferramentas. Esse pacote abrangente reduz significativamente os custos, ao mesmo tempo em que aprimora a precisão, o suporte multilíngue e os recursos de produção criativa de áudio.
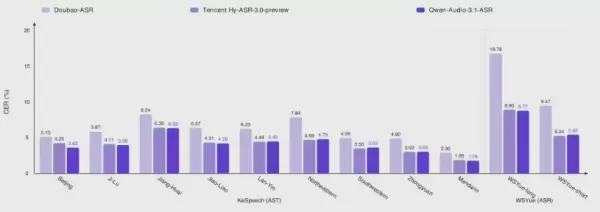
A Alibaba Qwen lançou o Qwen-Audio-3.1, apresentando cinco modelos que abrangem reconhecimento de fala, síntese, interação em tempo real e criação. A atualização reduz os preços em 70% a 95%, tornando a tecnologia de voz altamente acessível. Os principais recursos incluem ASR sensível ao contexto com refinamento nativo da transcrição, suporte a 30 idiomas e 16 dialetos chineses, além de latência ultrabaixa. O modelo TTS-Next permite a geração geral de áudio, combinando vozes, efeitos sonoros e ruídos ambientais. A interação em tempo real suporta conversas full-duplex com reconhecimento de emoções e integração de ferramentas. Esse pacote abrangente reduz significativamente os custos, ao mesmo tempo em que aprimora a precisão, o suporte multilíngue e os recursos de produção criativa de áudio. A Alibaba Qwen lançou o Qwen-Audio-3.1, apresentando cinco modelos que abrangem reconhecimento de fala, síntese, interação em tempo real e criação. A atualização reduz os preços em 70% a 95%, tornando a tecnologia de voz altamente acessível. Os principais recursos incluem ASR sensível ao contexto com refinamento nativo da transcrição, suporte a 30 idiomas e 16 dialetos chineses, além de latência ultrabaixa. O modelo TTS-Next permite a geração geral de áudio, combinando vozes, efeitos sonoros e ruídos ambientais. A interação em tempo real suporta conversas full-duplex com reconhecimento de emoções e integração de ferramentas. Esse pacote abrangente reduz significativamente os custos, ao mesmo tempo em que aprimora a precisão, o suporte multilíngue e os recursos de produção criativa de áudio.
Comentários (0)
0/300
OR