вариант
Дом
Срочные новости
Содержание
CarlPerez
CarlPerez
23 сентября 2026 г.

Alibaba Qwen представила Qwen-Audio-3.1, включившую пять моделей, охватывающих распознавание речи, синтез речи, взаимодействие в реальном времени и генерацию контента. Обновление позволяет снизить цены на 70–95 %, делая голосовые технологии широко доступными. Ключевые функции включают контекстно-зависимое распознавание речи (ASR) с встроенной корректировкой транскрипции, поддержку 30 языков и 16 китайских диалектов, а также сверхнизкую задержку. Модель TTS-Next позволяет генерировать аудио общего назначения, комбинируя голоса, звуковые эффекты и фоновые шумы. Взаимодействие в реальном времени поддерживает полнодуплексный диалог с распознаванием эмоций и интеграцией инструментов. Этот комплексный набор решений значительно снижает затраты, одновременно повышая точность, расширяя многоязычную поддержку и расширяя возможности для творческого создания аудиоконтента.
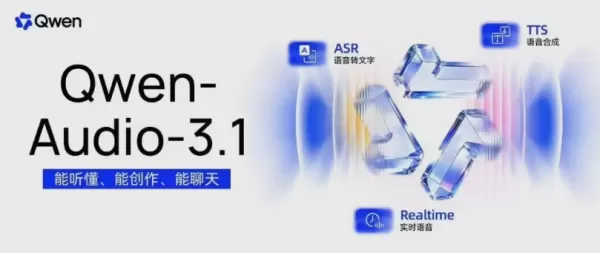
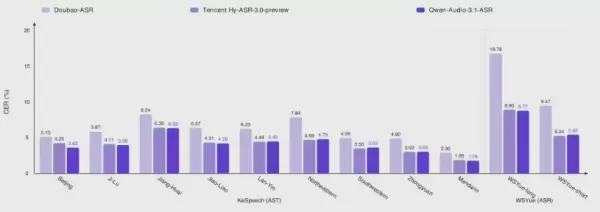
Alibaba Qwen представила Qwen-Audio-3.1, включившую пять моделей, охватывающих распознавание речи, синтез речи, взаимодействие в реальном времени и генерацию контента. Обновление позволяет снизить цены на 70–95 %, делая голосовые технологии широко доступными. Ключевые функции включают контекстно-зависимое распознавание речи (ASR) с встроенной корректировкой транскрипции, поддержку 30 языков и 16 китайских диалектов, а также сверхнизкую задержку. Модель TTS-Next позволяет генерировать аудио общего назначения, комбинируя голоса, звуковые эффекты и фоновые шумы. Взаимодействие в реальном времени поддерживает полнодуплексный диалог с распознаванием эмоций и интеграцией инструментов. Этот комплексный набор решений значительно снижает затраты, одновременно повышая точность, расширяя многоязычную поддержку и расширяя возможности для творческого создания аудиоконтента. Alibaba Qwen представила Qwen-Audio-3.1, включившую пять моделей, охватывающих распознавание речи, синтез речи, взаимодействие в реальном времени и генерацию контента. Обновление позволяет снизить цены на 70–95 %, делая голосовые технологии широко доступными. Ключевые функции включают контекстно-зависимое распознавание речи (ASR) с встроенной корректировкой транскрипции, поддержку 30 языков и 16 китайских диалектов, а также сверхнизкую задержку. Модель TTS-Next позволяет генерировать аудио общего назначения, комбинируя голоса, звуковые эффекты и фоновые шумы. Взаимодействие в реальном времени поддерживает полнодуплексный диалог с распознаванием эмоций и интеграцией инструментов. Этот комплексный набор решений значительно снижает затраты, одновременно повышая точность, расширяя многоязычную поддержку и расширяя возможности для творческого создания аудиоконтента.
OR