option
Maison
Flash info
Contenu
ScottRoberts
ScottRoberts
21 août 2026

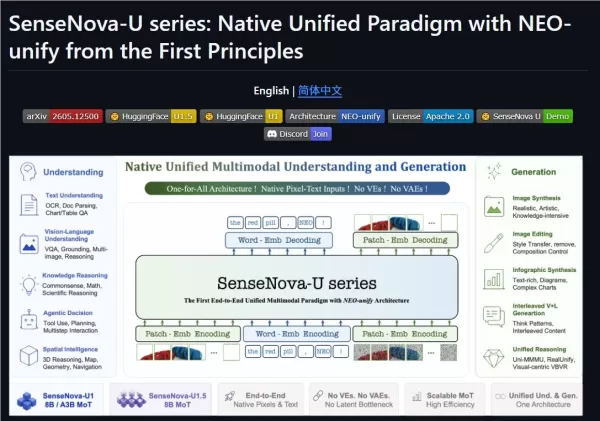
SenseTime a lancé SenseNova U1.5Lite, un nouveau grand modèle multimodal unifié, léger et open source, comptant 8 milliards de paramètres. Il surpasse les modèles de taille similaire dans les tâches visuelles de base et égale les performances de modèles commerciaux plus volumineux dans des scénarios complexes de mise en page et de rendu de texte. Le modèle prend en charge des longueurs de contexte comprises entre 3 et 4K, ce qui lui permet de gérer simultanément plusieurs contraintes et d’améliorer la stabilité des tâches. Il offre une génération visuelle de meilleure qualité, avec une composition, des couleurs, un réalisme et des détails améliorés, évitant ainsi le problème des résultats localement corrects mais globalement incomplets des modèles traditionnels. Ses capacités natives d’édition d’images préservent mieux l’identité du sujet, la structure spatiale et la mise en page, tout en améliorant les performances lors des modifications locales, du remplacement d’éléments, du raffinement du texte et de l’édition multi-références. Le modèle excelle également dans le traitement du texte et des mises en page complexes, prenant en charge les contenus en chinois et en anglais, les affiches, les infographies et la mise en forme multi-texte pour obtenir des résultats visuels complets. Il offre des options d’édition précises via le cadre de sélection (Bounding Box), les marqueurs visuels et les images de référence, et prend en charge la génération native en haute résolution 4K qui préserve les textures fines, les petits textes et les effets d’éclairage. Le projet est disponible à l’adresse https://github.com/OpenSenseNova/SenseNova-U1
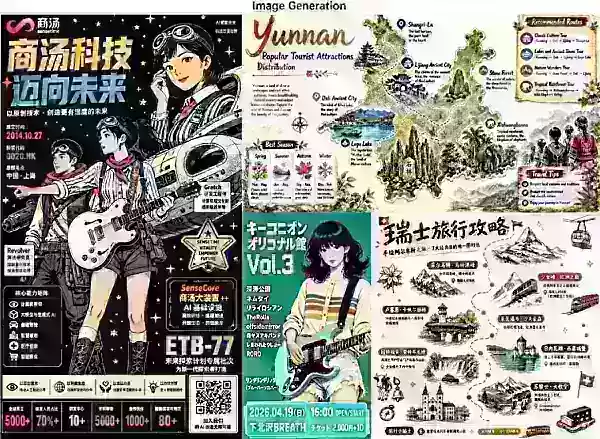
SenseTime a lancé SenseNova U1.5Lite, un nouveau grand modèle multimodal unifié, léger et open source, comptant 8 milliards de paramètres. Il surpasse les modèles de taille similaire dans les tâches visuelles de base et égale les performances de modèles commerciaux plus volumineux dans des scénarios complexes de mise en page et de rendu de texte. Le modèle prend en charge des longueurs de contexte comprises entre 3 et 4K, ce qui lui permet de gérer simultanément plusieurs contraintes et d’améliorer la stabilité des tâches. Il offre une génération visuelle de meilleure qualité, avec une composition, des couleurs, un réalisme et des détails améliorés, évitant ainsi le problème des résultats localement corrects mais globalement incomplets des modèles traditionnels. Ses capacités natives d’édition d’images préservent mieux l’identité du sujet, la structure spatiale et la mise en page, tout en améliorant les performances lors des modifications locales, du remplacement d’éléments, du raffinement du texte et de l’édition multi-références. Le modèle excelle également dans le traitement du texte et des mises en page complexes, prenant en charge les contenus en chinois et en anglais, les affiches, les infographies et la mise en forme multi-texte pour obtenir des résultats visuels complets. Il offre des options d’édition précises via le cadre de sélection (Bounding Box), les marqueurs visuels et les images de référence, et prend en charge la génération native en haute résolution 4K qui préserve les textures fines, les petits textes et les effets d’éclairage. Le projet est disponible à l’adresse https://github.com/OpenSenseNova/SenseNova-U1 SenseTime a lancé SenseNova U1.5Lite, un nouveau grand modèle multimodal unifié, léger et open source, comptant 8 milliards de paramètres. Il surpasse les modèles de taille similaire dans les tâches visuelles de base et égale les performances de modèles commerciaux plus volumineux dans des scénarios complexes de mise en page et de rendu de texte. Le modèle prend en charge des longueurs de contexte comprises entre 3 et 4K, ce qui lui permet de gérer simultanément plusieurs contraintes et d’améliorer la stabilité des tâches. Il offre une génération visuelle de meilleure qualité, avec une composition, des couleurs, un réalisme et des détails améliorés, évitant ainsi le problème des résultats localement corrects mais globalement incomplets des modèles traditionnels. Ses capacités natives d’édition d’images préservent mieux l’identité du sujet, la structure spatiale et la mise en page, tout en améliorant les performances lors des modifications locales, du remplacement d’éléments, du raffinement du texte et de l’édition multi-références. Le modèle excelle également dans le traitement du texte et des mises en page complexes, prenant en charge les contenus en chinois et en anglais, les affiches, les infographies et la mise en forme multi-texte pour obtenir des résultats visuels complets. Il offre des options d’édition précises via le cadre de sélection (Bounding Box), les marqueurs visuels et les images de référence, et prend en charge la génération native en haute résolution 4K qui préserve les textures fines, les petits textes et les effets d’éclairage. Le projet est disponible à l’adresse https://github.com/OpenSenseNova/SenseNova-U1
commentaires (0)
0/300
OR