opción
Hogar
Última hora
Contenido
ScottRoberts
ScottRoberts
21 de agosto de 2026

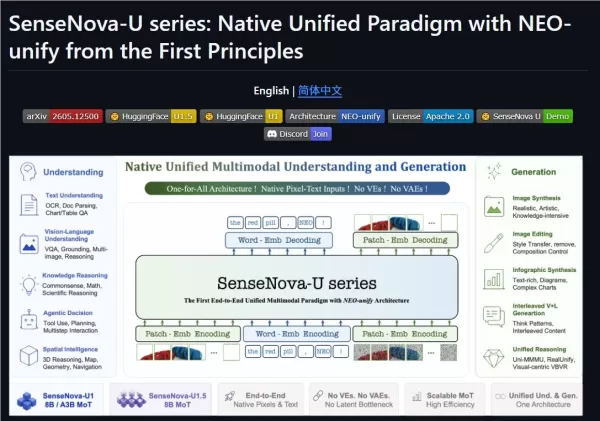
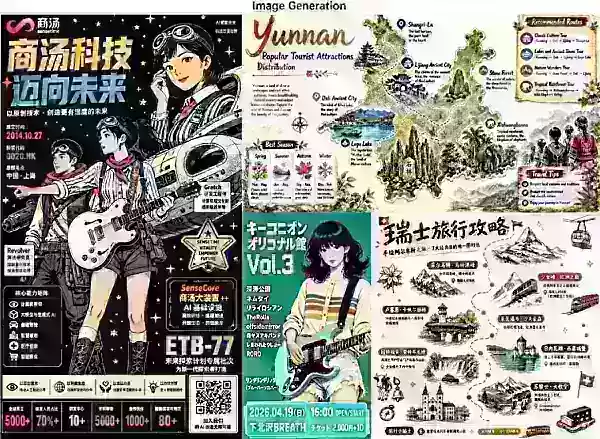
SenseTime ha lanzado SenseNova U1.5Lite, un nuevo modelo multimodal unificado de código abierto, ligero y de gran tamaño con 8.000 millones de parámetros. Supera a los modelos de tamaño similar en tareas visuales básicas e iguala el rendimiento de modelos comerciales más grandes en escenarios complejos de maquetación y representación de texto. El modelo admite longitudes de contexto de entre 3 y 4 K, lo que le permite gestionar múltiples restricciones simultáneamente y mejora la estabilidad de las tareas. Ofrece una generación visual de mayor calidad con una composición, un color, un realismo y unos detalles mejorados, evitando el problema de los modelos tradicionales, que ofrecen resultados localmente correctos pero globalmente incompletos. Sus capacidades nativas de edición de imágenes preservan mejor la identidad del sujeto, la estructura espacial y el diseño, al tiempo que potencian el rendimiento en modificaciones locales, sustitución de elementos, refinamiento de texto y edición con múltiples referencias. El modelo también destaca en el manejo de texto y diseños complejos, admitiendo contenido en chino e inglés, carteles, infografías y formato multitexto para lograr resultados visuales completos. Ofrece opciones de edición precisas mediante el cuadro delimitador, el marcador visual e imágenes de referencia, y admite la generación nativa en alta resolución 4K que conserva texturas finas, textos pequeños y efectos de iluminación. El proyecto está disponible en https://github.com/OpenSenseNova/SenseNova-U1
SenseTime ha lanzado SenseNova U1.5Lite, un nuevo modelo multimodal unificado de código abierto, ligero y de gran tamaño con 8.000 millones de parámetros. Supera a los modelos de tamaño similar en tareas visuales básicas e iguala el rendimiento de modelos comerciales más grandes en escenarios complejos de maquetación y representación de texto. El modelo admite longitudes de contexto de entre 3 y 4 K, lo que le permite gestionar múltiples restricciones simultáneamente y mejora la estabilidad de las tareas. Ofrece una generación visual de mayor calidad con una composición, un color, un realismo y unos detalles mejorados, evitando el problema de los modelos tradicionales, que ofrecen resultados localmente correctos pero globalmente incompletos. Sus capacidades nativas de edición de imágenes preservan mejor la identidad del sujeto, la estructura espacial y el diseño, al tiempo que potencian el rendimiento en modificaciones locales, sustitución de elementos, refinamiento de texto y edición con múltiples referencias. El modelo también destaca en el manejo de texto y diseños complejos, admitiendo contenido en chino e inglés, carteles, infografías y formato multitexto para lograr resultados visuales completos. Ofrece opciones de edición precisas mediante el cuadro delimitador, el marcador visual e imágenes de referencia, y admite la generación nativa en alta resolución 4K que conserva texturas finas, textos pequeños y efectos de iluminación. El proyecto está disponible en https://github.com/OpenSenseNova/SenseNova-U1 SenseTime ha lanzado SenseNova U1.5Lite, un nuevo modelo multimodal unificado de código abierto, ligero y de gran tamaño con 8.000 millones de parámetros. Supera a los modelos de tamaño similar en tareas visuales básicas e iguala el rendimiento de modelos comerciales más grandes en escenarios complejos de maquetación y representación de texto. El modelo admite longitudes de contexto de entre 3 y 4 K, lo que le permite gestionar múltiples restricciones simultáneamente y mejora la estabilidad de las tareas. Ofrece una generación visual de mayor calidad con una composición, un color, un realismo y unos detalles mejorados, evitando el problema de los modelos tradicionales, que ofrecen resultados localmente correctos pero globalmente incompletos. Sus capacidades nativas de edición de imágenes preservan mejor la identidad del sujeto, la estructura espacial y el diseño, al tiempo que potencian el rendimiento en modificaciones locales, sustitución de elementos, refinamiento de texto y edición con múltiples referencias. El modelo también destaca en el manejo de texto y diseños complejos, admitiendo contenido en chino e inglés, carteles, infografías y formato multitexto para lograr resultados visuales completos. Ofrece opciones de edición precisas mediante el cuadro delimitador, el marcador visual e imágenes de referencia, y admite la generación nativa en alta resolución 4K que conserva texturas finas, textos pequeños y efectos de iluminación. El proyecto está disponible en https://github.com/OpenSenseNova/SenseNova-U1
comentario (0)
0/300
OR