Option
Heim
Eilmeldung
Inhalt
ScottRoberts
ScottRoberts
21. August 2026

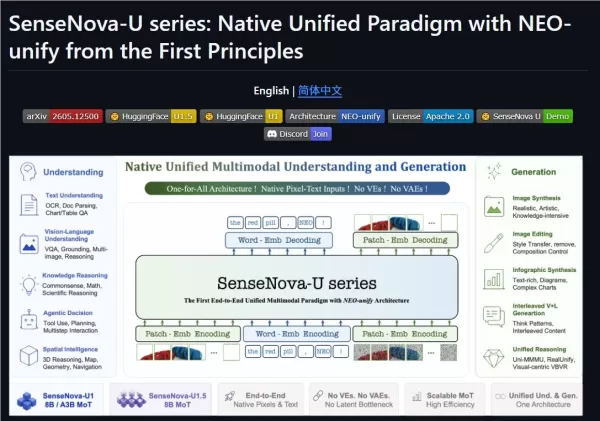
SenseTime hat SenseNova U1.5Lite veröffentlicht, ein neues, leichtgewichtiges, einheitliches, multimodales Open-Source-Großmodell mit 8 Milliarden Parametern. Es übertrifft Modelle ähnlicher Größe bei zentralen visuellen Aufgaben und erreicht in komplexen Layout- und Textdarstellungsszenarien die Leistung größerer kommerzieller Modelle. Das Modell unterstützt Kontextlängen von 3 bis 4K, wodurch es mehrere Einschränkungen gleichzeitig bewältigen kann und die Aufgabenstabilität verbessert wird. Es liefert eine qualitativ hochwertigere visuelle Generierung mit verbesserter Komposition, Farbe, Realismus und Detailtreue und vermeidet so das Problem traditioneller Modelle, bei denen die Ergebnisse lokal korrekt, insgesamt jedoch unvollständig sind. Seine nativen Bildbearbeitungsfunktionen bewahren die Identität des Motivs, die räumliche Struktur und das Layout besser und steigern gleichzeitig die Leistung bei lokalen Änderungen, dem Austausch von Elementen, der Textverfeinerung und der Bearbeitung mit mehreren Referenzen. Das Modell zeichnet sich zudem durch die Verarbeitung von Text und komplexen Layouts aus und unterstützt chinesische und englische Inhalte, Plakate, Infografiken sowie die Formatierung mehrerer Textabschnitte, um vollständige visuelle Ergebnisse zu erzielen. Es bietet präzise Bearbeitungsoptionen über Begrenzungsrahmen, visuelle Markierungen und Referenzbilder und unterstützt die native Erzeugung in 4K-Hochauflösung, bei der feine Texturen, kleine Texte und Lichteffekte erhalten bleiben. Das Projekt ist unter https://github.com/OpenSenseNova/SenseNova-U1 verfügbar.
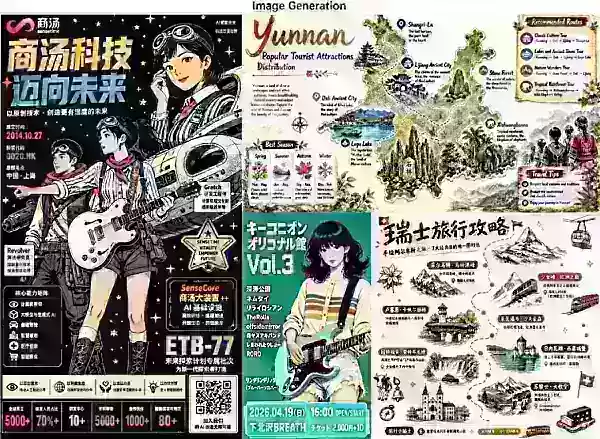
SenseTime hat SenseNova U1.5Lite veröffentlicht, ein neues, leichtgewichtiges, einheitliches, multimodales Open-Source-Großmodell mit 8 Milliarden Parametern. Es übertrifft Modelle ähnlicher Größe bei zentralen visuellen Aufgaben und erreicht in komplexen Layout- und Textdarstellungsszenarien die Leistung größerer kommerzieller Modelle. Das Modell unterstützt Kontextlängen von 3 bis 4K, wodurch es mehrere Einschränkungen gleichzeitig bewältigen kann und die Aufgabenstabilität verbessert wird. Es liefert eine qualitativ hochwertigere visuelle Generierung mit verbesserter Komposition, Farbe, Realismus und Detailtreue und vermeidet so das Problem traditioneller Modelle, bei denen die Ergebnisse lokal korrekt, insgesamt jedoch unvollständig sind. Seine nativen Bildbearbeitungsfunktionen bewahren die Identität des Motivs, die räumliche Struktur und das Layout besser und steigern gleichzeitig die Leistung bei lokalen Änderungen, dem Austausch von Elementen, der Textverfeinerung und der Bearbeitung mit mehreren Referenzen. Das Modell zeichnet sich zudem durch die Verarbeitung von Text und komplexen Layouts aus und unterstützt chinesische und englische Inhalte, Plakate, Infografiken sowie die Formatierung mehrerer Textabschnitte, um vollständige visuelle Ergebnisse zu erzielen. Es bietet präzise Bearbeitungsoptionen über Begrenzungsrahmen, visuelle Markierungen und Referenzbilder und unterstützt die native Erzeugung in 4K-Hochauflösung, bei der feine Texturen, kleine Texte und Lichteffekte erhalten bleiben. Das Projekt ist unter https://github.com/OpenSenseNova/SenseNova-U1 verfügbar. SenseTime hat SenseNova U1.5Lite veröffentlicht, ein neues, leichtgewichtiges, einheitliches, multimodales Open-Source-Großmodell mit 8 Milliarden Parametern. Es übertrifft Modelle ähnlicher Größe bei zentralen visuellen Aufgaben und erreicht in komplexen Layout- und Textdarstellungsszenarien die Leistung größerer kommerzieller Modelle. Das Modell unterstützt Kontextlängen von 3 bis 4K, wodurch es mehrere Einschränkungen gleichzeitig bewältigen kann und die Aufgabenstabilität verbessert wird. Es liefert eine qualitativ hochwertigere visuelle Generierung mit verbesserter Komposition, Farbe, Realismus und Detailtreue und vermeidet so das Problem traditioneller Modelle, bei denen die Ergebnisse lokal korrekt, insgesamt jedoch unvollständig sind. Seine nativen Bildbearbeitungsfunktionen bewahren die Identität des Motivs, die räumliche Struktur und das Layout besser und steigern gleichzeitig die Leistung bei lokalen Änderungen, dem Austausch von Elementen, der Textverfeinerung und der Bearbeitung mit mehreren Referenzen. Das Modell zeichnet sich zudem durch die Verarbeitung von Text und komplexen Layouts aus und unterstützt chinesische und englische Inhalte, Plakate, Infografiken sowie die Formatierung mehrerer Textabschnitte, um vollständige visuelle Ergebnisse zu erzielen. Es bietet präzise Bearbeitungsoptionen über Begrenzungsrahmen, visuelle Markierungen und Referenzbilder und unterstützt die native Erzeugung in 4K-Hochauflösung, bei der feine Texturen, kleine Texte und Lichteffekte erhalten bleiben. Das Projekt ist unter https://github.com/OpenSenseNova/SenseNova-U1 verfügbar.
Kommentare (0)
0/300
OR