opção
ScottRoberts
ScottRoberts
21 de Agosto de 2026

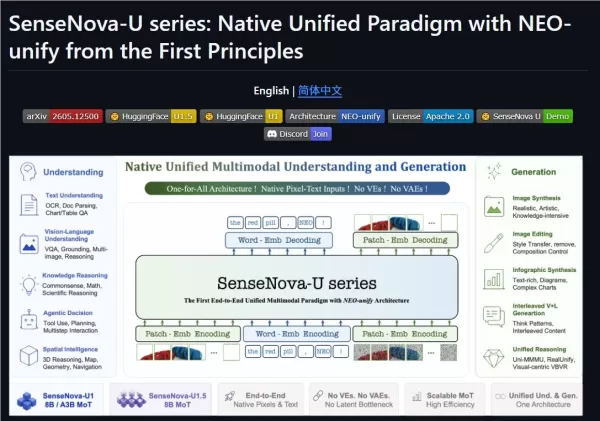
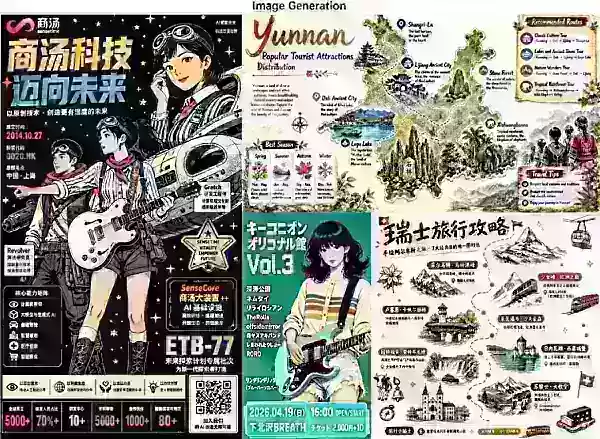
A SenseTime lançou o SenseNova U1.5Lite, um novo modelo multimodal unificado, leve e de código aberto, com 8 bilhões de parâmetros. Ele supera modelos de tamanho semelhante em tarefas visuais essenciais e iguala o desempenho de modelos comerciais maiores em cenários complexos de layout e renderização de texto. O modelo suporta comprimentos de contexto de 3 a 4 mil, o que permite lidar com múltiplas restrições simultaneamente e melhora a estabilidade das tarefas. Ele oferece geração visual de maior qualidade com composição, cor, realismo e detalhes aprimorados, evitando o problema de resultados localmente corretos, mas globalmente incompletos, característico dos modelos tradicionais. Seus recursos nativos de edição de imagem preservam melhor a identidade do objeto, a estrutura espacial e o layout, ao mesmo tempo em que aumentam o desempenho em modificações locais, substituição de elementos, refinamento de texto e edição com múltiplas referências. O modelo também se destaca no tratamento de texto e layouts complexos, suportando conteúdo em chinês e inglês, pôsteres, infográficos e formatação com múltiplos textos para alcançar resultados visuais completos. Ele oferece opções de edição precisas por meio de Bounding Box, Visual Marker e imagens de referência, além de suportar geração nativa em alta resolução 4K que mantém texturas finas, textos pequenos e efeitos de iluminação. O projeto está disponível em https://github.com/OpenSenseNova/SenseNova-U1
A SenseTime lançou o SenseNova U1.5Lite, um novo modelo multimodal unificado, leve e de código aberto, com 8 bilhões de parâmetros. Ele supera modelos de tamanho semelhante em tarefas visuais essenciais e iguala o desempenho de modelos comerciais maiores em cenários complexos de layout e renderização de texto. O modelo suporta comprimentos de contexto de 3 a 4 mil, o que permite lidar com múltiplas restrições simultaneamente e melhora a estabilidade das tarefas. Ele oferece geração visual de maior qualidade com composição, cor, realismo e detalhes aprimorados, evitando o problema de resultados localmente corretos, mas globalmente incompletos, característico dos modelos tradicionais. Seus recursos nativos de edição de imagem preservam melhor a identidade do objeto, a estrutura espacial e o layout, ao mesmo tempo em que aumentam o desempenho em modificações locais, substituição de elementos, refinamento de texto e edição com múltiplas referências. O modelo também se destaca no tratamento de texto e layouts complexos, suportando conteúdo em chinês e inglês, pôsteres, infográficos e formatação com múltiplos textos para alcançar resultados visuais completos. Ele oferece opções de edição precisas por meio de Bounding Box, Visual Marker e imagens de referência, além de suportar geração nativa em alta resolução 4K que mantém texturas finas, textos pequenos e efeitos de iluminação. O projeto está disponível em https://github.com/OpenSenseNova/SenseNova-U1 A SenseTime lançou o SenseNova U1.5Lite, um novo modelo multimodal unificado, leve e de código aberto, com 8 bilhões de parâmetros. Ele supera modelos de tamanho semelhante em tarefas visuais essenciais e iguala o desempenho de modelos comerciais maiores em cenários complexos de layout e renderização de texto. O modelo suporta comprimentos de contexto de 3 a 4 mil, o que permite lidar com múltiplas restrições simultaneamente e melhora a estabilidade das tarefas. Ele oferece geração visual de maior qualidade com composição, cor, realismo e detalhes aprimorados, evitando o problema de resultados localmente corretos, mas globalmente incompletos, característico dos modelos tradicionais. Seus recursos nativos de edição de imagem preservam melhor a identidade do objeto, a estrutura espacial e o layout, ao mesmo tempo em que aumentam o desempenho em modificações locais, substituição de elementos, refinamento de texto e edição com múltiplas referências. O modelo também se destaca no tratamento de texto e layouts complexos, suportando conteúdo em chinês e inglês, pôsteres, infográficos e formatação com múltiplos textos para alcançar resultados visuais completos. Ele oferece opções de edição precisas por meio de Bounding Box, Visual Marker e imagens de referência, além de suportar geração nativa em alta resolução 4K que mantém texturas finas, textos pequenos e efeitos de iluminação. O projeto está disponível em https://github.com/OpenSenseNova/SenseNova-U1
Comentários (0)
0/300
OR