option
Maison
Flash info
Contenu
CarlPerez
CarlPerez
4 août 2026

Tencent Hunyuan a publié une version préliminaire de Hy ASR 3.0, un modèle de reconnaissance vocale basé sur le LLM Hy3. Ce modèle améliore la reconnaissance générale, la prise en compte du contexte, la robustesse dans divers scénarios et la couverture des dialectes, passant d’une transcription mot à mot à une compréhension du contexte. Sur des ensembles d'évaluation open source internationaux, les taux d'erreur par mot ont atteint 3,34 % pour le mandarin, 2,62 % pour l'anglais et 3,12 % pour le cantonais. L'ensemble d'évaluation propre à Tencent a également montré de faibles taux d'erreur dans divers scénarios.
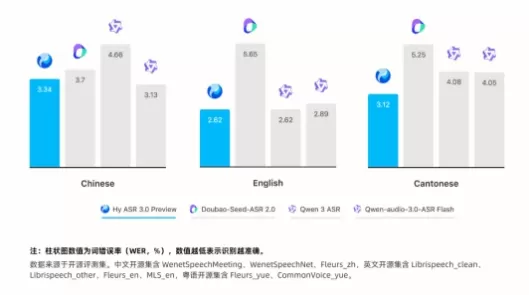
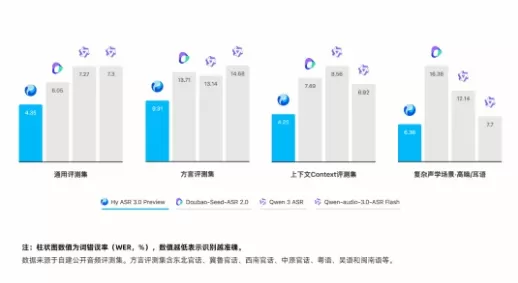
Tencent Hunyuan a publié une version préliminaire de Hy ASR 3.0, un modèle de reconnaissance vocale basé sur le LLM Hy3. Ce modèle améliore la reconnaissance générale, la prise en compte du contexte, la robustesse dans divers scénarios et la couverture des dialectes, passant d’une transcription mot à mot à une compréhension du contexte. Sur des ensembles d'évaluation open source internationaux, les taux d'erreur par mot ont atteint 3,34 % pour le mandarin, 2,62 % pour l'anglais et 3,12 % pour le cantonais. L'ensemble d'évaluation propre à Tencent a également montré de faibles taux d'erreur dans divers scénarios. Tencent Hunyuan a publié une version préliminaire de Hy ASR 3.0, un modèle de reconnaissance vocale basé sur le LLM Hy3. Ce modèle améliore la reconnaissance générale, la prise en compte du contexte, la robustesse dans divers scénarios et la couverture des dialectes, passant d’une transcription mot à mot à une compréhension du contexte. Sur des ensembles d'évaluation open source internationaux, les taux d'erreur par mot ont atteint 3,34 % pour le mandarin, 2,62 % pour l'anglais et 3,12 % pour le cantonais. L'ensemble d'évaluation propre à Tencent a également montré de faibles taux d'erreur dans divers scénarios.
commentaires (0)
0/300
OR