opción
Hogar
Última hora
Contenido
CarlPerez
CarlPerez
4 de agosto de 2026

Tencent Hunyuan ha lanzado la versión preliminar de Hy ASR 3.0, un modelo de reconocimiento de voz basado en el modelo de lenguaje grande (LLM) Hy3. Este modelo mejora el reconocimiento general, la comprensión del contexto, la robustez en múltiples escenarios y la cobertura de dialectos, pasando de la transcripción palabra por palabra a la comprensión del contexto. En conjuntos de evaluación de código abierto internacionales, las tasas de error por palabra alcanzaron el 3,34 % en mandarín, el 2,62 % en inglés y el 3,12 % en cantonés. El conjunto de evaluación propio de Tencent también mostró bajas tasas de error en diversos escenarios.
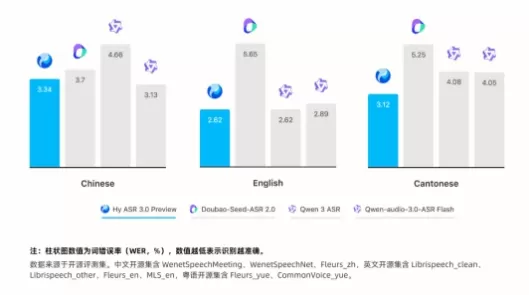
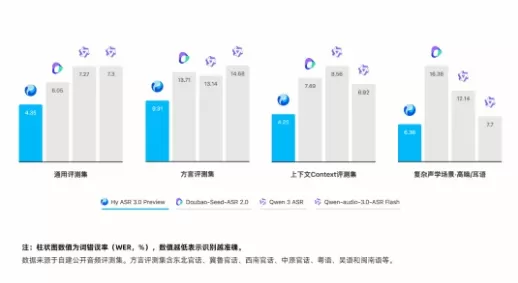
Tencent Hunyuan ha lanzado la versión preliminar de Hy ASR 3.0, un modelo de reconocimiento de voz basado en el modelo de lenguaje grande (LLM) Hy3. Este modelo mejora el reconocimiento general, la comprensión del contexto, la robustez en múltiples escenarios y la cobertura de dialectos, pasando de la transcripción palabra por palabra a la comprensión del contexto. En conjuntos de evaluación de código abierto internacionales, las tasas de error por palabra alcanzaron el 3,34 % en mandarín, el 2,62 % en inglés y el 3,12 % en cantonés. El conjunto de evaluación propio de Tencent también mostró bajas tasas de error en diversos escenarios. Tencent Hunyuan ha lanzado la versión preliminar de Hy ASR 3.0, un modelo de reconocimiento de voz basado en el modelo de lenguaje grande (LLM) Hy3. Este modelo mejora el reconocimiento general, la comprensión del contexto, la robustez en múltiples escenarios y la cobertura de dialectos, pasando de la transcripción palabra por palabra a la comprensión del contexto. En conjuntos de evaluación de código abierto internacionales, las tasas de error por palabra alcanzaron el 3,34 % en mandarín, el 2,62 % en inglés y el 3,12 % en cantonés. El conjunto de evaluación propio de Tencent también mostró bajas tasas de error en diversos escenarios.
comentario (0)
0/300
OR