
option
Maison
Flash info
Contenu
BillyThomas
BillyThomas
17 juillet 2026

NVIDIA a lancé la série de modèles d'intégration Nemotron-3-Embed destinés à la mise en œuvre en production du RAG, de la recherche de code et de la mémoire d'agent. La version 8B BF16 occupe la première place du benchmark RTEB avec un score de 78,46 NDCG@10. La série comprend des versions 1B BF16 et 1B NVFP4 (4 bits), toutes basées sur l’architecture Mistral, prenant en charge 34 langues et 32 000 tokens. Les modèles 1B ont été créés grâce à l'élagage et à la distillation de connaissances. La version NVFP4 conserve une précision de 99,5 % avec un débit deux fois supérieur sur Blackwell. Elle prend en charge le déploiement vLLM ; les versions BF16 prennent en charge les modèles Transformers et Sentence Transformers.
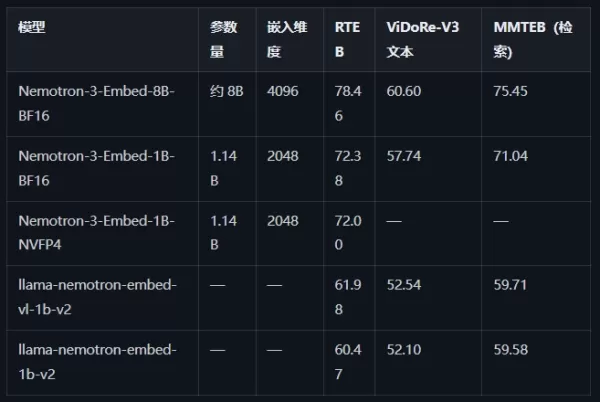
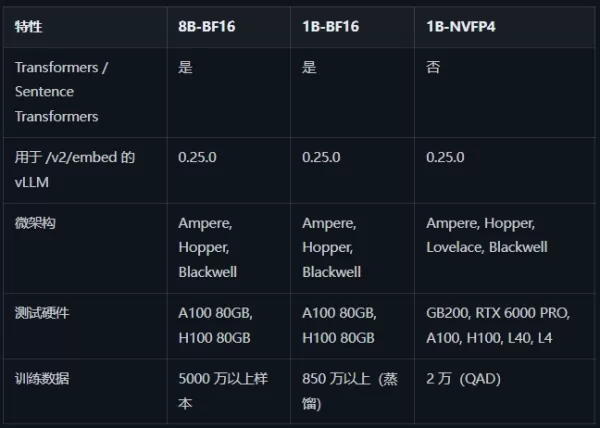
NVIDIA a lancé la série de modèles d'intégration Nemotron-3-Embed destinés à la mise en œuvre en production du RAG, de la recherche de code et de la mémoire d'agent. La version 8B BF16 occupe la première place du benchmark RTEB avec un score de 78,46 NDCG@10. La série comprend des versions 1B BF16 et 1B NVFP4 (4 bits), toutes basées sur l’architecture Mistral, prenant en charge 34 langues et 32 000 tokens. Les modèles 1B ont été créés grâce à l'élagage et à la distillation de connaissances. La version NVFP4 conserve une précision de 99,5 % avec un débit deux fois supérieur sur Blackwell. Elle prend en charge le déploiement vLLM ; les versions BF16 prennent en charge les modèles Transformers et Sentence Transformers. NVIDIA a lancé la série de modèles d'intégration Nemotron-3-Embed destinés à la mise en œuvre en production du RAG, de la recherche de code et de la mémoire d'agent. La version 8B BF16 occupe la première place du benchmark RTEB avec un score de 78,46 NDCG@10. La série comprend des versions 1B BF16 et 1B NVFP4 (4 bits), toutes basées sur l’architecture Mistral, prenant en charge 34 langues et 32 000 tokens. Les modèles 1B ont été créés grâce à l'élagage et à la distillation de connaissances. La version NVFP4 conserve une précision de 99,5 % avec un débit deux fois supérieur sur Blackwell. Elle prend en charge le déploiement vLLM ; les versions BF16 prennent en charge les modèles Transformers et Sentence Transformers.
commentaires (0)
0/300
OR