


Découvrez des outils AI de qualité
Rassemblez les principaux outils d'intelligence artificielle du monde pour aider à améliorer l'efficacité du travail

Articles publiés par BillyThomas
Le professeur Wang Xiaobo de l’Université agricole du Anhui a présenté le grand modèle vertical « Fengshu » 2.0 destiné à la recherche sur le soja lors du 32e Séminaire national sur la recherche et la production du soja, tenu à Nanning. Cette version mise à jour intègre plusieurs sources de données (ressources de gérmplasme, génomes, échantillons de maladies, archives d’amélioration génétique, littérature scientifique) afin de créer un système de connaissances structuré. Il dispose d’un mécanisme d’analyse collaborative à plusieurs modèles qui permet de réduire les biais liés aux modèles uniques en obtenant des réponses indépendantes aux questions spécialisées, suivies d’un module de synthèse qui évalue le consensus, les différences et la qualité des preuves en s’appuyant sur des connaissances sectorielles et des données privées. Ce modèle offre six modules fonctionnels pour le diagnostic des maladies, la sélection des parents, la conception de croisements virtuels, l’analyse phénotypique, l’amélioration génétique assistée par des marqueurs et l’étude de la fonction des gènes ; il s’appuie sur un graphe de connaissances comprenant 20 000 entités et 100 000 relations, ainsi que sur d’importantes données génomiques et phénotypiques. Cette mise à jour améliore la stabilité des outils de recherche sur le soja en évitant les erreurs causées par les « hallucinations » propres aux modèles uniques.
Le professeur Wang Xiaobo de l’Université agricole du Anhui a présenté le grand modèle vertical « Fengshu » 2.0 destiné à la recherche sur le soja lors du 32e Séminaire national sur la recherche et la production du soja, tenu à Nanning. Cette version mise à jour intègre plusieurs sources de données (ressources de gérmplasme, génomes, échantillons de maladies, archives d’amélioration génétique, littérature scientifique) afin de créer un système de connaissances structuré. Il dispose d’un mécanisme d’analyse collaborative à plusieurs modèles qui permet de réduire les biais liés aux modèles uniques en obtenant des réponses indépendantes aux questions spécialisées, suivies d’un module de synthèse qui évalue le consensus, les différences et la qualité des preuves en s’appuyant sur des connaissances sectorielles et des données privées. Ce modèle offre six modules fonctionnels pour le diagnostic des maladies, la sélection des parents, la conception de croisements virtuels, l’analyse phénotypique, l’amélioration génétique assistée par des marqueurs et l’étude de la fonction des gènes ; il s’appuie sur un graphe de connaissances comprenant 20 000 entités et 100 000 relations, ainsi que sur d’importantes données génomiques et phénotypiques. Cette mise à jour améliore la stabilité des outils de recherche sur le soja en évitant les erreurs causées par les « hallucinations » propres aux modèles uniques.

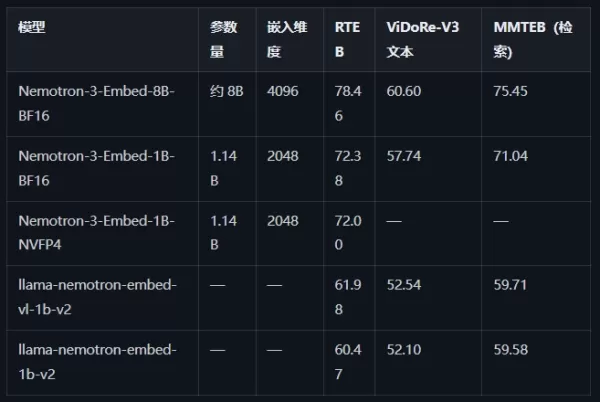
NVIDIA a lancé la série de modèles d'intégration Nemotron-3-Embed destinés à la mise en œuvre en production du RAG, de la recherche de code et de la mémoire d'agent. La version 8B BF16 occupe la première place du benchmark RTEB avec un score de 78,46 NDCG@10. La série comprend des versions 1B BF16 et 1B NVFP4 (4 bits), toutes basées sur l’architecture Mistral, prenant en charge 34 langues et 32 000 tokens. Les modèles 1B ont été créés grâce à l'élagage et à la distillation de connaissances. La version NVFP4 conserve une précision de 99,5 % avec un débit deux fois supérieur sur Blackwell. Elle prend en charge le déploiement vLLM ; les versions BF16 prennent en charge les modèles Transformers et Sentence Transformers.
NVIDIA a lancé la série de modèles d'intégration Nemotron-3-Embed destinés à la mise en œuvre en production du RAG, de la recherche de code et de la mémoire d'agent. La version 8B BF16 occupe la première place du benchmark RTEB avec un score de 78,46 NDCG@10. La série comprend des versions 1B BF16 et 1B NVFP4 (4 bits), toutes basées sur l’architecture Mistral, prenant en charge 34 langues et 32 000 tokens. Les modèles 1B ont été créés grâce à l'élagage et à la distillation de connaissances. La version NVFP4 conserve une précision de 99,5 % avec un débit deux fois supérieur sur Blackwell. Elle prend en charge le déploiement vLLM ; les versions BF16 prennent en charge les modèles Transformers et Sentence Transformers.
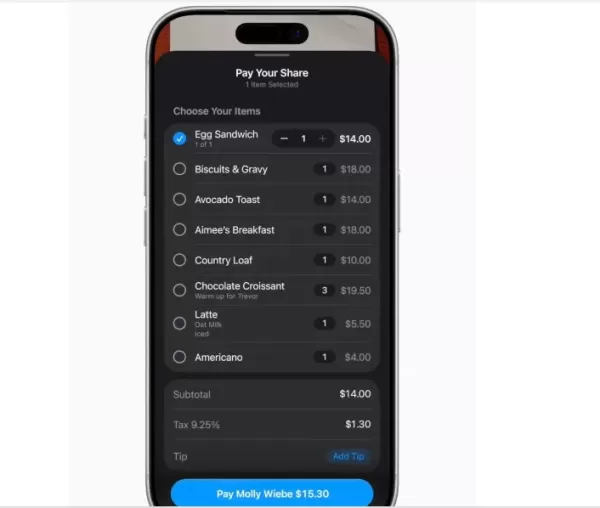
Apple a dévoilé iOS 27 lors de la WWDC, intégrant Apple Intelligence dans les applications natives pour offrir des expériences intelligentes au niveau du système. Parmi les nouvelles fonctionnalités figurent le partage de factures basé sur l'IA via Apple Cash, la mise à jour automatique des mots de passe, les suggestions contextuelles dans Messages, l'extraction du contexte des appels, la création d'événements dans le calendrier en langage naturel et l'organisation intelligente des onglets dans Safari. La version bêta pour développeurs est disponible ; la version bêta publique et la version finale sont attendues cet automne.
Apple a dévoilé iOS 27 lors de la WWDC, intégrant Apple Intelligence dans les applications natives pour offrir des expériences intelligentes au niveau du système. Parmi les nouvelles fonctionnalités figurent le partage de factures basé sur l'IA via Apple Cash, la mise à jour automatique des mots de passe, les suggestions contextuelles dans Messages, l'extraction du contexte des appels, la création d'événements dans le calendrier en langage naturel et l'organisation intelligente des onglets dans Safari. La version bêta pour développeurs est disponible ; la version bêta publique et la version finale sont attendues cet automne.
L'équipe Bing de Microsoft a mis en open source son modèle d'embeddings de mots « Harrier », qui prend en charge plus de 100 langues. Entraîné sur plus de 2 milliards d'exemples et sur des données synthétiques GPT-5 avec un contexte de 32 000 tokens, il est disponible en trois versions pouvant compter jusqu'à 2,7 milliards de paramètres. Ce modèle sera intégré à Bing et aux futurs agents IA afin d'améliorer la recherche et le traitement des données.
L'équipe Bing de Microsoft a mis en open source son modèle d'embeddings de mots « Harrier », qui prend en charge plus de 100 langues. Entraîné sur plus de 2 milliards d'exemples et sur des données synthétiques GPT-5 avec un contexte de 32 000 tokens, il est disponible en trois versions pouvant compter jusqu'à 2,7 milliards de paramètres. Ce modèle sera intégré à Bing et aux futurs agents IA afin d'améliorer la recherche et le traitement des données.
La société d'IA Anthropic est en phase finale de négociations pour lever plus de 20 milliards de dollars dans le cadre d'un tour de table qui devrait être conclu la semaine prochaine. Cette opération permettrait de presque doubler sa valorisation, qui atteindrait environ 350 milliards de dollars, soulignant la forte confiance des investisseurs dans le secteur de l'IA générative. Les fonds serviront à soutenir le développement de modèles dans un contexte de hausse des coûts informatiques et de concurrence intense dans le secteur.
La société d'IA Anthropic est en phase finale de négociations pour lever plus de 20 milliards de dollars dans le cadre d'un tour de table qui devrait être conclu la semaine prochaine. Cette opération permettrait de presque doubler sa valorisation, qui atteindrait environ 350 milliards de dollars, soulignant la forte confiance des investisseurs dans le secteur de l'IA générative. Les fonds serviront à soutenir le développement de modèles dans un contexte de hausse des coûts informatiques et de concurrence intense dans le secteur.


