
옵션
집
속보
콘텐츠
BillyThomas
BillyThomas
2026년 7월 17일

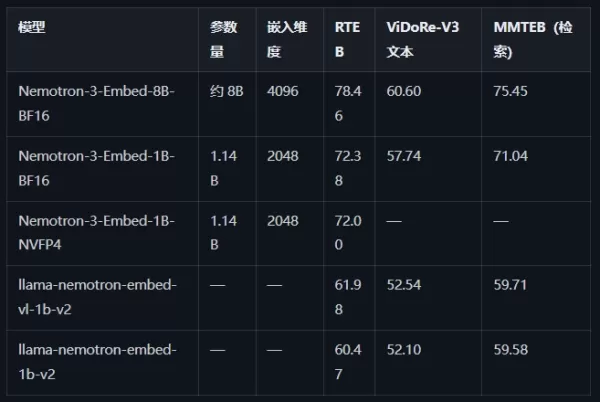
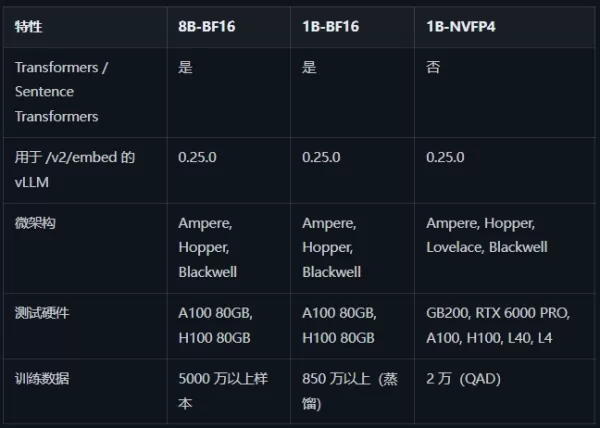
NVIDIA는 실제 환경에서의 RAG, 코드 검색 및 에이전트 메모리를 위한 ‘Nemotron-3-Embed’ 시리즈 임베딩 모델을 출시했습니다. 8B BF16 버전은 RTEB 벤치마크에서 78.46 NDCG@10을 기록하며 1위를 차지했습니다. 이 시리즈에는 1B BF16 및 1B NVFP4(4비트) 버전이 포함되어 있으며, 모두 Mistral 아키텍처를 기반으로 하여 34개 언어와 32K 토큰을 지원합니다. 1B 모델은 프루닝(pruning) 및 지식 증류(knowledge distillation)를 통해 생성되었습니다. NVFP4 버전은 Blackwell에서 2배의 처리량을 유지하면서도 99.5%의 정밀도를 유지합니다. 이 모델은 vLLM 배포를 지원하며, BF16 버전은 Transformers 및 Sentence Transformers를 지원합니다.
NVIDIA는 실제 환경에서의 RAG, 코드 검색 및 에이전트 메모리를 위한 ‘Nemotron-3-Embed’ 시리즈 임베딩 모델을 출시했습니다. 8B BF16 버전은 RTEB 벤치마크에서 78.46 NDCG@10을 기록하며 1위를 차지했습니다. 이 시리즈에는 1B BF16 및 1B NVFP4(4비트) 버전이 포함되어 있으며, 모두 Mistral 아키텍처를 기반으로 하여 34개 언어와 32K 토큰을 지원합니다. 1B 모델은 프루닝(pruning) 및 지식 증류(knowledge distillation)를 통해 생성되었습니다. NVFP4 버전은 Blackwell에서 2배의 처리량을 유지하면서도 99.5%의 정밀도를 유지합니다. 이 모델은 vLLM 배포를 지원하며, BF16 버전은 Transformers 및 Sentence Transformers를 지원합니다. NVIDIA는 실제 환경에서의 RAG, 코드 검색 및 에이전트 메모리를 위한 ‘Nemotron-3-Embed’ 시리즈 임베딩 모델을 출시했습니다. 8B BF16 버전은 RTEB 벤치마크에서 78.46 NDCG@10을 기록하며 1위를 차지했습니다. 이 시리즈에는 1B BF16 및 1B NVFP4(4비트) 버전이 포함되어 있으며, 모두 Mistral 아키텍처를 기반으로 하여 34개 언어와 32K 토큰을 지원합니다. 1B 모델은 프루닝(pruning) 및 지식 증류(knowledge distillation)를 통해 생성되었습니다. NVFP4 버전은 Blackwell에서 2배의 처리량을 유지하면서도 99.5%의 정밀도를 유지합니다. 이 모델은 vLLM 배포를 지원하며, BF16 버전은 Transformers 및 Sentence Transformers를 지원합니다.
의견 (0)
0/300
OR