
opción
Hogar
Última hora
Contenido
BillyThomas
BillyThomas
17 de julio de 2026

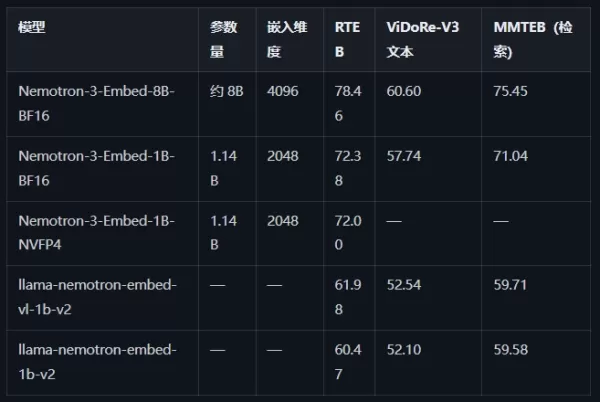
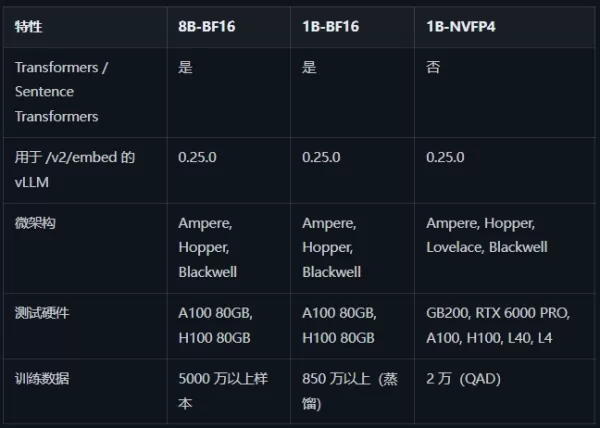
NVIDIA ha lanzado la serie Nemotron-3-Embed de modelos de incrustación para RAG en producción, recuperación de código y memoria de agentes. La versión de 8 000 millones de pesos en BF16 ocupa el primer puesto en el banco de pruebas RTEB con un NDCG@10 de 78,46. La serie incluye versiones de 1 000 millones de pesos en BF16 y de 1 000 millones de pesos en NVFP4 (4 bits), todas basadas en la arquitectura Mistral, que admiten 34 idiomas y 32 000 tokens. Los modelos de 1B se crearon mediante poda y destilación de conocimiento. La versión NVFP4 mantiene una precisión del 99,5 % con el doble de rendimiento en Blackwell. Es compatible con la implementación de vLLM; las versiones BF16 son compatibles con Transformers y Sentence Transformers.
NVIDIA ha lanzado la serie Nemotron-3-Embed de modelos de incrustación para RAG en producción, recuperación de código y memoria de agentes. La versión de 8 000 millones de pesos en BF16 ocupa el primer puesto en el banco de pruebas RTEB con un NDCG@10 de 78,46. La serie incluye versiones de 1 000 millones de pesos en BF16 y de 1 000 millones de pesos en NVFP4 (4 bits), todas basadas en la arquitectura Mistral, que admiten 34 idiomas y 32 000 tokens. Los modelos de 1B se crearon mediante poda y destilación de conocimiento. La versión NVFP4 mantiene una precisión del 99,5 % con el doble de rendimiento en Blackwell. Es compatible con la implementación de vLLM; las versiones BF16 son compatibles con Transformers y Sentence Transformers. NVIDIA ha lanzado la serie Nemotron-3-Embed de modelos de incrustación para RAG en producción, recuperación de código y memoria de agentes. La versión de 8 000 millones de pesos en BF16 ocupa el primer puesto en el banco de pruebas RTEB con un NDCG@10 de 78,46. La serie incluye versiones de 1 000 millones de pesos en BF16 y de 1 000 millones de pesos en NVFP4 (4 bits), todas basadas en la arquitectura Mistral, que admiten 34 idiomas y 32 000 tokens. Los modelos de 1B se crearon mediante poda y destilación de conocimiento. La versión NVFP4 mantiene una precisión del 99,5 % con el doble de rendimiento en Blackwell. Es compatible con la implementación de vLLM; las versiones BF16 son compatibles con Transformers y Sentence Transformers.
comentario (0)
0/300
OR