


 Maison
Zigong et l'université de Tsinghua dévoilent l'architecture réseau ZCube, qui permet d'augmenter de 15 % le débit d'inférence des grands modèles tout en réduisant les coûts réseau d'un tiers
L'inférence sur des modèles de grande taille est en train de redéfinir l'infrastructure de l'IA, et les innovations en matière d'architecture réseau sont désormais essentielles pour exploiter pleinement le potentiel du matériel. En septembre 2025, Zhipu, Yuchen Network et l'université de Tsinghua ont présenté leurs travaux de recherche sur l'architecture réseau ZCube lors de l'ACM SIGCOMM 2025, une conférence de référence dans le domaine des réseaux.
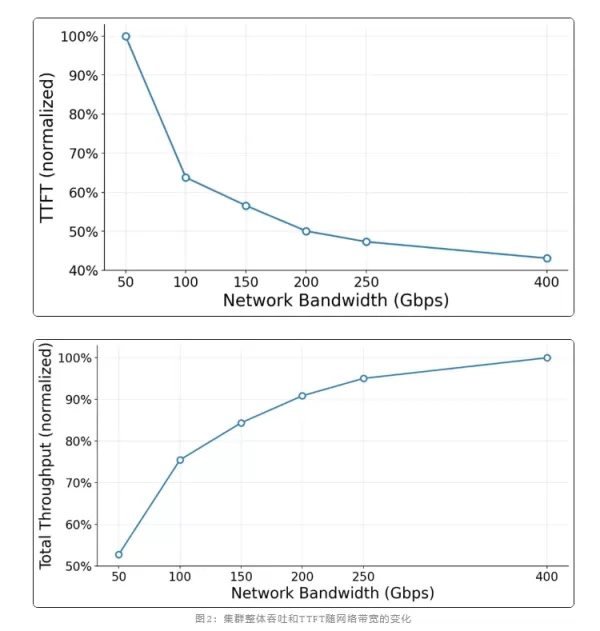
Le 21 mai 2026, Zhipu a annoncé le déploiement réussi de l’architecture ZCube dans l’environnement de production de codage GLM-5.1, ce qui a permis d’obtenir des gains de performances substantiels. Des tests de performance, réalisés avec un matériel GPU, une pile logicielle et des applications inchangés, ont montré que ZCube réduisait les dépenses d’investissement en commutateurs et modules optiques de 33 %, augmentait le débit moyen d’inférence des GPU de 15 % et réduisait la latence du premier token (TTFT P99) de 40,6 %. Cette avancée au niveau du système établit un équilibre entre une grande efficacité économique et des performances élevées.
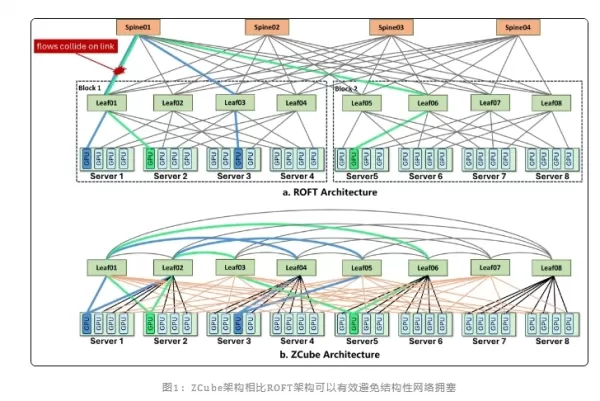
Actuellement, alors que l’inférence à long contexte et le déploiement avec séparation Prefill-Decode (PD) deviennent des normes du secteur, la transmission inter-nœuds du cache KV présente une asymétrie significative. Les architectures ROFT (Rail-Optimized Fat-Tree) traditionnelles, qui reposent sur l’empilement de commutateurs multicouches, sont limitées par une topologie statique, ce qui les rend sujettes aux points chauds locaux et à la contre-pression PFC. Cela crée un goulot d’étranglement structurel où la bande passante totale est suffisante mais où la congestion locale est fréquente.
Pour remédier à ce problème, l’architecture ZCube s’éloigne de l’empilement hiérarchique des conceptions Clos traditionnelles. Elle élimine les commutateurs de la couche « spine » et utilise à la place deux groupes de commutateurs entièrement plats dans une interconnexion de type graphe biparti, combinée au mécanisme d’accès hybride mono/multipiste d’une carte réseau à double port. Grâce à sa stratégie de routage unique, ZCube garantit un chemin optimal dédié pour chaque paire de GPU, permettant ainsi un équilibrage parfait de la charge de trafic au niveau structurel et prenant en charge une expansion à très grande échelle pouvant atteindre des dizaines, voire des centaines de milliers de GPU.
Au cours de la transformation de l’environnement de production, l’équipe de Yuchen Network a relevé avec succès les défis liés au câblage et à la reconstruction de la stratégie de routage à l’aide d’outils automatisés de contrôle et de vérification, garantissant ainsi une mise à niveau rapide et stable du cluster. Le cluster actuel, composé de mille cartes, fonctionne de manière stable depuis plus de deux semaines. Le déploiement réussi de ZCube marque une évolution de l’infrastructure de calcul intelligent, passant d’une interconnexion générale à une collaboration entre systèmes pilotée par le trafic des modèles. À l’avenir, l’intégration profonde de la topologie réseau, des bibliothèques de communication et des stratégies d’ordonnancement deviendra le moteur principal permettant d’améliorer encore l’efficacité de la production de jetons et de réduire les coûts globaux du MaaS.
Article connexe
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Comment corriger les Core Web Vitals pour de meilleurs classements SEO
Fluidifiez les commentaires de bulletin avec des outils d'IAIntroductionOutils d'IA pour générer des commentaires de bulletinMagic SchoolAlmanac AIChat GPTUtilisation de Magic School pour générer des commentaires de bulletinConnexion à Magic Sc
Recommandations de sujets spéciaux liés
en écrivant
 Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
 8 outils
 xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

 commentaires (0)
L'inférence sur des modèles de grande taille est en train de redéfinir l'infrastructure de l'IA, et les innovations en matière d'architecture réseau sont désormais essentielles pour exploiter pleinement le potentiel du matériel. En septembre 2025, Zhipu, Yuchen Network et l'université de Tsinghua ont présenté leurs travaux de recherche sur l'architecture réseau ZCube lors de l'ACM SIGCOMM 2025, une conférence de référence dans le domaine des réseaux.
Le 21 mai 2026, Zhipu a annoncé le déploiement réussi de l’architecture ZCube dans l’environnement de production de codage GLM-5.1, ce qui a permis d’obtenir des gains de performances substantiels. Des tests de performance, réalisés avec un matériel GPU, une pile logicielle et des applications inchangés, ont montré que ZCube réduisait les dépenses d’investissement en commutateurs et modules optiques de 33 %, augmentait le débit moyen d’inférence des GPU de 15 % et réduisait la latence du premier token (TTFT P99) de 40,6 %. Cette avancée au niveau du système établit un équilibre entre une grande efficacité économique et des performances élevées.
Actuellement, alors que l’inférence à long contexte et le déploiement avec séparation Prefill-Decode (PD) deviennent des normes du secteur, la transmission inter-nœuds du cache KV présente une asymétrie significative. Les architectures ROFT (Rail-Optimized Fat-Tree) traditionnelles, qui reposent sur l’empilement de commutateurs multicouches, sont limitées par une topologie statique, ce qui les rend sujettes aux points chauds locaux et à la contre-pression PFC. Cela crée un goulot d’étranglement structurel où la bande passante totale est suffisante mais où la congestion locale est fréquente.
Pour remédier à ce problème, l’architecture ZCube s’éloigne de l’empilement hiérarchique des conceptions Clos traditionnelles. Elle élimine les commutateurs de la couche « spine » et utilise à la place deux groupes de commutateurs entièrement plats dans une interconnexion de type graphe biparti, combinée au mécanisme d’accès hybride mono/multipiste d’une carte réseau à double port. Grâce à sa stratégie de routage unique, ZCube garantit un chemin optimal dédié pour chaque paire de GPU, permettant ainsi un équilibrage parfait de la charge de trafic au niveau structurel et prenant en charge une expansion à très grande échelle pouvant atteindre des dizaines, voire des centaines de milliers de GPU.
Au cours de la transformation de l’environnement de production, l’équipe de Yuchen Network a relevé avec succès les défis liés au câblage et à la reconstruction de la stratégie de routage à l’aide d’outils automatisés de contrôle et de vérification, garantissant ainsi une mise à niveau rapide et stable du cluster. Le cluster actuel, composé de mille cartes, fonctionne de manière stable depuis plus de deux semaines. Le déploiement réussi de ZCube marque une évolution de l’infrastructure de calcul intelligent, passant d’une interconnexion générale à une collaboration entre systèmes pilotée par le trafic des modèles. À l’avenir, l’intégration profonde de la topologie réseau, des bibliothèques de communication et des stratégies d’ordonnancement deviendra le moteur principal permettant d’améliorer encore l’efficacité de la production de jetons et de réduire les coûts globaux du MaaS.








 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
 Comment corriger les Core Web Vitals pour de meilleurs classements SEO
Fluidifiez les commentaires de bulletin avec des outils d'IAIntroductionOutils d'IA pour générer des commentaires de bulletinMagic SchoolAlmanac AIChat GPTUtilisation de Magic School pour générer des commentaires de bulletinConnexion à Magic Sc

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai












