


 Lar
Zigong e a Universidade de Tsinghua apresentam a arquitetura de rede ZCube, que aumenta a taxa de processamento de inferência de modelos de grande porte em 15% e, ao mesmo tempo, reduz os custos de rede em um terço
A inferência de modelos de grande porte está remodelando a infraestrutura de IA, e as inovações na arquitetura de rede são agora fundamentais para explorar o potencial do hardware. Em setembro de 2025, a Zhipu, a Yuchen Network e a Universidade de Tsinghua apresentaram sua pesquisa sobre a arquitetura de rede ZCube na ACM SIGCOMM 2025, uma das principais conferências na área de redes.
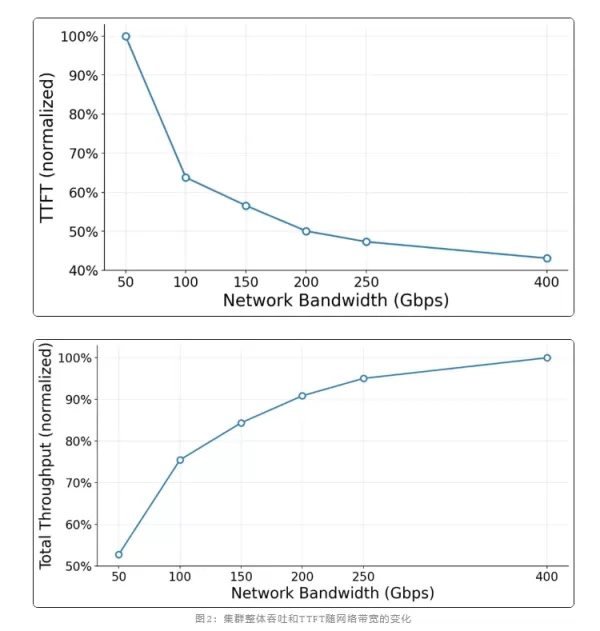
Em 21 de maio de 2026, a Zhipu anunciou a implantação bem-sucedida da arquitetura ZCube no ambiente de produção de codificação GLM-5.1, resultando em ganhos substanciais de desempenho. Testes de benchmark, realizados com hardware de GPU, pilha de software e aplicativos inalterados, mostraram que o ZCube reduziu os gastos de capital com switches e módulos ópticos em 33%, aumentou a taxa de processamento média de inferência da GPU em 15% e reduziu a latência do primeiro token (TTFT P99) em 40,6%. Essa inovação em nível de sistema alcança um equilíbrio entre alta eficiência econômica e alto desempenho.
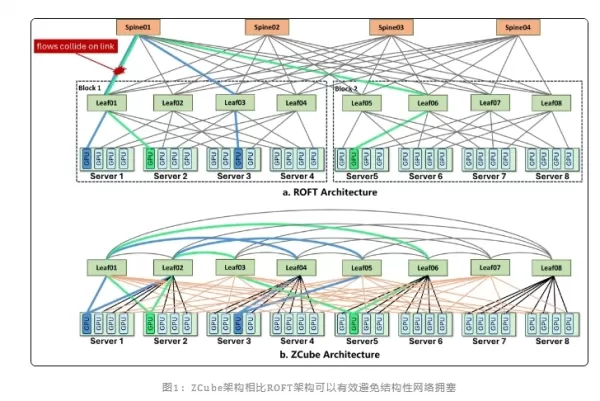
Atualmente, com a inferência de contexto longo e a implantação da separação Prefill-Decode (PD) se tornando padrões do setor, a transmissão entre nós do cache KV apresenta uma assimetria significativa. As arquiteturas ROFT (Rail-Optimized Fat-Tree) tradicionais, que dependem do empilhamento de switches em múltiplas camadas, são limitadas pela topologia estática, tornando-as propensas a pontos de congestionamento locais e contrapressão do PFC. Isso cria um gargalo estrutural em que a largura de banda total é suficiente, mas o congestionamento local é frequente.
Para resolver esse ponto crítico, a arquitetura ZCube se afasta do empilhamento hierárquico dos projetos Clos tradicionais. Ela elimina os switches da camada Spine e, em vez disso, utiliza dois grupos de switches totalmente planos em uma interconexão de grafo bipartido, combinada com o mecanismo de acesso híbrido de trilha única/múltipla de uma placa de rede (NIC) de porta dupla. Por meio de sua estratégia de roteamento exclusiva, o ZCube garante um caminho ideal dedicado para qualquer par de GPUs, alcançando um balanceamento de carga de tráfego perfeito no nível estrutural e suportando expansão em escala ultragrande para dezenas de milhares ou até centenas de milhares de GPUs.
Durante a transformação do ambiente de produção, a equipe da Yuchen Network superou com sucesso os desafios de recabeamento e reconstrução da estratégia de rotas utilizando ferramentas automatizadas de controle e verificação, garantindo uma atualização rápida e estável do cluster. O atual cluster de mil placas vem operando de forma estável há mais de duas semanas. A implantação bem-sucedida do ZCube marca uma mudança na infraestrutura de computação inteligente, passando da interconexão geral para a colaboração entre sistemas impulsionada pelo tráfego de modelos. No futuro, a integração profunda entre topologia de rede, bibliotecas de comunicação e estratégias de agendamento se tornará o principal impulsionador para melhorar ainda mais a eficiência na produção de tokens e reduzir os custos gerais do MaaS.
Artigo relacionado
 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Como corrigir as Core Web Vitals para melhorar o ranqueamento de SEO
Simplifique os Comentários do Boletim Escolar com Ferramentas de IAIntroduçãoFerramentas de IA para Gerar Comentários do Boletim EscolarMagic SchoolAlmanac AIChat GPTUsando o Magic School para Gerar Comentários do Boletim EscolarFazendo login n
Recomendações de tópicos especiais relacionados
escrita
 Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
 8 ferramentas
 xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

 Comentários (0)
A inferência de modelos de grande porte está remodelando a infraestrutura de IA, e as inovações na arquitetura de rede são agora fundamentais para explorar o potencial do hardware. Em setembro de 2025, a Zhipu, a Yuchen Network e a Universidade de Tsinghua apresentaram sua pesquisa sobre a arquitetura de rede ZCube na ACM SIGCOMM 2025, uma das principais conferências na área de redes.
Em 21 de maio de 2026, a Zhipu anunciou a implantação bem-sucedida da arquitetura ZCube no ambiente de produção de codificação GLM-5.1, resultando em ganhos substanciais de desempenho. Testes de benchmark, realizados com hardware de GPU, pilha de software e aplicativos inalterados, mostraram que o ZCube reduziu os gastos de capital com switches e módulos ópticos em 33%, aumentou a taxa de processamento média de inferência da GPU em 15% e reduziu a latência do primeiro token (TTFT P99) em 40,6%. Essa inovação em nível de sistema alcança um equilíbrio entre alta eficiência econômica e alto desempenho.
Atualmente, com a inferência de contexto longo e a implantação da separação Prefill-Decode (PD) se tornando padrões do setor, a transmissão entre nós do cache KV apresenta uma assimetria significativa. As arquiteturas ROFT (Rail-Optimized Fat-Tree) tradicionais, que dependem do empilhamento de switches em múltiplas camadas, são limitadas pela topologia estática, tornando-as propensas a pontos de congestionamento locais e contrapressão do PFC. Isso cria um gargalo estrutural em que a largura de banda total é suficiente, mas o congestionamento local é frequente.
Para resolver esse ponto crítico, a arquitetura ZCube se afasta do empilhamento hierárquico dos projetos Clos tradicionais. Ela elimina os switches da camada Spine e, em vez disso, utiliza dois grupos de switches totalmente planos em uma interconexão de grafo bipartido, combinada com o mecanismo de acesso híbrido de trilha única/múltipla de uma placa de rede (NIC) de porta dupla. Por meio de sua estratégia de roteamento exclusiva, o ZCube garante um caminho ideal dedicado para qualquer par de GPUs, alcançando um balanceamento de carga de tráfego perfeito no nível estrutural e suportando expansão em escala ultragrande para dezenas de milhares ou até centenas de milhares de GPUs.
Durante a transformação do ambiente de produção, a equipe da Yuchen Network superou com sucesso os desafios de recabeamento e reconstrução da estratégia de rotas utilizando ferramentas automatizadas de controle e verificação, garantindo uma atualização rápida e estável do cluster. O atual cluster de mil placas vem operando de forma estável há mais de duas semanas. A implantação bem-sucedida do ZCube marca uma mudança na infraestrutura de computação inteligente, passando da interconexão geral para a colaboração entre sistemas impulsionada pelo tráfego de modelos. No futuro, a integração profunda entre topologia de rede, bibliotecas de comunicação e estratégias de agendamento se tornará o principal impulsionador para melhorar ainda mais a eficiência na produção de tokens e reduzir os custos gerais do MaaS.








 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
 Como corrigir as Core Web Vitals para melhorar o ranqueamento de SEO
Simplifique os Comentários do Boletim Escolar com Ferramentas de IAIntroduçãoFerramentas de IA para Gerar Comentários do Boletim EscolarMagic SchoolAlmanac AIChat GPTUsando o Magic School para Gerar Comentários do Boletim EscolarFazendo login n

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai












