


 Hogar
Zigong y la Universidad de Tsinghua presentan la arquitectura de red ZCube, que aumenta el rendimiento de la inferencia de modelos de gran tamaño en un 15 % y reduce los costes de red en un tercio
La inferencia de modelos a gran escala está transformando la infraestructura de la IA, y las innovaciones en la arquitectura de redes son ahora fundamentales para aprovechar al máximo el potencial del hardware. En septiembre de 2025, Zhipu, Yuchen Network y la Universidad de Tsinghua presentaron su investigación sobre la arquitectura de red ZCube en ACM SIGCOMM 2025, una conferencia líder en el ámbito de las redes.
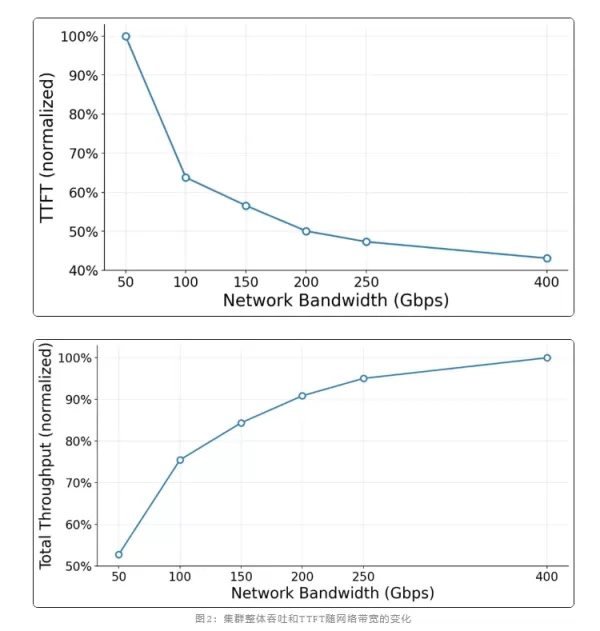
El 21 de mayo de 2026, Zhipu anunció el éxito en la implementación de la arquitectura ZCube en el entorno de producción de codificación GLM-5.1, lo que se tradujo en una mejora sustancial del rendimiento. Las pruebas de rendimiento, realizadas sin modificar el hardware de la GPU, la pila de software ni las aplicaciones, demostraron que ZCube redujo el gasto de capital en conmutadores y módulos ópticos en un 33 %, aumentó el rendimiento medio de inferencia de la GPU en un 15 % y redujo la latencia del primer token (TTFT P99) en un 40,6 %. Este avance a nivel de sistema logra un equilibrio entre una alta eficiencia económica y un alto rendimiento.
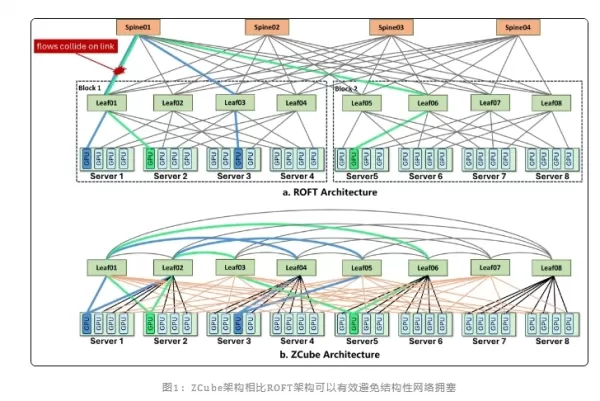
Actualmente, dado que la inferencia de contexto largo y la separación entre Prefill y Decode (PD) se están convirtiendo en estándares del sector, la transmisión entre nodos de la caché KV presenta una asimetría significativa. Las arquitecturas ROFT (Rail-Optimized Fat-Tree) tradicionales, que se basan en el apilamiento de conmutadores multicapa, se ven limitadas por una topología estática, lo que las hace propensas a la aparición de puntos de congestión locales y a la contrapresión del PFC. Esto crea un cuello de botella estructural en el que el ancho de banda total es suficiente, pero la congestión local es frecuente.
Para abordar este punto débil, la arquitectura ZCube se aleja del apilamiento jerárquico de los diseños Clos tradicionales. Elimina los conmutadores de la capa «Spine» y, en su lugar, utiliza dos grupos de conmutadores totalmente planos en una interconexión de grafo bipartito, combinada con el mecanismo de acceso híbrido de una o varias vías de una tarjeta de red de doble puerto. Gracias a su estrategia de enrutamiento única, ZCube garantiza una ruta óptima dedicada para cualquier par de GPU, logrando un equilibrio perfecto de la carga de tráfico a nivel estructural y permitiendo una expansión a gran escala hasta decenas de miles o incluso cientos de miles de GPU.
Durante la transformación del entorno de producción, el equipo de Yuchen Network superó con éxito los retos del cableado y la reconstrucción de la estrategia de rutas mediante herramientas automatizadas de control y verificación, lo que garantizó una actualización rápida y estable del clúster. El clúster actual, compuesto por mil tarjetas, lleva más de dos semanas funcionando de forma estable. El éxito en la implementación de ZCube marca un cambio en la infraestructura de computación inteligente, que pasa de una interconexión general a una colaboración entre sistemas impulsada por el tráfico de modelos. En el futuro, la profunda integración de la topología de red, las bibliotecas de comunicación y las estrategias de programación se convertirá en el motor principal para seguir mejorando la eficiencia en la producción de tokens y reducir los costes generales del MaaS.
Artículo relacionado
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (0)
0/500
La inferencia de modelos a gran escala está transformando la infraestructura de la IA, y las innovaciones en la arquitectura de redes son ahora fundamentales para aprovechar al máximo el potencial del hardware. En septiembre de 2025, Zhipu, Yuchen Network y la Universidad de Tsinghua presentaron su investigación sobre la arquitectura de red ZCube en ACM SIGCOMM 2025, una conferencia líder en el ámbito de las redes.
El 21 de mayo de 2026, Zhipu anunció el éxito en la implementación de la arquitectura ZCube en el entorno de producción de codificación GLM-5.1, lo que se tradujo en una mejora sustancial del rendimiento. Las pruebas de rendimiento, realizadas sin modificar el hardware de la GPU, la pila de software ni las aplicaciones, demostraron que ZCube redujo el gasto de capital en conmutadores y módulos ópticos en un 33 %, aumentó el rendimiento medio de inferencia de la GPU en un 15 % y redujo la latencia del primer token (TTFT P99) en un 40,6 %. Este avance a nivel de sistema logra un equilibrio entre una alta eficiencia económica y un alto rendimiento.
Actualmente, dado que la inferencia de contexto largo y la separación entre Prefill y Decode (PD) se están convirtiendo en estándares del sector, la transmisión entre nodos de la caché KV presenta una asimetría significativa. Las arquitecturas ROFT (Rail-Optimized Fat-Tree) tradicionales, que se basan en el apilamiento de conmutadores multicapa, se ven limitadas por una topología estática, lo que las hace propensas a la aparición de puntos de congestión locales y a la contrapresión del PFC. Esto crea un cuello de botella estructural en el que el ancho de banda total es suficiente, pero la congestión local es frecuente.
Para abordar este punto débil, la arquitectura ZCube se aleja del apilamiento jerárquico de los diseños Clos tradicionales. Elimina los conmutadores de la capa «Spine» y, en su lugar, utiliza dos grupos de conmutadores totalmente planos en una interconexión de grafo bipartito, combinada con el mecanismo de acceso híbrido de una o varias vías de una tarjeta de red de doble puerto. Gracias a su estrategia de enrutamiento única, ZCube garantiza una ruta óptima dedicada para cualquier par de GPU, logrando un equilibrio perfecto de la carga de tráfico a nivel estructural y permitiendo una expansión a gran escala hasta decenas de miles o incluso cientos de miles de GPU.
Durante la transformación del entorno de producción, el equipo de Yuchen Network superó con éxito los retos del cableado y la reconstrucción de la estrategia de rutas mediante herramientas automatizadas de control y verificación, lo que garantizó una actualización rápida y estable del clúster. El clúster actual, compuesto por mil tarjetas, lleva más de dos semanas funcionando de forma estable. El éxito en la implementación de ZCube marca un cambio en la infraestructura de computación inteligente, que pasa de una interconexión general a una colaboración entre sistemas impulsada por el tráfico de modelos. En el futuro, la profunda integración de la topología de red, las bibliotecas de comunicación y las estrategias de programación se convertirá en el motor principal para seguir mejorando la eficiencia en la producción de tokens y reducir los costes generales del MaaS.








 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
 Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai












