


 Maison
Débloquer 99 % des données cachées désormais optimisées pour l'IA
Depuis des générations, les entreprises de tous les secteurs ont compris que les informations qu'elles accumulent représentent un atout transformateur, capable d'améliorer les interactions avec les clients et d'élaborer des stratégies commerciales basées sur les données avec une précision inégalée.
Aujourd'hui, alors que l'intelligence artificielle passe d'un potentiel théorique à des solutions commerciales pratiques, la valeur stratégique des données d'entreprise a atteint des sommets sans précédent. Cependant, pour libérer cette valeur, il faut accorder une attention méticuleuse à l'infrastructure des données, depuis la collecte et le nettoyage systématiques jusqu'aux protocoles de gouvernance rigoureux qui répondent aux préoccupations en matière de confidentialité, de conformité réglementaire et de sécurité, et ce dès le premier jour.
Lors d'une discussion exclusive avec Henrique Lemes, Americas Data Platform Leader d'IBM, nous avons examiné les réalités complexes auxquelles les entreprises sont confrontées lorsqu'elles mettent en œuvre l'IA dans le cadre de divers scénarios commerciaux. Notre conversation a commencé par un examen fondamental de la taxonomie des données et de sa relation critique avec une mise en œuvre efficace de l'IA.
M. Henrique a souligné que le terme général de "données" ne rend pas compte de la réalité multiforme des systèmes d'information des entreprises. Les organisations contemporaines doivent naviguer dans un écosystème complexe de formats de données disparates avec différents degrés d'intégrité structurelle - en particulier lorsqu'il s'agit de faire le lien entre les référentiels d'informations structurées et non structurées.
Les données structurées représentent des informations organisées dans des formats normalisés et lisibles par les machines, conçues pour un traitement informatique et des opérations analytiques efficaces.
À l'inverse, les données non structurées englobent les informations qui ne sont pas organisées de manière systématique, ce qui pose des problèmes de traitement beaucoup plus importants. Cette catégorie comprend diverses ressources numériques allant des communications par courrier électronique et du contenu multimédia aux interactions avec les médias sociaux et aux archives de documents. Bien que plus complexes à analyser, ces sources contiennent des informations commerciales inestimables qui, lorsqu'elles sont correctement exploitées, peuvent stimuler l'innovation et éclairer des décisions stratégiques cruciales.
"Actuellement, les systèmes d'IA d'entreprise utilisent moins de 1 % des données organisationnelles disponibles", observe M. Henrique. "Le contenu non structuré constituant plus de 90 % de ces informations négligées, nous sommes confrontés à des défis fondamentaux en matière de fiabilité et d'utilité des données."
Le facteur de confiance dans les données d'entreprise représente une considération critique. Les chefs d'entreprise ont besoin d'une confiance absolue dans l'exhaustivité, l'exactitude et l'origine éthique de leurs informations. Pourtant, la recherche indique que moins de la moitié des ressources de données disponibles sont exploitées pour des applications d'IA, le contenu non structuré étant souvent exclu en raison de la complexité du traitement et des défis de vérification de la conformité - en particulier à l'échelle industrielle.
"Passer d'une utilisation sélective des données à une utilisation complète des informations nécessite de convertir les flux gérables d'aujourd'hui en pipelines à haut volume", a expliqué Henrique, notant que si les systèmes d'ingestion automatisés fournissent la solution, ils doivent intégrer des cadres de gouvernance robustes applicables à tous les types de données.
M. Henrique a décrit trois processus fondamentaux qui permettent de libérer la valeur des données pour l'entreprise : "Premièrement, mettre en place des capacités d'ingestion automatisées et à haut volume. Deuxièmement, mettre en œuvre des protocoles rigoureux de curation et de gouvernance. Enfin, rendre ces ressources générativement accessibles à l'IA. Cette approche permet d'obtenir un retour sur investissement supérieur de plus de 40 % par rapport aux mises en œuvre conventionnelles de RAG."
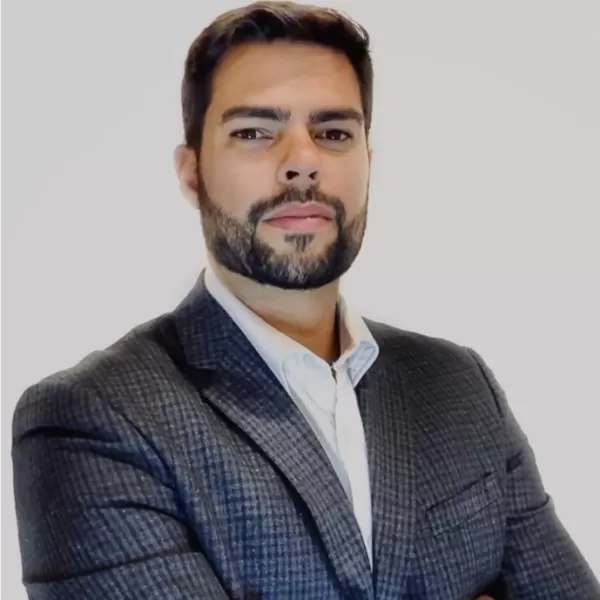
IBM propose une solution intégrée combinant des conseils stratégiques et une infrastructure technique avancée. Cela permet aux organisations de transformer systématiquement toutes les catégories de données en actifs prêts pour l'IA tout en maintenant une stricte conformité avec les structures de gouvernance existantes. "Nous coordonnons le personnel, les processus et les écosystèmes technologiques", a noté Henrique. "Bien qu'intrinsèquement complexe, nous rendons cela gérable grâce à un alignement complet des ressources."
Au fur et à mesure que les entreprises évoluent, leurs écosystèmes de données augmentent à la fois en volume et en complexité, ce qui exige des cadres d'ingestion de l'IA tout aussi adaptables. "Les défis de mise à l'échelle apparaissent lorsque des solutions d'IA conçues pour des applications étroites tentent une mise en œuvre plus large", explique M. Henrique. "Soudain, les architectures de pipeline deviennent lourdes, la gestion des données non structurées devient impérative et les exigences en matière de gouvernance s'intensifient."
La méthodologie d'IBM consiste à cartographier le parcours d'adoption de l'IA de chaque client, en établissant des jalons clairs pour la réalisation du retour sur investissement. "Nous mettons l'accent sur l'exactitude des données dans tous les formats, associée à des capacités complètes d'ingestion, de suivi du lignage, de conformité réglementaire et de surveillance. L'ensemble de ces éléments permet des mises en œuvre évolutives et multi-cas d'utilisation qui maximisent la valeur des actifs de données."
Comme toute mise en œuvre technologique importante, la création de pipelines de données efficaces nécessite du temps, une sélection appropriée des outils et une planification architecturale tournée vers l'avenir. IBM fournit aux entreprises - y compris aux institutions mondiales les plus rigoureusement réglementées - des outils robustes pour le déploiement de l'IA à toute échelle, ce qui en fait un leader de l'industrie pour les mises en œuvre critiques.
Article connexe
 Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
Le géant indien du logiciel réduit ses embauches et promet des licenciements nuls à mesure que les agents IA se développent
Alors que l’intelligence artificielle redéfinit les modèles d’affaires traditionnellement intensifs en main-d’œuvre, Tata Consultancy Services (TCS), l’un des principaux prestataires indiens de sous-traitance logicielle, a dévoilé sa réponse stratégi
La Chine verrouille les modèles d'IA pendant le Gaokao pour bloquer l'aide instantanée aux devoirs
Avec l’approche rapide du Gaokao 2026, les rumeurs concernant la suspension des outils d’intelligence artificielle pendant la période d’examen ont déclenché un intense débat en ligne. En réponse aux préoccupations du public, les principales plateform
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
 9 outils
 xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai
Conception et art
Meilleurs outils d’idéation créative par IA pour les artistes : surmonter les blocages visuels
2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai
Composition musicale
Créateurs de musique par IA pour les pistes d'accompagnement TikTok, les fichiers audio Reels et la musique promotionnelle des créateurs
Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

 commentaires (1)
![DavidRodriguez]()
Okay, das klingt nach dem ewigen Versprechen: '99% der versteckten Daten freischalten'? Viele Firmen können noch nicht mal ihre strukturierten Daten richtig nutzen. Trotzdem, wenn KI wirklich dabei hilft, das 'Chaos' zu durchforsten, wäre das ein echter Game-Changer. Hoffentlich geht es dabei nicht nur um Marketing-Buzzwords, sondern um praktische Anwendung. Ich frage mich, wie das mit den ganzen ethischen Fragen und der Datensicherheit aussieht. ❤️
Depuis des générations, les entreprises de tous les secteurs ont compris que les informations qu'elles accumulent représentent un atout transformateur, capable d'améliorer les interactions avec les clients et d'élaborer des stratégies commerciales basées sur les données avec une précision inégalée.
Aujourd'hui, alors que l'intelligence artificielle passe d'un potentiel théorique à des solutions commerciales pratiques, la valeur stratégique des données d'entreprise a atteint des sommets sans précédent. Cependant, pour libérer cette valeur, il faut accorder une attention méticuleuse à l'infrastructure des données, depuis la collecte et le nettoyage systématiques jusqu'aux protocoles de gouvernance rigoureux qui répondent aux préoccupations en matière de confidentialité, de conformité réglementaire et de sécurité, et ce dès le premier jour.
Lors d'une discussion exclusive avec Henrique Lemes, Americas Data Platform Leader d'IBM, nous avons examiné les réalités complexes auxquelles les entreprises sont confrontées lorsqu'elles mettent en œuvre l'IA dans le cadre de divers scénarios commerciaux. Notre conversation a commencé par un examen fondamental de la taxonomie des données et de sa relation critique avec une mise en œuvre efficace de l'IA.
M. Henrique a souligné que le terme général de "données" ne rend pas compte de la réalité multiforme des systèmes d'information des entreprises. Les organisations contemporaines doivent naviguer dans un écosystème complexe de formats de données disparates avec différents degrés d'intégrité structurelle - en particulier lorsqu'il s'agit de faire le lien entre les référentiels d'informations structurées et non structurées.
Les données structurées représentent des informations organisées dans des formats normalisés et lisibles par les machines, conçues pour un traitement informatique et des opérations analytiques efficaces.
À l'inverse, les données non structurées englobent les informations qui ne sont pas organisées de manière systématique, ce qui pose des problèmes de traitement beaucoup plus importants. Cette catégorie comprend diverses ressources numériques allant des communications par courrier électronique et du contenu multimédia aux interactions avec les médias sociaux et aux archives de documents. Bien que plus complexes à analyser, ces sources contiennent des informations commerciales inestimables qui, lorsqu'elles sont correctement exploitées, peuvent stimuler l'innovation et éclairer des décisions stratégiques cruciales.
"Actuellement, les systèmes d'IA d'entreprise utilisent moins de 1 % des données organisationnelles disponibles", observe M. Henrique. "Le contenu non structuré constituant plus de 90 % de ces informations négligées, nous sommes confrontés à des défis fondamentaux en matière de fiabilité et d'utilité des données."
Le facteur de confiance dans les données d'entreprise représente une considération critique. Les chefs d'entreprise ont besoin d'une confiance absolue dans l'exhaustivité, l'exactitude et l'origine éthique de leurs informations. Pourtant, la recherche indique que moins de la moitié des ressources de données disponibles sont exploitées pour des applications d'IA, le contenu non structuré étant souvent exclu en raison de la complexité du traitement et des défis de vérification de la conformité - en particulier à l'échelle industrielle.
"Passer d'une utilisation sélective des données à une utilisation complète des informations nécessite de convertir les flux gérables d'aujourd'hui en pipelines à haut volume", a expliqué Henrique, notant que si les systèmes d'ingestion automatisés fournissent la solution, ils doivent intégrer des cadres de gouvernance robustes applicables à tous les types de données.
M. Henrique a décrit trois processus fondamentaux qui permettent de libérer la valeur des données pour l'entreprise : "Premièrement, mettre en place des capacités d'ingestion automatisées et à haut volume. Deuxièmement, mettre en œuvre des protocoles rigoureux de curation et de gouvernance. Enfin, rendre ces ressources générativement accessibles à l'IA. Cette approche permet d'obtenir un retour sur investissement supérieur de plus de 40 % par rapport aux mises en œuvre conventionnelles de RAG."
IBM propose une solution intégrée combinant des conseils stratégiques et une infrastructure technique avancée. Cela permet aux organisations de transformer systématiquement toutes les catégories de données en actifs prêts pour l'IA tout en maintenant une stricte conformité avec les structures de gouvernance existantes. "Nous coordonnons le personnel, les processus et les écosystèmes technologiques", a noté Henrique. "Bien qu'intrinsèquement complexe, nous rendons cela gérable grâce à un alignement complet des ressources."
Au fur et à mesure que les entreprises évoluent, leurs écosystèmes de données augmentent à la fois en volume et en complexité, ce qui exige des cadres d'ingestion de l'IA tout aussi adaptables. "Les défis de mise à l'échelle apparaissent lorsque des solutions d'IA conçues pour des applications étroites tentent une mise en œuvre plus large", explique M. Henrique. "Soudain, les architectures de pipeline deviennent lourdes, la gestion des données non structurées devient impérative et les exigences en matière de gouvernance s'intensifient."
La méthodologie d'IBM consiste à cartographier le parcours d'adoption de l'IA de chaque client, en établissant des jalons clairs pour la réalisation du retour sur investissement. "Nous mettons l'accent sur l'exactitude des données dans tous les formats, associée à des capacités complètes d'ingestion, de suivi du lignage, de conformité réglementaire et de surveillance. L'ensemble de ces éléments permet des mises en œuvre évolutives et multi-cas d'utilisation qui maximisent la valeur des actifs de données."
Comme toute mise en œuvre technologique importante, la création de pipelines de données efficaces nécessite du temps, une sélection appropriée des outils et une planification architecturale tournée vers l'avenir. IBM fournit aux entreprises - y compris aux institutions mondiales les plus rigoureusement réglementées - des outils robustes pour le déploiement de l'IA à toute échelle, ce qui en fait un leader de l'industrie pour les mises en œuvre critiques.








 Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
 Le géant indien du logiciel réduit ses embauches et promet des licenciements nuls à mesure que les agents IA se développent
Alors que l’intelligence artificielle redéfinit les modèles d’affaires traditionnellement intensifs en main-d’œuvre, Tata Consultancy Services (TCS), l’un des principaux prestataires indiens de sous-traitance logicielle, a dévoilé sa réponse stratégi
 La Chine verrouille les modèles d'IA pendant le Gaokao pour bloquer l'aide instantanée aux devoirs
Avec l’approche rapide du Gaokao 2026, les rumeurs concernant la suspension des outils d’intelligence artificielle pendant la période d’examen ont déclenché un intense débat en ligne. En réponse aux préoccupations du public, les principales plateform

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai

Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

Okay, das klingt nach dem ewigen Versprechen: '99% der versteckten Daten freischalten'? Viele Firmen können noch nicht mal ihre strukturierten Daten richtig nutzen. Trotzdem, wenn KI wirklich dabei hilft, das 'Chaos' zu durchforsten, wäre das ein echter Game-Changer. Hoffentlich geht es dabei nicht nur um Marketing-Buzzwords, sondern um praktische Anwendung. Ich frage mich, wie das mit den ganzen ethischen Fragen und der Datensicherheit aussieht. ❤️












