


 Maison
La course aux capacités de calcul IA : Cerebras est-elle la prochaine grande innovation ?
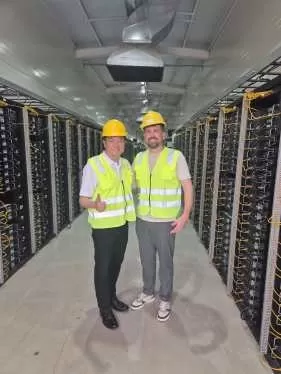
La demande croissante de puissance de calcul pour exécuter des modèles d’IA s’intensifie continuellement, mais les acteurs du secteur font face à deux obstacles majeurs : obtenir le matériel approprié et le déployer dans des centres de données pour commencer à générer des revenus.
General Compute, un nouveau fournisseur de necloud axé sur l’inférence et spécialisé dans la phase de déploiement où les modèles répondent aux utilisateurs plutôt que d’être formés, propose des solutions qui mettent en évidence l’évolution de l’écosystème de l’IA. Ces avantages stratégiques ont permis une levée de fonds initiale de 15 millions de dollars, évaluant l’entreprise à 60 millions de dollars après investissement, dirigée par FUSE VC, avec la participation supplémentaire de Carya Venture Partners et Village Global Ventures.
Identifier la puce optimale est le premier défi. Bien que la demande de GPU ait explosé, il est de plus en plus reconnu qu’ils ne constituent pas le choix le plus efficace pour exécuter des modèles d’IA entraînés. Les exigences computationnelles de l’inférence diffèrent considérablement de celles de l’entraînement, ce qui a conduit au développement d’une nouvelle classe de puces conçues spécifiquement à cet effet. L’acquisition de Groq par Nvidia pour 20 milliards de dollars en décembre et le IPO de Cerebras pour 57 milliards de dollars la semaine dernière soulignent ce changement.
Avec des contraintes de capacité chez Groq et Cerebras, les cofondateurs de General Compute, le PDG Finn Puklowski et le CTO Jason Goodison, ont identifié une alternative. Ils se sont associés à SambaNova, un fabricant de puces soutenu par Intel et spécialisé dans les solutions d’inférence, qui a reçu moins d’attention à Silicon Valley.
Cette dynamique pourrait changer lorsque SambaNova lancera ses nouvelles puces plus tard cette année. L’architecture offre une plus grande flexibilité et utilise davantage de mémoire pour stocker le contexte lors des calculs d’inférence. SambaNova affirme que ces puces surpassent non seulement les GPU, mais aussi le matériel spécialisé de concurrents comme Groq et Cerebras. Selon Puklowski, les nouvelles puces atteindront des vitesses de 600 à 700 tokens par seconde, comparativement à environ 250 tokens par seconde pour les GPU standards.
General Compute a passé commande de 300 millions de dollars de puces SN50 de SambaNova et vise à être le premier necloud à les déployer.
Ces puces répondent également au deuxième défi majeur : l’emplacement du déploiement. Puisqu’elles sont refroidies par air plutôt que par eau et consomment moins d’énergie, elles peuvent être intégrées dans des installations de centres de données existants sans nécessiter de nouveaux investissements en infrastructure.
Puklowski cherche à conclure des accords de colocation, où General Compute installe son matériel dans des installations tierces. Ces partenariats vont au-delà des fournisseurs traditionnels de centres de données pour inclure des mineurs de cryptomonnaies cherchant à réutiliser leur infrastructure, en particulier lorsque le coût d’extraction du Bitcoin dépasse souvent sa valeur marchande.
General Compute a lancé son service cloud la semaine dernière, affirmant qu’il offre actuellement les meilleures performances pour MiniMax 2.7, un puissant modèle de langage ouvert.
Joe Hasselmann, un investisseur en capital-risque qui a soutenu Groq en 2021 au début de l’essor de l’inférence, a lancé un nouveau fonds cette année, Evercrest Capital Partners, axé sur l’IA. Il a fait de General Compute son premier investissement. Hasselmann voit des parallèles entre le partenariat de SambaNova avec General Compute et la relation de Coreweave avec Nvidia, ainsi que la combinaison de la fabrication de puces par Groq avec ses offres cloud précédentes.
« Ils ont besoin d’une base de clients diversifiée qui placera leurs puces dans des environnements à forte croissance », a noté Hasselmann. « Tout comme General Compute mise sur SambaNova, SambaNova mise sur General Compute. »
La question clé reste de savoir quelle architecture informatique capturera le plus de valeur dans l’avenir de l’IA. Les clouds d’inférence représentent un pari implicite sur un paysage avec plusieurs modèles et agents, où aucun fournisseur unique ne domine, et où la vitesse et le coût deviennent les principaux facteurs concurrentiels. Cela se reflète dans la récente levée de fonds de série B de 113 millions de dollars d’OpenRouter, qui met en évidence sa capacité à fournir aux clients l’accès à plusieurs modèles pour optimiser les dépenses de tokens.
La vitesse est cruciale pour le prix et les capacités. Puklowski vise à réduire les charges de travail des agents de codage d’une heure à cinq ou dix minutes et à rendre les agents audio pour le service client plus économiques en permettant une inférence plus rapide pour des conversations efficaces.
« Si vous utilisez ChatGPT et qu’il génère 50 tokens par seconde, c’est toujours beaucoup plus rapide que la vitesse de lecture humaine », a déclaré Puklowski à TechCrunch. « Cependant, avec le passage aux interactions agent-à-agent, où les agents lisent pour nous ou interrogent des bases de données, ils doivent fonctionner à des vitesses beaucoup plus élevées. »
Article connexe
 Le problème de la monotonie derrière ces menus générés par l'IA, peu appétissants
Au début, vous pourriez remettre en question votre santé mentale. Vous entrez dans un café et parcourez un menu rempli de sandwichs au bagel, pourtant chaque image apparaît d’une manière troublante, parfaitement symétrique et excessivement lisse, déc
Hello Robot prépare ses robots domestiques pour la Silicon Valley
Martinez, en Californie, se trouve à l’extrême nord-est de la baie de San Francisco, à mille lieues du pôle technologique de la Silicon Valley. C’est là qu’est implantée Hello Robot, une start-up qui
L'IA de l'ancien PDG d'Infosys, une startup, a obtenu une autre levée de fonds de 53 millions de dollars
Hang Ten Systems, une startup en intelligence artificielle fondée il y a seulement quatre mois par Vishal Sikka, ancien PDG d’Infosys, a levé 53 millions de dollars supplémentaires lors d’une levée de fonds en amorçage. Ce dernier tour d’investisseme
Recommandations de sujets spéciaux liés
Commercialisation
 Les meilleurs outils de création de profils IA pour l'étude d'audience
Les meilleurs outils 2026 de création de personas basés sur l’IA, les mieux notés pour l’étude d’audience, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui vous aident à mener des tests concrets et à créer des profils d’audience précis grâce à une comparaison détaillée entre les versions gratuites et payantes. Vous découvrirez les options incontournables qui améliorent l'efficacité de la rédaction et vous permettent de tirer pleinement parti de l'IA dans vos stratégies marketing. Explorez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
 9 outils
 xix.ai
Création vidéo
Outils vidéo de démonstration basés sur l'IA pour le marketing des produits SaaS
Les meilleurs outils de création de vidéos de démonstration basés sur l'IA en 2026, spécialement sélectionnés par XIX.AI pour le marketing des produits SaaS. Ces solutions puissantes et révolutionnaires aident les professionnels du marketing à créer rapidement du contenu vidéo de haute qualité, à améliorer leur efficacité rédactionnelle et à rationaliser leurs processus marketing. Profitez d’une comparaison entre les versions gratuites et payantes, accompagnée de tests en conditions réelles et d’un classement mis à jour chaque semaine. Découvrez dès maintenant l’outil idéal pour booster vos ventes SaaS !
9 outils
xix.ai
Rapide
Outils de test des invites IA pour une meilleure qualité de sortie
2026 Derniers Meilleurs Outils de Test de Prompts IA les mieux notés pour une meilleure qualité de sortie ! XIX.AI a sélectionné une collection puissante et révolutionnaire d’outils très performants, soumis à des tests rigoureux en conditions réelles pour garantir des résultats de premier ordre de manière constante. Vous y trouverez des analyses détaillées comparant les versions gratuites et payantes, des classements complets et des conseils d’experts pour vous aider à identifier les solutions incontournables qui améliorent considérablement votre flux de travail. Explorez dès maintenant pour débloquer votre avantage IA !
11 outils
xix.ai
Entreprise
Outils d’analyse des clients par l’IA pour le positionnement des produits
2026 : Les meilleures outils d’analyse des insights clients basés sur l’IA, hautement notés et parmi les plus récents, pour un positionnement produit optimal ! XIX.AI a sélectionné une collection puissante et révolutionnaire, ayant fait l’objet de tests dans des conditions réelles et bénéficiant d’un classement mis à jour chaque semaine. Ces outils vous aident à identifier rapidement les besoins des clients, afin d’améliorer l’efficacité de votre rédaction, de créer du contenu SEO de qualité et d’élaborer des messages adaptés aux réseaux sociaux sans perdre de temps. Découvrez-les dès maintenant pour trouver l’outil idéal et tirer parti de l’avantage offert par l’IA.
10 outils
xix.ai
Assistante de réunion
Outils de prise de notes basés sur l'IA pour Zoom, destinés aux appels avec les clients, aux réunions internes et au suivi des décisions
Classement 2026 des meilleurs outils de prise de notes basés sur l'IA pour Zoom, classés selon leurs performances et leur facilité d'utilisation. XIX.AI a sélectionné une liste des meilleurs outils performants qui vous aident à prendre des notes précises lors des appels avec vos clients, à optimiser la coordination au sein de votre équipe et à suivre sans effort les décisions clés. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests en conditions réelles, pour trouver la solution incontournable qui boostera considérablement votre productivité. Découvrez-la dès maintenant !
12 outils
xix.ai
Analyse des données
Outils d'analyse de feuilles de calcul basés sur l'IA : posez des questions et obtenez des graphiques instantanément
Les meilleurs outils d'analyse de feuilles de calcul basés sur l'IA de 2026, les mieux notés, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des solutions puissantes et révolutionnaires qui vous permettent de poser des questions directement dans vos feuilles de calcul et d'obtenir instantanément des graphiques précis, ce qui augmente considérablement votre productivité. Nous réalisons des tests en conditions réelles et proposons une comparaison entre les versions gratuites et payantes, ainsi qu'un classement mis à jour chaque semaine, pour vous aider à trouver l'outil idéal pour optimiser vos tâches liées aux données. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA !
19 outils
xix.ai

 commentaires (0)
La demande croissante de puissance de calcul pour exécuter des modèles d’IA s’intensifie continuellement, mais les acteurs du secteur font face à deux obstacles majeurs : obtenir le matériel approprié et le déployer dans des centres de données pour commencer à générer des revenus.
General Compute, un nouveau fournisseur de necloud axé sur l’inférence et spécialisé dans la phase de déploiement où les modèles répondent aux utilisateurs plutôt que d’être formés, propose des solutions qui mettent en évidence l’évolution de l’écosystème de l’IA. Ces avantages stratégiques ont permis une levée de fonds initiale de 15 millions de dollars, évaluant l’entreprise à 60 millions de dollars après investissement, dirigée par FUSE VC, avec la participation supplémentaire de Carya Venture Partners et Village Global Ventures.
Identifier la puce optimale est le premier défi. Bien que la demande de GPU ait explosé, il est de plus en plus reconnu qu’ils ne constituent pas le choix le plus efficace pour exécuter des modèles d’IA entraînés. Les exigences computationnelles de l’inférence diffèrent considérablement de celles de l’entraînement, ce qui a conduit au développement d’une nouvelle classe de puces conçues spécifiquement à cet effet. L’acquisition de Groq par Nvidia pour 20 milliards de dollars en décembre et le IPO de Cerebras pour 57 milliards de dollars la semaine dernière soulignent ce changement.
Avec des contraintes de capacité chez Groq et Cerebras, les cofondateurs de General Compute, le PDG Finn Puklowski et le CTO Jason Goodison, ont identifié une alternative. Ils se sont associés à SambaNova, un fabricant de puces soutenu par Intel et spécialisé dans les solutions d’inférence, qui a reçu moins d’attention à Silicon Valley.
Cette dynamique pourrait changer lorsque SambaNova lancera ses nouvelles puces plus tard cette année. L’architecture offre une plus grande flexibilité et utilise davantage de mémoire pour stocker le contexte lors des calculs d’inférence. SambaNova affirme que ces puces surpassent non seulement les GPU, mais aussi le matériel spécialisé de concurrents comme Groq et Cerebras. Selon Puklowski, les nouvelles puces atteindront des vitesses de 600 à 700 tokens par seconde, comparativement à environ 250 tokens par seconde pour les GPU standards.
General Compute a passé commande de 300 millions de dollars de puces SN50 de SambaNova et vise à être le premier necloud à les déployer.
Ces puces répondent également au deuxième défi majeur : l’emplacement du déploiement. Puisqu’elles sont refroidies par air plutôt que par eau et consomment moins d’énergie, elles peuvent être intégrées dans des installations de centres de données existants sans nécessiter de nouveaux investissements en infrastructure.
Puklowski cherche à conclure des accords de colocation, où General Compute installe son matériel dans des installations tierces. Ces partenariats vont au-delà des fournisseurs traditionnels de centres de données pour inclure des mineurs de cryptomonnaies cherchant à réutiliser leur infrastructure, en particulier lorsque le coût d’extraction du Bitcoin dépasse souvent sa valeur marchande.
General Compute a lancé son service cloud la semaine dernière, affirmant qu’il offre actuellement les meilleures performances pour MiniMax 2.7, un puissant modèle de langage ouvert.
Joe Hasselmann, un investisseur en capital-risque qui a soutenu Groq en 2021 au début de l’essor de l’inférence, a lancé un nouveau fonds cette année, Evercrest Capital Partners, axé sur l’IA. Il a fait de General Compute son premier investissement. Hasselmann voit des parallèles entre le partenariat de SambaNova avec General Compute et la relation de Coreweave avec Nvidia, ainsi que la combinaison de la fabrication de puces par Groq avec ses offres cloud précédentes.
« Ils ont besoin d’une base de clients diversifiée qui placera leurs puces dans des environnements à forte croissance », a noté Hasselmann. « Tout comme General Compute mise sur SambaNova, SambaNova mise sur General Compute. »
La question clé reste de savoir quelle architecture informatique capturera le plus de valeur dans l’avenir de l’IA. Les clouds d’inférence représentent un pari implicite sur un paysage avec plusieurs modèles et agents, où aucun fournisseur unique ne domine, et où la vitesse et le coût deviennent les principaux facteurs concurrentiels. Cela se reflète dans la récente levée de fonds de série B de 113 millions de dollars d’OpenRouter, qui met en évidence sa capacité à fournir aux clients l’accès à plusieurs modèles pour optimiser les dépenses de tokens.
La vitesse est cruciale pour le prix et les capacités. Puklowski vise à réduire les charges de travail des agents de codage d’une heure à cinq ou dix minutes et à rendre les agents audio pour le service client plus économiques en permettant une inférence plus rapide pour des conversations efficaces.
« Si vous utilisez ChatGPT et qu’il génère 50 tokens par seconde, c’est toujours beaucoup plus rapide que la vitesse de lecture humaine », a déclaré Puklowski à TechCrunch. « Cependant, avec le passage aux interactions agent-à-agent, où les agents lisent pour nous ou interrogent des bases de données, ils doivent fonctionner à des vitesses beaucoup plus élevées. »








 Le problème de la monotonie derrière ces menus générés par l'IA, peu appétissants
Au début, vous pourriez remettre en question votre santé mentale. Vous entrez dans un café et parcourez un menu rempli de sandwichs au bagel, pourtant chaque image apparaît d’une manière troublante, parfaitement symétrique et excessivement lisse, déc
 Hello Robot prépare ses robots domestiques pour la Silicon Valley
Martinez, en Californie, se trouve à l’extrême nord-est de la baie de San Francisco, à mille lieues du pôle technologique de la Silicon Valley. C’est là qu’est implantée Hello Robot, une start-up qui
 L'IA de l'ancien PDG d'Infosys, une startup, a obtenu une autre levée de fonds de 53 millions de dollars
Hang Ten Systems, une startup en intelligence artificielle fondée il y a seulement quatre mois par Vishal Sikka, ancien PDG d’Infosys, a levé 53 millions de dollars supplémentaires lors d’une levée de fonds en amorçage. Ce dernier tour d’investisseme
Les meilleurs outils 2026 de création de personas basés sur l’IA, les mieux notés pour l’étude d’audience, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui vous aident à mener des tests concrets et à créer des profils d’audience précis grâce à une comparaison détaillée entre les versions gratuites et payantes. Vous découvrirez les options incontournables qui améliorent l'efficacité de la rédaction et vous permettent de tirer pleinement parti de l'IA dans vos stratégies marketing. Explorez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Les meilleurs outils de création de vidéos de démonstration basés sur l'IA en 2026, spécialement sélectionnés par XIX.AI pour le marketing des produits SaaS. Ces solutions puissantes et révolutionnaires aident les professionnels du marketing à créer rapidement du contenu vidéo de haute qualité, à améliorer leur efficacité rédactionnelle et à rationaliser leurs processus marketing. Profitez d’une comparaison entre les versions gratuites et payantes, accompagnée de tests en conditions réelles et d’un classement mis à jour chaque semaine. Découvrez dès maintenant l’outil idéal pour booster vos ventes SaaS !
9 outils
xix.ai
2026 Derniers Meilleurs Outils de Test de Prompts IA les mieux notés pour une meilleure qualité de sortie ! XIX.AI a sélectionné une collection puissante et révolutionnaire d’outils très performants, soumis à des tests rigoureux en conditions réelles pour garantir des résultats de premier ordre de manière constante. Vous y trouverez des analyses détaillées comparant les versions gratuites et payantes, des classements complets et des conseils d’experts pour vous aider à identifier les solutions incontournables qui améliorent considérablement votre flux de travail. Explorez dès maintenant pour débloquer votre avantage IA !
11 outils
xix.ai
2026 : Les meilleures outils d’analyse des insights clients basés sur l’IA, hautement notés et parmi les plus récents, pour un positionnement produit optimal ! XIX.AI a sélectionné une collection puissante et révolutionnaire, ayant fait l’objet de tests dans des conditions réelles et bénéficiant d’un classement mis à jour chaque semaine. Ces outils vous aident à identifier rapidement les besoins des clients, afin d’améliorer l’efficacité de votre rédaction, de créer du contenu SEO de qualité et d’élaborer des messages adaptés aux réseaux sociaux sans perdre de temps. Découvrez-les dès maintenant pour trouver l’outil idéal et tirer parti de l’avantage offert par l’IA.
10 outils
xix.ai
Classement 2026 des meilleurs outils de prise de notes basés sur l'IA pour Zoom, classés selon leurs performances et leur facilité d'utilisation. XIX.AI a sélectionné une liste des meilleurs outils performants qui vous aident à prendre des notes précises lors des appels avec vos clients, à optimiser la coordination au sein de votre équipe et à suivre sans effort les décisions clés. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests en conditions réelles, pour trouver la solution incontournable qui boostera considérablement votre productivité. Découvrez-la dès maintenant !
12 outils
xix.ai
Les meilleurs outils d'analyse de feuilles de calcul basés sur l'IA de 2026, les mieux notés, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des solutions puissantes et révolutionnaires qui vous permettent de poser des questions directement dans vos feuilles de calcul et d'obtenir instantanément des graphiques précis, ce qui augmente considérablement votre productivité. Nous réalisons des tests en conditions réelles et proposons une comparaison entre les versions gratuites et payantes, ainsi qu'un classement mis à jour chaque semaine, pour vous aider à trouver l'outil idéal pour optimiser vos tâches liées aux données. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA !
19 outils
xix.ai












