


 Lar
A Caçada por Computação de IA: A Cerebras é a Próxima Grande Coisa?
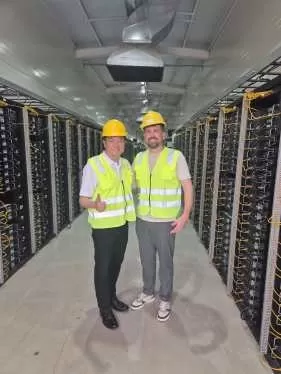
A demanda crescente por poder de computação para executar modelos de IA continua a se intensificar, no entanto, os players do setor enfrentam dois obstáculos críticos: garantir o hardware adequado e implantá-lo em data centers para começar a gerar receita.
A General Compute, um novo provedor de neocloud focado em inferência especializado na fase de implantação onde os modelos respondem aos usuários em vez de passar por treinamento, oferece soluções que destacam a direção evolutiva do ecossistema de IA. Essas vantagens estratégicas facilitaram uma rodada de investimento inicial (seed) de US$ 15 milhões com uma avaliação pós-investimento de US$ 60 milhões, liderada pela FUSE VC, com participação adicional da Carya Venture Partners e da Village Global Ventures.
Identificar o chip ideal é o primeiro desafio. Embora a demanda por GPUs tenha disparado, está cada vez mais reconhecido que elas não são a escolha mais eficiente para executar modelos de IA treinados. Os requisitos computacionais para inferência diferem significativamente dos de treinamento, o que impulsionou o desenvolvimento de uma nova classe de chips projetados especificamente para esse propósito. A aquisição da Groq pela Nvidia por US$ 20 bilhões em dezembro e o IPO de US$ 57 bilhões da Cerebras na semana passada destacam essa mudança.
Com restrições de capacidade na Groq e na Cerebras, os cofundadores da General Compute, o CEO Finn Puklowski e o CTO Jason Goodison, identificaram uma alternativa. Eles se associaram à SambaNova, uma fabricante de chips apoiada pela Intel especializada em soluções de inferência que recebeu menos atenção no Vale do Silício.
Essa dinâmica pode mudar quando a SambaNova lançar seus novos chips no final deste ano. A arquitetura oferece maior flexibilidade e utiliza mais memória para armazenar contexto durante os cálculos de inferência. A SambaNova afirma que esses chips superam não apenas as GPUs, mas também o hardware especializado de concorrentes como Groq e Cerebras. De acordo com Puklowski, os novos chips alcançarão velocidades de 600 a 700 tokens por segundo, em comparação com aproximadamente 250 tokens por segundo para GPUs padrão.
A General Compute fez um pedido de US$ 300 milhões em chips SN50 da SambaNova e tem como objetivo ser a primeira neocloud a implantá-los.
Esses chips também abordam o segundo grande desafio: a localização da implantação. Como são resfriados a ar em vez de resfriados a água e consomem menos energia, podem ser integrados às instalações existentes de data centers sem exigir novos investimentos em infraestrutura.
Puklowski está buscando acordos de colocation, onde a General Compute instala seu hardware em instalações de terceiros. Essas parcerias se estendem além dos provedores tradicionais de data centers para incluir mineradores de criptomoedas que buscam reaproveitar sua infraestrutura, especialmente quando o custo da mineração de Bitcoin frequentemente excede seu valor de mercado.
A General Compute lançou seu serviço em nuvem na semana passada, afirmando que atualmente oferece o desempenho mais rápido para o MiniMax 2.7, um poderoso modelo de linguagem grande de código aberto.
Joe Hasselmann, um investidor de capital de risco que apoiou a Groq em 2021 durante as fases iniciais do boom da inferência, lançou um novo fundo este ano, a Evercrest Capital Partners, focado em IA. Ele fez da General Compute seu primeiro investimento. Hasselmann vê paralelos entre a parceria da SambaNova com a General Compute e a relação da Coreweave com a Nvidia, bem como a combinação da fabricação de chips da Groq com suas ofertas anteriores de nuvem.
“Eles precisam de uma base de clientes diversificada que colocará seus chips em ambientes de alto crescimento”, observou Hasselmann. “Assim como a General Compute está apostando na SambaNova, a SambaNova está apostando na General Compute.”
A questão fundamental permanece: qual arquitetura de computador capturará o maior valor no futuro da IA. As nuvens de inferência representam uma aposta implícita em um cenário com múltiplos modelos e agentes, onde nenhum único provedor domina, e a velocidade e o custo se tornam os principais fatores competitivos. Isso é refletido na recente captação de US$ 113 milhões na Série B da OpenRouter, que destaca sua capacidade de fornecer aos clientes acesso a múltiplos modelos para otimizar os gastos com tokens.
A velocidade é crucial para precificação e capacidade. Puklowski visa reduzir cargas de trabalho de agentes de codificação que levam horas para cinco ou dez minutos e tornar os agentes de áudio para atendimento ao cliente mais econômicos, permitindo inferência mais rápida para conversas eficazes.
“Se você usa o ChatGPT e ele gera 50 tokens por segundo, isso ainda é muito mais rápido do que a velocidade de leitura humana”, disse Puklowski à TechCrunch. “No entanto, com a mudança para interações entre agentes, onde os agentes leem em nosso nome ou consultam bancos de dados, eles precisam operar a velocidades muito mais altas.”
Artigo relacionado
 O problema da homogeneidade por trás desses cardápios gerados por IA pouco apetitosos
No início, você pode questionar sua sanidade. Você entra em uma cafeteria e examina um cardápio repleto de sanduíches de rosca, mas todas as imagens parecem desconcertantemente perfeitas — simétricas à perfeição e excessivamente lisas —, desencadeand
A Hello Robot prepara robôs domésticos para o Vale do Silício
Martinez, na Califórnia, fica na extremidade nordeste da Região da Baía de São Francisco, a um mundo de distância do polo tecnológico do Vale do Silício. É aqui que está sediada a Hello Robot, uma sta
Antigo diretor da Infosys, startup de IA garante mais US$ 53 milhões
Hang Ten Systems, uma startup de IA estabelecida pelo ex-CEO da Infosys, Vishal Sikka, há apenas quatro meses, garantiu mais US$ 53 milhões em financiamento semente. Esta última rodada de investimento foi concluída apenas cinco semanas após a rodada
Recomendações de tópicos especiais relacionados
Marketing
 As melhores ferramentas de criação de personas com IA para pesquisa de público-alvo
As melhores e mais bem avaliadas ferramentas de 2026 para criação de personas com IA, voltadas para pesquisa de público-alvo, estão aqui no XIX.AI! Esta lista selecionada apresenta ferramentas poderosas e revolucionárias que ajudam você a realizar testes na prática e criar perfis precisos de público-alvo por meio de uma comparação detalhada entre opções gratuitas e pagas. Você descobrirá as opções imperdíveis que aumentam a eficiência na redação e revelam sua vantagem com IA nas estratégias de marketing. Explore agora para encontrar a ferramenta perfeita para você!
 9 ferramentas
 xix.ai
Criação de vídeo
Ferramentas de vídeo de demonstração com IA para o marketing de produtos SaaS
As melhores e mais bem avaliadas ferramentas de vídeo com IA de 2026 para o marketing de produtos SaaS, cuidadosamente selecionadas pela XIX.AI. Essas soluções poderosas e revolucionárias ajudam os profissionais de marketing a criar conteúdo de vídeo de alta qualidade rapidamente, aumentar a eficiência na redação e otimizar os fluxos de trabalho de marketing. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente. Explore agora mesmo e descubra a ferramenta perfeita para impulsionar suas vendas de SaaS!
9 ferramentas
xix.ai
Incitar
Ferramentas de Teste de Prompts de IA para Melhor Qualidade de Saída
2026 Últimas Melhores Ferramentas de Teste de Prompts de IA Mais Bem Avaliadas para Melhor Qualidade de Saída! A XIX.AI reuniu uma coleção poderosa e transformadora de ferramentas altamente eficientes, submetidas a rigorosos testes do mundo real para garantir resultados consistentes de alto nível. Você encontrará análises detalhadas comparando versões gratuitas e pagas, rankings abrangentes e orientações de especialistas para ajudá-lo a identificar as soluções imperdíveis que impulsionam significativamente seu fluxo de trabalho. Explore agora para desbloquear sua vantagem com IA!
11 ferramentas
xix.ai
Negócios
Ferramentas de Inteligência Artificial para Análise de Clientes, voltadas para o posicionamento de produtos
2026 – As melhores e mais bem avaliadas ferramentas de inteligência artificial para análise do comportamento do cliente, ideais para o posicionamento de produtos! A XIX.AI reuniu uma coleção poderosa e revolucionária, que passou por testes reais e possui classificações atualizadas semanalmente. Elas ajudam você a identificar rapidamente as necessidades dos clientes, aumentando assim a eficiência na redação, criando conteúdo otimizado para SEO e elaborando mensagens perfeitas para redes sociais, sem perder tempo. Explore agora para encontrar a ferramenta ideal e aproveitar todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Assistente de Reunião
Ferramentas de anotação com IA do Zoom para chamadas com clientes, sincronizações internas e acompanhamento de decisões
2026: As melhores ferramentas de anotação com IA para o Zoom, classificadas por desempenho e usabilidade. A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e poderosas que ajudam você a fazer anotações precisas durante chamadas com clientes, otimizar a sincronização interna da equipe e acompanhar decisões importantes sem esforço. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos, para encontrar a solução imperdível que aumentará significativamente sua produtividade. Explore agora!
12 ferramentas
xix.ai
Análise de dados
Ferramentas de Análise de Planilhas com IA: Faça Perguntas e Obtenha Gráficos Instantaneamente
As melhores ferramentas de análise de planilhas com IA mais recentes e melhor avaliadas de 2026 estão aqui no XIX.AI! Esta lista selecionada apresenta soluções poderosas e transformadoras que permitem fazer perguntas diretamente em planilhas e obter gráficos precisos instantaneamente, aumentando significativamente sua produtividade. Realizamos testes do mundo real e fornecemos uma comparação entre versão gratuita e paga, bem como classificações atualizadas semanalmente, para ajudá-lo a encontrar a ferramenta perfeita para simplificar tarefas de dados. Explore agora para desbloquear sua vantagem com IA!
19 ferramentas
xix.ai

 Comentários (0)
A demanda crescente por poder de computação para executar modelos de IA continua a se intensificar, no entanto, os players do setor enfrentam dois obstáculos críticos: garantir o hardware adequado e implantá-lo em data centers para começar a gerar receita.
A General Compute, um novo provedor de neocloud focado em inferência especializado na fase de implantação onde os modelos respondem aos usuários em vez de passar por treinamento, oferece soluções que destacam a direção evolutiva do ecossistema de IA. Essas vantagens estratégicas facilitaram uma rodada de investimento inicial (seed) de US$ 15 milhões com uma avaliação pós-investimento de US$ 60 milhões, liderada pela FUSE VC, com participação adicional da Carya Venture Partners e da Village Global Ventures.
Identificar o chip ideal é o primeiro desafio. Embora a demanda por GPUs tenha disparado, está cada vez mais reconhecido que elas não são a escolha mais eficiente para executar modelos de IA treinados. Os requisitos computacionais para inferência diferem significativamente dos de treinamento, o que impulsionou o desenvolvimento de uma nova classe de chips projetados especificamente para esse propósito. A aquisição da Groq pela Nvidia por US$ 20 bilhões em dezembro e o IPO de US$ 57 bilhões da Cerebras na semana passada destacam essa mudança.
Com restrições de capacidade na Groq e na Cerebras, os cofundadores da General Compute, o CEO Finn Puklowski e o CTO Jason Goodison, identificaram uma alternativa. Eles se associaram à SambaNova, uma fabricante de chips apoiada pela Intel especializada em soluções de inferência que recebeu menos atenção no Vale do Silício.
Essa dinâmica pode mudar quando a SambaNova lançar seus novos chips no final deste ano. A arquitetura oferece maior flexibilidade e utiliza mais memória para armazenar contexto durante os cálculos de inferência. A SambaNova afirma que esses chips superam não apenas as GPUs, mas também o hardware especializado de concorrentes como Groq e Cerebras. De acordo com Puklowski, os novos chips alcançarão velocidades de 600 a 700 tokens por segundo, em comparação com aproximadamente 250 tokens por segundo para GPUs padrão.
A General Compute fez um pedido de US$ 300 milhões em chips SN50 da SambaNova e tem como objetivo ser a primeira neocloud a implantá-los.
Esses chips também abordam o segundo grande desafio: a localização da implantação. Como são resfriados a ar em vez de resfriados a água e consomem menos energia, podem ser integrados às instalações existentes de data centers sem exigir novos investimentos em infraestrutura.
Puklowski está buscando acordos de colocation, onde a General Compute instala seu hardware em instalações de terceiros. Essas parcerias se estendem além dos provedores tradicionais de data centers para incluir mineradores de criptomoedas que buscam reaproveitar sua infraestrutura, especialmente quando o custo da mineração de Bitcoin frequentemente excede seu valor de mercado.
A General Compute lançou seu serviço em nuvem na semana passada, afirmando que atualmente oferece o desempenho mais rápido para o MiniMax 2.7, um poderoso modelo de linguagem grande de código aberto.
Joe Hasselmann, um investidor de capital de risco que apoiou a Groq em 2021 durante as fases iniciais do boom da inferência, lançou um novo fundo este ano, a Evercrest Capital Partners, focado em IA. Ele fez da General Compute seu primeiro investimento. Hasselmann vê paralelos entre a parceria da SambaNova com a General Compute e a relação da Coreweave com a Nvidia, bem como a combinação da fabricação de chips da Groq com suas ofertas anteriores de nuvem.
“Eles precisam de uma base de clientes diversificada que colocará seus chips em ambientes de alto crescimento”, observou Hasselmann. “Assim como a General Compute está apostando na SambaNova, a SambaNova está apostando na General Compute.”
A questão fundamental permanece: qual arquitetura de computador capturará o maior valor no futuro da IA. As nuvens de inferência representam uma aposta implícita em um cenário com múltiplos modelos e agentes, onde nenhum único provedor domina, e a velocidade e o custo se tornam os principais fatores competitivos. Isso é refletido na recente captação de US$ 113 milhões na Série B da OpenRouter, que destaca sua capacidade de fornecer aos clientes acesso a múltiplos modelos para otimizar os gastos com tokens.
A velocidade é crucial para precificação e capacidade. Puklowski visa reduzir cargas de trabalho de agentes de codificação que levam horas para cinco ou dez minutos e tornar os agentes de áudio para atendimento ao cliente mais econômicos, permitindo inferência mais rápida para conversas eficazes.
“Se você usa o ChatGPT e ele gera 50 tokens por segundo, isso ainda é muito mais rápido do que a velocidade de leitura humana”, disse Puklowski à TechCrunch. “No entanto, com a mudança para interações entre agentes, onde os agentes leem em nosso nome ou consultam bancos de dados, eles precisam operar a velocidades muito mais altas.”








 O problema da homogeneidade por trás desses cardápios gerados por IA pouco apetitosos
No início, você pode questionar sua sanidade. Você entra em uma cafeteria e examina um cardápio repleto de sanduíches de rosca, mas todas as imagens parecem desconcertantemente perfeitas — simétricas à perfeição e excessivamente lisas —, desencadeand
 A Hello Robot prepara robôs domésticos para o Vale do Silício
Martinez, na Califórnia, fica na extremidade nordeste da Região da Baía de São Francisco, a um mundo de distância do polo tecnológico do Vale do Silício. É aqui que está sediada a Hello Robot, uma sta
 Antigo diretor da Infosys, startup de IA garante mais US$ 53 milhões
Hang Ten Systems, uma startup de IA estabelecida pelo ex-CEO da Infosys, Vishal Sikka, há apenas quatro meses, garantiu mais US$ 53 milhões em financiamento semente. Esta última rodada de investimento foi concluída apenas cinco semanas após a rodada
As melhores e mais bem avaliadas ferramentas de 2026 para criação de personas com IA, voltadas para pesquisa de público-alvo, estão aqui no XIX.AI! Esta lista selecionada apresenta ferramentas poderosas e revolucionárias que ajudam você a realizar testes na prática e criar perfis precisos de público-alvo por meio de uma comparação detalhada entre opções gratuitas e pagas. Você descobrirá as opções imperdíveis que aumentam a eficiência na redação e revelam sua vantagem com IA nas estratégias de marketing. Explore agora para encontrar a ferramenta perfeita para você!
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de vídeo com IA de 2026 para o marketing de produtos SaaS, cuidadosamente selecionadas pela XIX.AI. Essas soluções poderosas e revolucionárias ajudam os profissionais de marketing a criar conteúdo de vídeo de alta qualidade rapidamente, aumentar a eficiência na redação e otimizar os fluxos de trabalho de marketing. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente. Explore agora mesmo e descubra a ferramenta perfeita para impulsionar suas vendas de SaaS!
9 ferramentas
xix.ai
2026 Últimas Melhores Ferramentas de Teste de Prompts de IA Mais Bem Avaliadas para Melhor Qualidade de Saída! A XIX.AI reuniu uma coleção poderosa e transformadora de ferramentas altamente eficientes, submetidas a rigorosos testes do mundo real para garantir resultados consistentes de alto nível. Você encontrará análises detalhadas comparando versões gratuitas e pagas, rankings abrangentes e orientações de especialistas para ajudá-lo a identificar as soluções imperdíveis que impulsionam significativamente seu fluxo de trabalho. Explore agora para desbloquear sua vantagem com IA!
11 ferramentas
xix.ai
2026 – As melhores e mais bem avaliadas ferramentas de inteligência artificial para análise do comportamento do cliente, ideais para o posicionamento de produtos! A XIX.AI reuniu uma coleção poderosa e revolucionária, que passou por testes reais e possui classificações atualizadas semanalmente. Elas ajudam você a identificar rapidamente as necessidades dos clientes, aumentando assim a eficiência na redação, criando conteúdo otimizado para SEO e elaborando mensagens perfeitas para redes sociais, sem perder tempo. Explore agora para encontrar a ferramenta ideal e aproveitar todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
2026: As melhores ferramentas de anotação com IA para o Zoom, classificadas por desempenho e usabilidade. A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e poderosas que ajudam você a fazer anotações precisas durante chamadas com clientes, otimizar a sincronização interna da equipe e acompanhar decisões importantes sem esforço. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos, para encontrar a solução imperdível que aumentará significativamente sua produtividade. Explore agora!
12 ferramentas
xix.ai
As melhores ferramentas de análise de planilhas com IA mais recentes e melhor avaliadas de 2026 estão aqui no XIX.AI! Esta lista selecionada apresenta soluções poderosas e transformadoras que permitem fazer perguntas diretamente em planilhas e obter gráficos precisos instantaneamente, aumentando significativamente sua produtividade. Realizamos testes do mundo real e fornecemos uma comparação entre versão gratuita e paga, bem como classificações atualizadas semanalmente, para ajudá-lo a encontrar a ferramenta perfeita para simplificar tarefas de dados. Explore agora para desbloquear sua vantagem com IA!
19 ferramentas
xix.ai












