


 Maison
StepZen présente la version en temps réel Step Audio 2.5, qui confère aux grands modèles de langage des émotions et une intelligence proches de celles d’un être humain.
Avec le développement rapide de l’intelligence artificielle, l’expérience d’interaction offerte par les grands modèles de langage connaît un changement majeur, passant de simples conversations basées sur du texte à une véritable communication émotionnelle en temps réel. Le 8 mai, Jieque Star, pionnier reconnu dans le domaine des grands modèles de langage, a présenté sa dernière avancée scientifique : le nouveau modèle de parole en temps réel StepAudio 2.5 Realtime. La mise sur le marché de ce modèle avancé représente une nouvelle étape dans l’amélioration du naturel et de l’intelligence des grands modèles de langage nationaux conçus pour les interactions vocales.
Perception approfondie : entrée dans une ère d’interaction à la complexité humaine
Contrairement aux assistants vocaux traditionnels, StepAudio 2.5 Realtime se distingue par ses capacités de perception profonde hautement sophistiquées, fonctionnant au même niveau de complexité que celui des êtres humains. Il ne se contente pas de reconnaître les commandes orales ; il est capable de détecter avec précision les subtils indices émotionnels ainsi que les changements contextuels au cours des conversations.
Grâce à ces améliorations technologiques, le modèle a réalisé d’importants progrès tant en termes d’intelligence cognitive qu’émotionnelle. Lors des interactions, il parvient à fournir des réponses mieux adaptées à l’état émotionnel de l’utilisateur, en tenant compte de facteurs tels que le ton et le rythme de parole. Cela permet à la communication de dépasser un simple échange d’informations unidirectionnel pour atteindre un dialogue plus authentique, similaire à celui entre humains, empreint d’empathie.
Personnalisation flexible : création de personnalités IA sur mesure
Afin de répondre aux besoins variés des différents scénarios d’utilisation, StepAudio 2.5 Realtime dispose d’une option très adaptable permettant de personnaliser les personnalités IA. Que les utilisateurs aient besoin d’un assistant professionnel et fiable pour le travail ou d’un partenaire de conversation dynamique pour se divertir, les développeurs et les utilisateurs finaux peuvent attribuer des traits de personnalité et des styles linguistiques spécifiques à l’IA en fonction de leurs besoins réels. Un tel niveau de personnalisation a le potentiel d’élargir considérablement le champ d’application des modèles de parole en temps réel dans des secteurs tels que l’éducation, les loisirs et les affaires.
Disponibilité commerciale totale : les grands modèles de langage nationaux accélèrent leur développement
Actuellement, Jieque Star a annoncé que StepAudio 2.5 Realtime est désormais entièrement disponible pour utilisation. Cela signifie que les développeurs et leurs partenaires peuvent immédiatement y avoir accès et commencer à l’expérimenter avec cette technologie de pointe.
Article connexe
 Anthropic lance Claude Haiku 5.5, réduisant les coûts des petits modèles de 75 % et permettant aux utilisateurs d’ajuster l’intensité de l’inférence
Le 8 octobre, Anthropic a présenté son modèle le plus efficace et le plus performant à ce jour : Claude Haiku 5.5. Positionné comme le petit modèle le plus rapide et le plus capable de la gamme d’Anthropic, il est conçu pour des applications à haute
Claude dévoile la première carte complète du ciel en ultraviolet, cartographiant 119 millions d'étoiles
Avec l’aide puissante de Claude, le grand modèle de langage d’Anthropic, des astrophysiciens ont réussi à générer la première carte complète du ciel entier en ultraviolets de l’histoire. Cette vaste carte stellaire, comportant 119 millions d’étoiles,
Comment AWS et NVIDIA soutiennent l'IA agentique et physique
Jensen Huang, PDG de NVIDIA (Crédit : Tomohiro Ohsumi/Getty Images)NVIDIA, dirigée par Jensen Huang, et AWS renforcent leur partenariat mondial en déployant 2 millions de GPU pour alimenter l’infrastr
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Avec le développement rapide de l’intelligence artificielle, l’expérience d’interaction offerte par les grands modèles de langage connaît un changement majeur, passant de simples conversations basées sur du texte à une véritable communication émotionnelle en temps réel. Le 8 mai, Jieque Star, pionnier reconnu dans le domaine des grands modèles de langage, a présenté sa dernière avancée scientifique : le nouveau modèle de parole en temps réel StepAudio 2.5 Realtime. La mise sur le marché de ce modèle avancé représente une nouvelle étape dans l’amélioration du naturel et de l’intelligence des grands modèles de langage nationaux conçus pour les interactions vocales.
Perception approfondie : entrée dans une ère d’interaction à la complexité humaine
Contrairement aux assistants vocaux traditionnels, StepAudio 2.5 Realtime se distingue par ses capacités de perception profonde hautement sophistiquées, fonctionnant au même niveau de complexité que celui des êtres humains. Il ne se contente pas de reconnaître les commandes orales ; il est capable de détecter avec précision les subtils indices émotionnels ainsi que les changements contextuels au cours des conversations.
Grâce à ces améliorations technologiques, le modèle a réalisé d’importants progrès tant en termes d’intelligence cognitive qu’émotionnelle. Lors des interactions, il parvient à fournir des réponses mieux adaptées à l’état émotionnel de l’utilisateur, en tenant compte de facteurs tels que le ton et le rythme de parole. Cela permet à la communication de dépasser un simple échange d’informations unidirectionnel pour atteindre un dialogue plus authentique, similaire à celui entre humains, empreint d’empathie.
Personnalisation flexible : création de personnalités IA sur mesure
Afin de répondre aux besoins variés des différents scénarios d’utilisation, StepAudio 2.5 Realtime dispose d’une option très adaptable permettant de personnaliser les personnalités IA. Que les utilisateurs aient besoin d’un assistant professionnel et fiable pour le travail ou d’un partenaire de conversation dynamique pour se divertir, les développeurs et les utilisateurs finaux peuvent attribuer des traits de personnalité et des styles linguistiques spécifiques à l’IA en fonction de leurs besoins réels. Un tel niveau de personnalisation a le potentiel d’élargir considérablement le champ d’application des modèles de parole en temps réel dans des secteurs tels que l’éducation, les loisirs et les affaires.
Disponibilité commerciale totale : les grands modèles de langage nationaux accélèrent leur développement
Actuellement, Jieque Star a annoncé que StepAudio 2.5 Realtime est désormais entièrement disponible pour utilisation. Cela signifie que les développeurs et leurs partenaires peuvent immédiatement y avoir accès et commencer à l’expérimenter avec cette technologie de pointe.








 Anthropic lance Claude Haiku 5.5, réduisant les coûts des petits modèles de 75 % et permettant aux utilisateurs d’ajuster l’intensité de l’inférence
Le 8 octobre, Anthropic a présenté son modèle le plus efficace et le plus performant à ce jour : Claude Haiku 5.5. Positionné comme le petit modèle le plus rapide et le plus capable de la gamme d’Anthropic, il est conçu pour des applications à haute
 Claude dévoile la première carte complète du ciel en ultraviolet, cartographiant 119 millions d'étoiles
Avec l’aide puissante de Claude, le grand modèle de langage d’Anthropic, des astrophysiciens ont réussi à générer la première carte complète du ciel entier en ultraviolets de l’histoire. Cette vaste carte stellaire, comportant 119 millions d’étoiles,
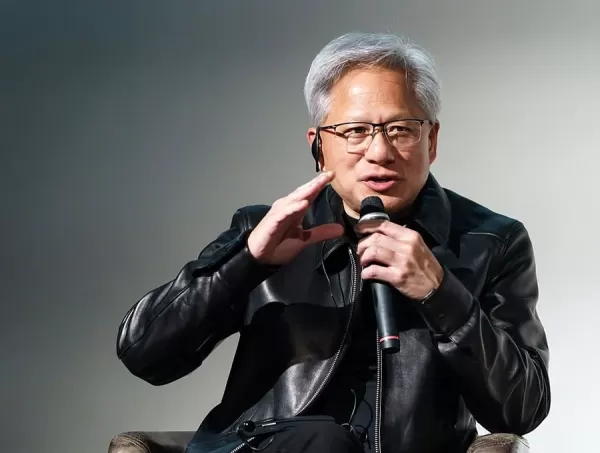 Comment AWS et NVIDIA soutiennent l'IA agentique et physique
Jensen Huang, PDG de NVIDIA (Crédit : Tomohiro Ohsumi/Getty Images)NVIDIA, dirigée par Jensen Huang, et AWS renforcent leur partenariat mondial en déployant 2 millions de GPU pour alimenter l’infrastr

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












