


 Hogar
StepZen presenta la versión en tiempo real Step Audio 2.5, que aporta emociones e inteligencia similares a las humanas a los modelos de lenguaje grande.
Con el rápido avance de la inteligencia artificial, la experiencia de interacción que ofrecen los modelos de lenguaje grande están experimentando un cambio significativo, pasando de conversaciones simples basadas en texto hacia una verdadera comunicación emocional en tiempo real. El 8 de mayo, Jieque Star, uno de los principales innovadores en el campo de los modelos de lenguaje grande, presentó su último avance investigativo: el nuevo modelo de voz en tiempo real StepAudio 2.5 Realtime. El lanzamiento de este modelo avanzado representa otro hito en la mejora de la naturalidad e inteligencia de los modelos de lenguaje grande nacionales diseñados para interacciones por voz.
Percepción profunda: Entrando en una era de interacción con complejidad a nivel humano
A diferencia de los asistentes de voz convencionales, StepAudio 2.5 Realtime se destaca gracias a sus capacidades de percepción profunda altamente sofisticadas que operan con un nivel de complejidad similar al humano. No se limita a reconocer comandos hablados; en su lugar, puede detectar con precisión sutiles indicadores emocionales y cambios contextuales dentro de las conversaciones.
Gracias a estas mejoras tecnológicas, el modelo ha logrado avances significativos tanto en inteligencia cognitiva como emocional. Durante las interacciones, es capaz de ofrecer respuestas que se ajustan mejor al estado emocional del usuario, teniendo en cuenta factores como el tono y la velocidad de habla. Esto permite que la comunicación supere un simple intercambio unidireccional de información y evolucione hacia un diálogo más genuino y similar al humano, lleno de empatía.
Personalización flexible: Creando perfiles de IA a medida
Para satisfacer las diversas necesidades de diferentes escenarios de aplicación, StepAudio 2.5 Realtime cuenta con una opción altamente adaptable para personalizar los perfiles de IA. Tanto si los usuarios necesitan un asistente profesional y fiable para el trabajo como un compañero de conversación animado para entretenimiento, los desarrolladores y usuarios finales pueden asignar rasgos de personalidad y estilos lingüísticos específicos a la IA según sus requisitos reales. Este nivel de personalización tiene el potencial de ampliar significativamente el ámbito de aplicación de los modelos de voz en tiempo real en industrias como la educación, el entretenimiento y los negocios.
Disponibilidad comercial total: Los modelos de lenguaje grande nacionales aceleran su crecimiento
Actualmente, Jieque Star ha anunciado que StepAudio 2.5 Realtime ya está completamente disponible para su uso. Esto significa que los desarrolladores y socios pueden acceder de inmediato a esta tecnología de vanguardia e iniciar pruebas con ella.
Artículo relacionado
 Anthropic lanza Claude Haiku 5.5, reduciendo los costos de los modelos pequeños en un 75% y permitiendo a los usuarios ajustar la intensidad de inferencia
El 8 de octubre, Anthropic presentó su modelo más eficiente y capaz hasta la fecha: Claude Haiku 5.5. Posicionado como el modelo pequeño más rápido y capaz de la gama de Anthropic, está diseñado para aplicaciones de alta frecuencia y sensibles al cos
Claude presenta el primer mapa completo del cielo en ultravioleta, que cartografía 119 millones de estrellas
Con la poderosa asistencia de Claude, el modelo de lenguaje grande de Anthropic, los astrofísicos han generado con éxito el primer mapa completo del cielo en ultravioleta de la historia. Este vasto catálogo estelar, que incluye 119 millones de estrel
Cómo AWS y NVIDIA están impulsando la IA agentiva y la IA física
Jensen Huang, director ejecutivo de NVIDIA (Crédito: Tomohiro Ohsumi/Getty Images)NVIDIA, de Jensen Huang, y AWS amplían su colaboración global con el despliegue de 2 millones de GPU para impulsar la
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Con el rápido avance de la inteligencia artificial, la experiencia de interacción que ofrecen los modelos de lenguaje grande están experimentando un cambio significativo, pasando de conversaciones simples basadas en texto hacia una verdadera comunicación emocional en tiempo real. El 8 de mayo, Jieque Star, uno de los principales innovadores en el campo de los modelos de lenguaje grande, presentó su último avance investigativo: el nuevo modelo de voz en tiempo real StepAudio 2.5 Realtime. El lanzamiento de este modelo avanzado representa otro hito en la mejora de la naturalidad e inteligencia de los modelos de lenguaje grande nacionales diseñados para interacciones por voz.
Percepción profunda: Entrando en una era de interacción con complejidad a nivel humano
A diferencia de los asistentes de voz convencionales, StepAudio 2.5 Realtime se destaca gracias a sus capacidades de percepción profunda altamente sofisticadas que operan con un nivel de complejidad similar al humano. No se limita a reconocer comandos hablados; en su lugar, puede detectar con precisión sutiles indicadores emocionales y cambios contextuales dentro de las conversaciones.
Gracias a estas mejoras tecnológicas, el modelo ha logrado avances significativos tanto en inteligencia cognitiva como emocional. Durante las interacciones, es capaz de ofrecer respuestas que se ajustan mejor al estado emocional del usuario, teniendo en cuenta factores como el tono y la velocidad de habla. Esto permite que la comunicación supere un simple intercambio unidireccional de información y evolucione hacia un diálogo más genuino y similar al humano, lleno de empatía.
Personalización flexible: Creando perfiles de IA a medida
Para satisfacer las diversas necesidades de diferentes escenarios de aplicación, StepAudio 2.5 Realtime cuenta con una opción altamente adaptable para personalizar los perfiles de IA. Tanto si los usuarios necesitan un asistente profesional y fiable para el trabajo como un compañero de conversación animado para entretenimiento, los desarrolladores y usuarios finales pueden asignar rasgos de personalidad y estilos lingüísticos específicos a la IA según sus requisitos reales. Este nivel de personalización tiene el potencial de ampliar significativamente el ámbito de aplicación de los modelos de voz en tiempo real en industrias como la educación, el entretenimiento y los negocios.
Disponibilidad comercial total: Los modelos de lenguaje grande nacionales aceleran su crecimiento
Actualmente, Jieque Star ha anunciado que StepAudio 2.5 Realtime ya está completamente disponible para su uso. Esto significa que los desarrolladores y socios pueden acceder de inmediato a esta tecnología de vanguardia e iniciar pruebas con ella.








 Anthropic lanza Claude Haiku 5.5, reduciendo los costos de los modelos pequeños en un 75% y permitiendo a los usuarios ajustar la intensidad de inferencia
El 8 de octubre, Anthropic presentó su modelo más eficiente y capaz hasta la fecha: Claude Haiku 5.5. Posicionado como el modelo pequeño más rápido y capaz de la gama de Anthropic, está diseñado para aplicaciones de alta frecuencia y sensibles al cos
 Claude presenta el primer mapa completo del cielo en ultravioleta, que cartografía 119 millones de estrellas
Con la poderosa asistencia de Claude, el modelo de lenguaje grande de Anthropic, los astrofísicos han generado con éxito el primer mapa completo del cielo en ultravioleta de la historia. Este vasto catálogo estelar, que incluye 119 millones de estrel
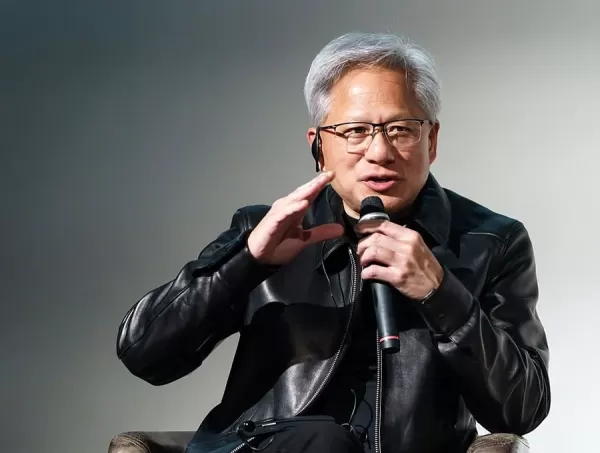 Cómo AWS y NVIDIA están impulsando la IA agentiva y la IA física
Jensen Huang, director ejecutivo de NVIDIA (Crédito: Tomohiro Ohsumi/Getty Images)NVIDIA, de Jensen Huang, y AWS amplían su colaboración global con el despliegue de 2 millones de GPU para impulsar la

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












