


 Maison
Google TurboQuant réduit de six fois la taille des grands modèles, allégeant ainsi la charge sur la mémoire
Les goulots d'étranglement liés à la mémoire constituent depuis longtemps un obstacle majeur aux performances dans le processus de raisonnement des grands modèles linguistiques (LLM). Lorsque l’IA traite des textes volumineux ou génère des réponses complexes, le cache KV (Key-Value Cache) — une forme de mémoire de travail — s’étend rapidement, entraînant des ralentissements, voire des plantages. Pour remédier à ce problème, Google Research a présenté le 26 mars 2026 TurboQuant, une nouvelle technologie de compression de la mémoire pour l’IA.
La principale avancée de TurboQuant réside dans sa capacité à réduire l’utilisation de la mémoire cache à un sixième de sa taille d’origine sans compromettre la précision du modèle, tout en multipliant par huit la vitesse d’inférence.
Surmonter le goulot d’étranglement du cache KV : une mémoire plus intelligente, une IA plus rapide
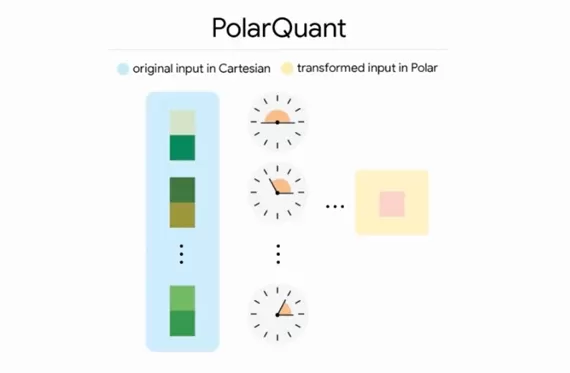
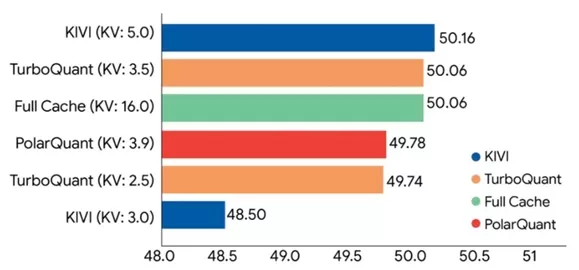
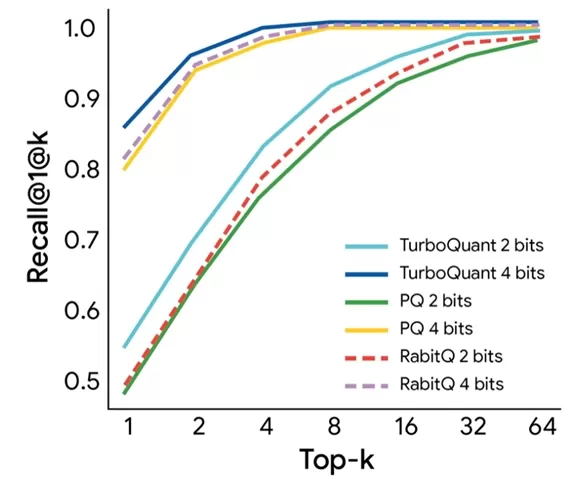
TurboQuant marque une nouvelle étape importante dans l’efficacité opérationnelle de l’IA. Il utilise un schéma avancé de quantification vectorielle qui combine la méthode de quantification PolarQuant et l’approche d’optimisation QJL. Lors de tests rigoureux menés sur des modèles open source populaires tels que Gemma et Mistral, TurboQuant a démontré une grande adaptabilité, compressant efficacement les caches clé-valeur à 3 bits sans nécessiter de pré-entraînement ni de réglage fin. Lors du test de contexte long « l’aiguille dans la botte de foin », qui simule des scénarios réalistes et complexes, TurboQuant n’a enregistré aucune perte de précision — ce qui signifie que même après une réduction significative de la taille, l’IA conserve son intelligence d’origine et la précision de sa mémoire.
Efficacité matérielle maximale : accélération multipliée par 8 sur les accélérateurs H100
Au-delà de la réduction de la mémoire, TurboQuant excelle également dans l’utilisation du matériel. Sur les accélérateurs GPU H100 haute performance, la version TurboQuant optimisée en 4 bits s’exécute 8 fois plus vite que la version de référence non quantifiée en 32 bits.
Article connexe
 Google dévoile le mode vidéo « Veo 3.1 Lite », offrant aux abonnés Ultra un nombre illimité de créations
Google a lancé un nouveau mode de génération de vidéos, « Veo 3.1 - Lite [Faible priorité] », réservé aux abonnés Ultra afin de stimuler la production créative et d’optimiser la rentabilité. Le princi
L'intégration avancée de ChatGPT donne accès à 300 000 films et séries télévisées par simple conversation
Alors que les services de streaming saturent le marché avec un contenu infini, aider les utilisateurs à faire le tri pour trouver ce qu’ils recherchent réellement est devenu un défi majeur pour le sec
Comment optimiser les Core Web Vitals pour améliorer son référencement naturel
Transformez votre processus de montage vidéo grâce à des transcriptions générées par l'IASommaire :IntroductionPrincipaux avantages de la transcription automatiséeGarantir la précision et affiner le r
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Les goulots d'étranglement liés à la mémoire constituent depuis longtemps un obstacle majeur aux performances dans le processus de raisonnement des grands modèles linguistiques (LLM). Lorsque l’IA traite des textes volumineux ou génère des réponses complexes, le cache KV (Key-Value Cache) — une forme de mémoire de travail — s’étend rapidement, entraînant des ralentissements, voire des plantages. Pour remédier à ce problème, Google Research a présenté le 26 mars 2026 TurboQuant, une nouvelle technologie de compression de la mémoire pour l’IA.
La principale avancée de TurboQuant réside dans sa capacité à réduire l’utilisation de la mémoire cache à un sixième de sa taille d’origine sans compromettre la précision du modèle, tout en multipliant par huit la vitesse d’inférence.
Surmonter le goulot d’étranglement du cache KV : une mémoire plus intelligente, une IA plus rapide
TurboQuant marque une nouvelle étape importante dans l’efficacité opérationnelle de l’IA. Il utilise un schéma avancé de quantification vectorielle qui combine la méthode de quantification PolarQuant et l’approche d’optimisation QJL. Lors de tests rigoureux menés sur des modèles open source populaires tels que Gemma et Mistral, TurboQuant a démontré une grande adaptabilité, compressant efficacement les caches clé-valeur à 3 bits sans nécessiter de pré-entraînement ni de réglage fin. Lors du test de contexte long « l’aiguille dans la botte de foin », qui simule des scénarios réalistes et complexes, TurboQuant n’a enregistré aucune perte de précision — ce qui signifie que même après une réduction significative de la taille, l’IA conserve son intelligence d’origine et la précision de sa mémoire.
Efficacité matérielle maximale : accélération multipliée par 8 sur les accélérateurs H100
Au-delà de la réduction de la mémoire, TurboQuant excelle également dans l’utilisation du matériel. Sur les accélérateurs GPU H100 haute performance, la version TurboQuant optimisée en 4 bits s’exécute 8 fois plus vite que la version de référence non quantifiée en 32 bits.








 Google dévoile le mode vidéo « Veo 3.1 Lite », offrant aux abonnés Ultra un nombre illimité de créations
Google a lancé un nouveau mode de génération de vidéos, « Veo 3.1 - Lite [Faible priorité] », réservé aux abonnés Ultra afin de stimuler la production créative et d’optimiser la rentabilité. Le princi
 L'intégration avancée de ChatGPT donne accès à 300 000 films et séries télévisées par simple conversation
Alors que les services de streaming saturent le marché avec un contenu infini, aider les utilisateurs à faire le tri pour trouver ce qu’ils recherchent réellement est devenu un défi majeur pour le sec
 Comment optimiser les Core Web Vitals pour améliorer son référencement naturel
Transformez votre processus de montage vidéo grâce à des transcriptions générées par l'IASommaire :IntroductionPrincipaux avantages de la transcription automatiséeGarantir la précision et affiner le r

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












