


 Lar
O Google TurboQuant reduz modelos grandes em seis vezes, aliviando a pressão sobre a memória
Os gargalos de memória têm sido, há muito tempo, um grande obstáculo ao desempenho no processo de raciocínio dos grandes modelos de linguagem (LLMs). Quando a IA lida com textos extensos ou gera respostas complexas, o cache KV (Key-Value Cache) — uma forma de memória de trabalho — se expande rapidamente, levando a lentidão ou falhas no sistema. Para resolver isso, o Google Research lançou o TurboQuant, uma nova tecnologia de compressão de memória para IA, em 26 de março de 2026.
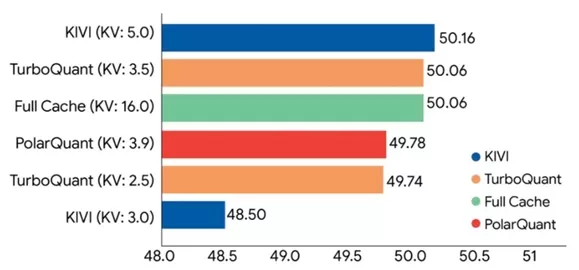
A principal inovação do TurboQuant é sua capacidade de reduzir o uso da memória de cache para um sexto do tamanho original sem comprometer a precisão do modelo, ao mesmo tempo em que proporciona um impressionante aumento de oito vezes na velocidade de inferência.
Superando o gargalo do cache KV: memória mais inteligente, IA mais rápida
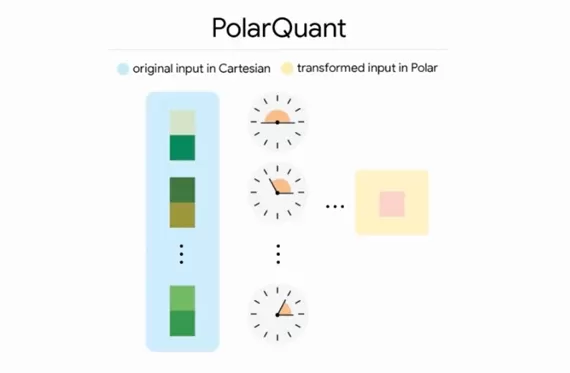
O TurboQuant representa um novo marco na eficiência operacional da IA. Ele emprega um esquema avançado de quantização vetorial que combina o método de quantização PolarQuant com a abordagem de otimização QJL. Em testes rigorosos com modelos populares de código aberto, como Gemma e Mistral, o TurboQuant demonstrou robusta adaptabilidade, compactando com eficiência caches de chave-valor para 3 bits sem a necessidade de pré-treinamento ou ajuste fino. No teste de contexto longo “agulha no palheiro”, que simula cenários realistas e complexos, o TurboQuant alcançou perda de precisão zero — o que significa que, mesmo após uma redução significativa de tamanho, a IA mantém sua inteligência original e a precisão da memória.
Eficiência máxima de hardware: aceleração de 8x em aceleradores H100
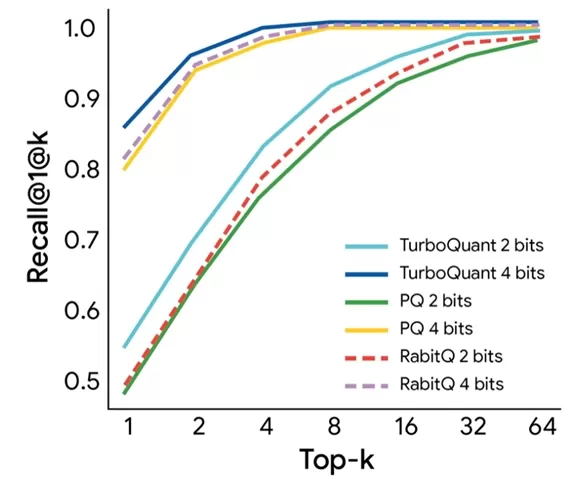
Além da redução de memória, o TurboQuant também se destaca na utilização de hardware. Em aceleradores de GPU H100 de alto desempenho, o TurboQuant otimizado para 4 bits é 8 vezes mais rápido do que a linha de base não quantizada de 32 bits.
Artigo relacionado
 A Tencent apresenta o Agente Criativo de IA Miora, permitindo que iniciantes em design gerem soluções visuais completas com um clique
A Tencent lançou oficialmente o Miora, seu mais recente agente criativo de IA, tornando o design inteligente acessível a um público mais amplo. Para incentivar a adoção, a plataforma concede a cada novo usuário registrado 1.000 créditos gratuitos par
O parceiro de Lady Gaga apoia empresa de biotecnologia que usa pele viva para treinar IA em pesquisa e desenvolvimento na área de beleza
Operando longe dos holofotes do Vale do Silício, a startup de biotecnologia Outer Biosciences está redefinindo os fundamentos da beleza e da pesquisa médica. Co-fundada por Michael Polansky, parceiro
Spotify para Label Perfis de Persona de IA, Exclua Música das Recomendações
O Spotify anunciou na terça-feira que começará a rotular artistas gerados por IA com etiquetas de perfil “Persona de IA” e excluirá suas faixas das recomendações editoriais e algorítmicas.A partir de meados de setembro, os usuários do Spotify verão c
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
Os gargalos de memória têm sido, há muito tempo, um grande obstáculo ao desempenho no processo de raciocínio dos grandes modelos de linguagem (LLMs). Quando a IA lida com textos extensos ou gera respostas complexas, o cache KV (Key-Value Cache) — uma forma de memória de trabalho — se expande rapidamente, levando a lentidão ou falhas no sistema. Para resolver isso, o Google Research lançou o TurboQuant, uma nova tecnologia de compressão de memória para IA, em 26 de março de 2026.
A principal inovação do TurboQuant é sua capacidade de reduzir o uso da memória de cache para um sexto do tamanho original sem comprometer a precisão do modelo, ao mesmo tempo em que proporciona um impressionante aumento de oito vezes na velocidade de inferência.
Superando o gargalo do cache KV: memória mais inteligente, IA mais rápida
O TurboQuant representa um novo marco na eficiência operacional da IA. Ele emprega um esquema avançado de quantização vetorial que combina o método de quantização PolarQuant com a abordagem de otimização QJL. Em testes rigorosos com modelos populares de código aberto, como Gemma e Mistral, o TurboQuant demonstrou robusta adaptabilidade, compactando com eficiência caches de chave-valor para 3 bits sem a necessidade de pré-treinamento ou ajuste fino. No teste de contexto longo “agulha no palheiro”, que simula cenários realistas e complexos, o TurboQuant alcançou perda de precisão zero — o que significa que, mesmo após uma redução significativa de tamanho, a IA mantém sua inteligência original e a precisão da memória.
Eficiência máxima de hardware: aceleração de 8x em aceleradores H100
Além da redução de memória, o TurboQuant também se destaca na utilização de hardware. Em aceleradores de GPU H100 de alto desempenho, o TurboQuant otimizado para 4 bits é 8 vezes mais rápido do que a linha de base não quantizada de 32 bits.








 A Tencent apresenta o Agente Criativo de IA Miora, permitindo que iniciantes em design gerem soluções visuais completas com um clique
A Tencent lançou oficialmente o Miora, seu mais recente agente criativo de IA, tornando o design inteligente acessível a um público mais amplo. Para incentivar a adoção, a plataforma concede a cada novo usuário registrado 1.000 créditos gratuitos par
 O parceiro de Lady Gaga apoia empresa de biotecnologia que usa pele viva para treinar IA em pesquisa e desenvolvimento na área de beleza
Operando longe dos holofotes do Vale do Silício, a startup de biotecnologia Outer Biosciences está redefinindo os fundamentos da beleza e da pesquisa médica. Co-fundada por Michael Polansky, parceiro
 Spotify para Label Perfis de Persona de IA, Exclua Música das Recomendações
O Spotify anunciou na terça-feira que começará a rotular artistas gerados por IA com etiquetas de perfil “Persona de IA” e excluirá suas faixas das recomendações editoriais e algorítmicas.A partir de meados de setembro, os usuários do Spotify verão c

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












