Descubre herramientas de IA de calidad
Reúna las principales herramientas de inteligencia artificial del mundo para ayudar a mejorar la eficiencia laboral

Artículos publicados por JackLewis
Douyin lanza un canal de denuncia por uso indebido de la voz. Grok Build añade memoria a largo plazo para proyectos. Doudou se asocia con Volcano Engine para un asistente de IA para coches. Alibaba Cloud lanza el modelo de vídeo Wan3.0 que soporta tomas de 30 segundos. Baidu promueve cuerpos inteligentes industriales para la monetización de grandes modelos. Los productos de MiniMax entran en la formación nacional de IA de Singapur. Anthropic unifica Claude Cowork y Chat. Tencent prueba la herramienta de voz para escritorio ChatterFly para la generación de informes.
Douyin lanza un canal de denuncia por uso indebido de la voz. Grok Build añade memoria a largo plazo para proyectos. Doudou se asocia con Volcano Engine para un asistente de IA para coches. Alibaba Cloud lanza el modelo de vídeo Wan3.0 que soporta tomas de 30 segundos. Baidu promueve cuerpos inteligentes industriales para la monetización de grandes modelos. Los productos de MiniMax entran en la formación nacional de IA de Singapur. Anthropic unifica Claude Cowork y Chat. Tencent prueba la herramienta de voz para escritorio ChatterFly para la generación de informes.
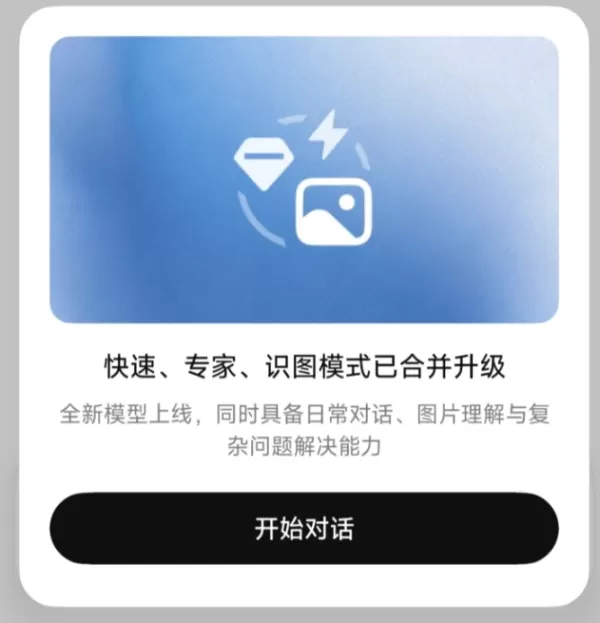
DeepSeek ha unificado sus modos «rápido», «experto» e «imagen» en un único modo inteligente que detecta automáticamente la complejidad de la consulta y activa las capacidades visuales. El próximo modelo V4.1 Flash supera al V4 Pro en cuanto a relación rendimiento-coste y velocidad. La versión V4 Pro se retirará el 14 de septiembre de 2026 y el tráfico se redirigirá a la versión V4.1 Flash con nuevas tarifas. Los precios de la serie Flash se ajustarán el 10 de septiembre de 2026, con un coste de 0,02 yuanes por acierto en la caché de entrada en horas valle, 1 yuan por fallo en la caché y 4 yuanes por salida, mientras que los precios en horas punta duplicarán las tarifas de las horas valle.
DeepSeek ha unificado sus modos «rápido», «experto» e «imagen» en un único modo inteligente que detecta automáticamente la complejidad de la consulta y activa las capacidades visuales. El próximo modelo V4.1 Flash supera al V4 Pro en cuanto a relación rendimiento-coste y velocidad. La versión V4 Pro se retirará el 14 de septiembre de 2026 y el tráfico se redirigirá a la versión V4.1 Flash con nuevas tarifas. Los precios de la serie Flash se ajustarán el 10 de septiembre de 2026, con un coste de 0,02 yuanes por acierto en la caché de entrada en horas valle, 1 yuan por fallo en la caché y 4 yuanes por salida, mientras que los precios en horas punta duplicarán las tarifas de las horas valle.
Dazhong Dianping aumentará la inversión en su ecosistema de contenidos reales, recompensando a los usuarios de alta calidad y mejorando al mismo tiempo su sistema de gestión de reseñas AIGC para detectar y eliminar las reseñas falsas o de baja calidad generadas por IA, con el objetivo de recuperar la confianza y ofrecer consejos de consumo auténticos.
Dazhong Dianping aumentará la inversión en su ecosistema de contenidos reales, recompensando a los usuarios de alta calidad y mejorando al mismo tiempo su sistema de gestión de reseñas AIGC para detectar y eliminar las reseñas falsas o de baja calidad generadas por IA, con el objetivo de recuperar la confianza y ofrecer consejos de consumo auténticos.

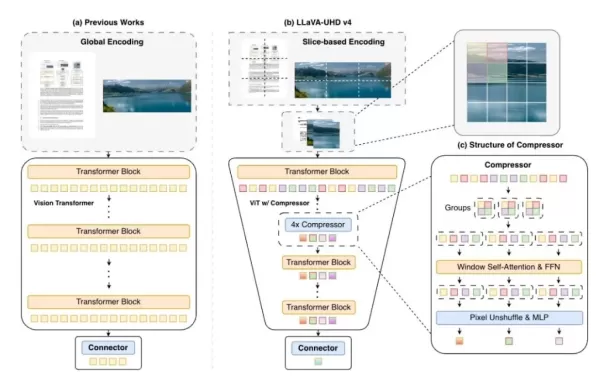
Mingshi Intelligence, la Universidad de Tsinghua y OpenBMB han presentado el modelo multimodal para el borde MiniCPM-V4.6. Con solo 1.300 millones de parámetros, alcanza un rendimiento de primer nivel entre los modelos de tamaño similar. Optimizado para su implementación en el borde, reduce las necesidades de memoria a 6 GB y aumenta significativamente la velocidad de inferencia. El modelo aprovecha la tecnología LLaVA-UHD v4 para reducir la sobrecarga de codificación. Es de código abierto, es compatible con los principales marcos de desarrollo y está siendo implementado por socios como Lenovo y Xiaomi en aplicaciones automovilísticas, de hogar inteligente e industriales.
Mingshi Intelligence, la Universidad de Tsinghua y OpenBMB han presentado el modelo multimodal para el borde MiniCPM-V4.6. Con solo 1.300 millones de parámetros, alcanza un rendimiento de primer nivel entre los modelos de tamaño similar. Optimizado para su implementación en el borde, reduce las necesidades de memoria a 6 GB y aumenta significativamente la velocidad de inferencia. El modelo aprovecha la tecnología LLaVA-UHD v4 para reducir la sobrecarga de codificación. Es de código abierto, es compatible con los principales marcos de desarrollo y está siendo implementado por socios como Lenovo y Xiaomi en aplicaciones automovilísticas, de hogar inteligente e industriales.
SenseTime presentó importantes actualizaciones de su plataforma Seko AI en una conferencia sobre el ecosistema celebrada en Xi'an. La herramienta de vídeo AIGC, que cuenta con más de 700 000 creadores y 1 300 usuarios empresariales, está transformando la producción de anime y miniseries. Ha lanzado Seko Space, un nuevo flujo de trabajo para la gestión estandarizada de activos y la colaboración, así como un programa de apoyo a las empresas. La plataforma afirma reducir los ciclos de producción entre un 80 % y un 90 % y ha incubado populares series cortas. La estrategia de SenseTime en Xi'an la posiciona como proveedora de infraestructura para la industria.
SenseTime presentó importantes actualizaciones de su plataforma Seko AI en una conferencia sobre el ecosistema celebrada en Xi'an. La herramienta de vídeo AIGC, que cuenta con más de 700 000 creadores y 1 300 usuarios empresariales, está transformando la producción de anime y miniseries. Ha lanzado Seko Space, un nuevo flujo de trabajo para la gestión estandarizada de activos y la colaboración, así como un programa de apoyo a las empresas. La plataforma afirma reducir los ciclos de producción entre un 80 % y un 90 % y ha incubado populares series cortas. La estrategia de SenseTime en Xi'an la posiciona como proveedora de infraestructura para la industria.
Ant Group ha lanzado Ling-2.6-flash, un modelo de IA con 104 000 millones de parámetros, de los cuales solo se activan 7 400 millones durante su uso. Alcanza un alto rendimiento con una fracción del coste de recursos que suponen sus competidores, utilizando un 90 % menos de tokens por tarea. El modelo se sometió a pruebas de estrés antes de su lanzamiento, gestionando 100 000 millones de tokens al día, lo que pone de manifiesto la fuerte demanda del mercado de una IA eficiente a gran escala.
Ant Group ha lanzado Ling-2.6-flash, un modelo de IA con 104 000 millones de parámetros, de los cuales solo se activan 7 400 millones durante su uso. Alcanza un alto rendimiento con una fracción del coste de recursos que suponen sus competidores, utilizando un 90 % menos de tokens por tarea. El modelo se sometió a pruebas de estrés antes de su lanzamiento, gestionando 100 000 millones de tokens al día, lo que pone de manifiesto la fuerte demanda del mercado de una IA eficiente a gran escala.
La startup de infraestructura de IA Upscale AI busca recaudar entre 180 y 200 millones de dólares en una nueva ronda de financiación con el objetivo de alcanzar una valoración de 2000 millones de dólares. Esta tercera ronda sigue a las anteriores, en las que se recaudaron 100 millones en la ronda inicial y 200 millones en la ronda de financiación de serie A. La empresa, respaldada por inversores como Tiger Global, se centra en el desarrollo de chips personalizados y de infraestructura de comunicación entre chips, a pesar de que aún no ha lanzado ningún producto al mercado.
La startup de infraestructura de IA Upscale AI busca recaudar entre 180 y 200 millones de dólares en una nueva ronda de financiación con el objetivo de alcanzar una valoración de 2000 millones de dólares. Esta tercera ronda sigue a las anteriores, en las que se recaudaron 100 millones en la ronda inicial y 200 millones en la ronda de financiación de serie A. La empresa, respaldada por inversores como Tiger Global, se centra en el desarrollo de chips personalizados y de infraestructura de comunicación entre chips, a pesar de que aún no ha lanzado ningún producto al mercado.
Los documentos filtrados revelan que OpenAI pagó a Microsoft 494 millones de dólares en 2024 y 866 millones de dólares en el tercer trimestre de 2025 en virtud de un acuerdo de reparto de ingresos Esto implica unos ingresos de OpenAI de al menos 25.000 y 433.000 millones de dólares respectivamente Sin embargo, el análisis sugiere que los costes informáticos de OpenAI para la inferencia de IA pueden haber superado sus ingresos, lo que plantea dudas sobre su rentabilidad
Los documentos filtrados revelan que OpenAI pagó a Microsoft 494 millones de dólares en 2024 y 866 millones de dólares en el tercer trimestre de 2025 en virtud de un acuerdo de reparto de ingresos Esto implica unos ingresos de OpenAI de al menos 25.000 y 433.000 millones de dólares respectivamente Sin embargo, el análisis sugiere que los costes informáticos de OpenAI para la inferencia de IA pueden haber superado sus ingresos, lo que plantea dudas sobre su rentabilidad