


 Heim
Cursor Composer 2 vs. Claude Opus 4.6: Benchmark-Test entfacht neue Debatte über KI-Programmierung
Am 19. März veröffentlichte Cursor offiziell sein hauseigenes Programmiermodell Composer 2. Die Ankündigung löste in der Entwickler-Community sofort Diskussionen aus – laut Cursor erzielte Composer 2 bei Terminal-Bench 2.0 eine Punktzahl von 61,7 % und übertraf damit deutlich die 58,0 % von Claude Opus 4.6 unter identischen Testbedingungen.
Wurde das Flaggschiff-Modell von Anthropic von einem Modell übertroffen, das in die eigene IDE integriert ist? Als sich die Nachricht verbreitete, entbrannten schnell Debatten.
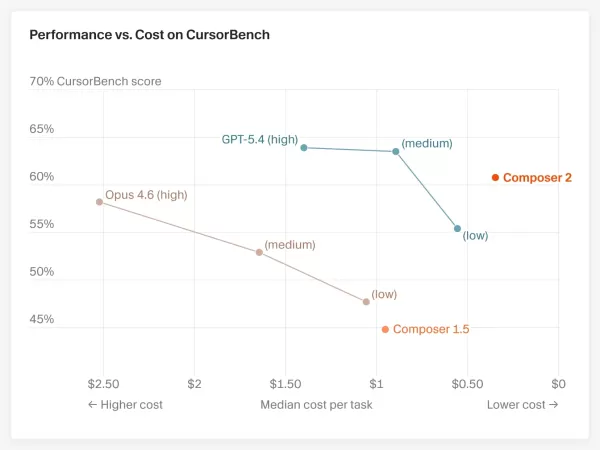
Drei wichtige Benchmark-Ergebnisse
Cursor veröffentlichte drei Sätze von Benchmark-Ergebnissen, die alle öffentlich zugänglich sind:
Terminal-Bench 2.0 (Terminal-Codierungsaufgaben im Agent-Stil): Composer 2 erzielte 61,7 % und schlug damit die 58,0 %von Claude Opus 4.6. OpenAI GPT-5.4 liegt jedoch mit 75,1 %weiterhin vorne. CursorBench (realistische Programmier-Szenarien innerhalb von Cursor): Composer 2 erreichte 61,3 %, was einen deutlichen Sprung gegenüber den 44,2 % des Vorgängers Composer 1.5 darstellt und auch über den 58,2 %von Claude Opus 4.6 liegt. SWE-bench Multilingual (mehrsprachige Softwareentwicklung): Composer 2 erreichte 73,7 %, eine bemerkenswerte Verbesserung gegenüber seinem Vorgänger.Ein Detail ist jedoch erwähnenswert: Anthropic berichtete zuvor, dass Claude Opus 4.6 unter optimierten Einstellungen 65,4 % auf Terminal-Bench 2.0 erzielte, was deutlich über den von Cursor genannten 58,0 % liegt. Die Diskrepanz rührt vom Testframework her – Cursor verwendete Agent-Umgebungen von Drittanbietern wie Harbor und mittelte die Ergebnisse aus fünf Durchläufen, während die Zahlen von Anthropic aus der eigenen optimierten Konfiguration stammten. Diese beiden Zahlenreihen sind nicht direkt vergleichbar, da sie unterschiedliche Referenzsysteme verwenden. Cursor hat dies nicht verschwiegen; in der Ankündigung wurde ausdrücklich darauf hingewiesen, dass „die Ergebnisse vom Agenten, dem Test-Harness und den Einstellungen abhängen“.
Kosten bei nur einem Zehntel von Opus 4.6
Die Kosteneffizienz ist der wahre versteckte Vorteil von Composer 2.
Mit einem Preis von 0,50 $ / 2,50 $ pro Million Input-/Output-Token im Vergleich zu 5 $ / 25 $ bei Claude Opus 4.6 und 2,5 $ / 15 $ bei GPT-5.4 ist der Kontrast eklatant. Cursor erklärt, dass Composer 2 von Grund auf für Codierungsaufgaben mit langfristigem Horizont entwickelt wurde und dabei seine proprietäre RL-Trainings- und „Selbstzusammenfassungs“-Technologie nutzt, um sowohl Latenz als auch Kosten zu senken – was sie als „Frontier Intelligence + extreme Geschwindigkeit“ bezeichnen.
Composer 2 ist das dritte hauseigene Modell von Cursor und folgt auf Composer 1 (Oktober 2025) und Version 1.5 (Februar 2026). Diese Version legt den Schwerpunkt auf „langfristige Aufgaben“ und macht eine schnellere, schlankere Variante zum Standardmodell in der Cursor-IDE.
Was dieser „Aufstieg aus der Asche“ bedeutet
Die Entscheidung von Cursor, sein Modell direkt mit Opus 4.6 zu vergleichen, signalisiert eine Verschiebung in der breiteren Landschaft der KI-Codierungstools.
OpenAI und Anthropic konkurrieren um allgemeine Spitzenleistungen, während vertikale Tool-Anbieter wie Cursor einen anderen Weg eingeschlagen haben: Sie optimieren die Leistung bei spezifischen Aufgaben auf ein außergewöhnliches Niveau und nutzen dann Preisvorteile, um sich abzuheben. Medien wie VentureBeat und The New Stack stellten fest, dass Composer 2 die praktische Einführung von „Multi-Model-Routing“ beschleunigen wird – wobei Opus oder GPT für komplexe Schlussfolgerungen genutzt werden und für alltägliche, hochfrequente Programmieraufgaben auf Composer 2 umgeschaltet wird, um so Vorteile auf beiden Seiten zu erzielen.
Claude Opus 4.6 wurde am 5. Februar veröffentlicht und führte in mehreren Benchmarks, darunter Terminal-Bench 2.0, Humanity’s Last Exam und GDPval-AA. Die neuen Ergebnisse von Cursor werfen zumindest Fragen hinsichtlich dieser Dominanz im spezialisierten Programmierbereich auf.
Die Reaktionen der Entwickler waren bisher überwiegend positiv, doch viele geben an, dass sie erst die Leistung in realen Projekten sehen wollen, bevor sie Schlussfolgerungen ziehen – eine berechtigte Haltung, da Benchmarks eben nur Benchmarks sind. Cursor hat Composer 2 für Abonnenten bereits als kostenlose Testversion innerhalb der IDE zur Verfügung gestellt.
Datenquelle: Offizielle Ankündigungen von Cursor und führende Tech-Medien, Stand: 20. März 2026. Aktuelle Ranglisten können unter tbench.ai oder auf der Website von Cursor eingesehen werden.
Verwandter Artikel
 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch
Alibaba Super Cup: Qwen3.8-Max debütiert mit verbesserten Coding- und Bürotools
Alibaba hat offiziell Qwen3.8-Max vorgestellt, ein hochmodernes Foundation-Modell mit 2,4 Billionen Parametern. Diese bedeutende KI-Entwicklung bietet erhebliche Leistungssteigerungen in Kernbereichen wie Programmierung und professionelle Büroaufgabe
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (0)
Am 19. März veröffentlichte Cursor offiziell sein hauseigenes Programmiermodell Composer 2. Die Ankündigung löste in der Entwickler-Community sofort Diskussionen aus – laut Cursor erzielte Composer 2 bei Terminal-Bench 2.0 eine Punktzahl von 61,7 % und übertraf damit deutlich die 58,0 % von Claude Opus 4.6 unter identischen Testbedingungen.
Wurde das Flaggschiff-Modell von Anthropic von einem Modell übertroffen, das in die eigene IDE integriert ist? Als sich die Nachricht verbreitete, entbrannten schnell Debatten.
Drei wichtige Benchmark-Ergebnisse
Cursor veröffentlichte drei Sätze von Benchmark-Ergebnissen, die alle öffentlich zugänglich sind:
Terminal-Bench 2.0 (Terminal-Codierungsaufgaben im Agent-Stil): Composer 2 erzielte 61,7 % und schlug damit die 58,0 %von Claude Opus 4.6. OpenAI GPT-5.4 liegt jedoch mit 75,1 %weiterhin vorne. CursorBench (realistische Programmier-Szenarien innerhalb von Cursor): Composer 2 erreichte 61,3 %, was einen deutlichen Sprung gegenüber den 44,2 % des Vorgängers Composer 1.5 darstellt und auch über den 58,2 %von Claude Opus 4.6 liegt. SWE-bench Multilingual (mehrsprachige Softwareentwicklung): Composer 2 erreichte 73,7 %, eine bemerkenswerte Verbesserung gegenüber seinem Vorgänger.Ein Detail ist jedoch erwähnenswert: Anthropic berichtete zuvor, dass Claude Opus 4.6 unter optimierten Einstellungen 65,4 % auf Terminal-Bench 2.0 erzielte, was deutlich über den von Cursor genannten 58,0 % liegt. Die Diskrepanz rührt vom Testframework her – Cursor verwendete Agent-Umgebungen von Drittanbietern wie Harbor und mittelte die Ergebnisse aus fünf Durchläufen, während die Zahlen von Anthropic aus der eigenen optimierten Konfiguration stammten. Diese beiden Zahlenreihen sind nicht direkt vergleichbar, da sie unterschiedliche Referenzsysteme verwenden. Cursor hat dies nicht verschwiegen; in der Ankündigung wurde ausdrücklich darauf hingewiesen, dass „die Ergebnisse vom Agenten, dem Test-Harness und den Einstellungen abhängen“.
Kosten bei nur einem Zehntel von Opus 4.6
Die Kosteneffizienz ist der wahre versteckte Vorteil von Composer 2.
Mit einem Preis von 0,50 $ / 2,50 $ pro Million Input-/Output-Token im Vergleich zu 5 $ / 25 $ bei Claude Opus 4.6 und 2,5 $ / 15 $ bei GPT-5.4 ist der Kontrast eklatant. Cursor erklärt, dass Composer 2 von Grund auf für Codierungsaufgaben mit langfristigem Horizont entwickelt wurde und dabei seine proprietäre RL-Trainings- und „Selbstzusammenfassungs“-Technologie nutzt, um sowohl Latenz als auch Kosten zu senken – was sie als „Frontier Intelligence + extreme Geschwindigkeit“ bezeichnen.
Composer 2 ist das dritte hauseigene Modell von Cursor und folgt auf Composer 1 (Oktober 2025) und Version 1.5 (Februar 2026). Diese Version legt den Schwerpunkt auf „langfristige Aufgaben“ und macht eine schnellere, schlankere Variante zum Standardmodell in der Cursor-IDE.
Was dieser „Aufstieg aus der Asche“ bedeutet
Die Entscheidung von Cursor, sein Modell direkt mit Opus 4.6 zu vergleichen, signalisiert eine Verschiebung in der breiteren Landschaft der KI-Codierungstools.
OpenAI und Anthropic konkurrieren um allgemeine Spitzenleistungen, während vertikale Tool-Anbieter wie Cursor einen anderen Weg eingeschlagen haben: Sie optimieren die Leistung bei spezifischen Aufgaben auf ein außergewöhnliches Niveau und nutzen dann Preisvorteile, um sich abzuheben. Medien wie VentureBeat und The New Stack stellten fest, dass Composer 2 die praktische Einführung von „Multi-Model-Routing“ beschleunigen wird – wobei Opus oder GPT für komplexe Schlussfolgerungen genutzt werden und für alltägliche, hochfrequente Programmieraufgaben auf Composer 2 umgeschaltet wird, um so Vorteile auf beiden Seiten zu erzielen.
Claude Opus 4.6 wurde am 5. Februar veröffentlicht und führte in mehreren Benchmarks, darunter Terminal-Bench 2.0, Humanity’s Last Exam und GDPval-AA. Die neuen Ergebnisse von Cursor werfen zumindest Fragen hinsichtlich dieser Dominanz im spezialisierten Programmierbereich auf.
Die Reaktionen der Entwickler waren bisher überwiegend positiv, doch viele geben an, dass sie erst die Leistung in realen Projekten sehen wollen, bevor sie Schlussfolgerungen ziehen – eine berechtigte Haltung, da Benchmarks eben nur Benchmarks sind. Cursor hat Composer 2 für Abonnenten bereits als kostenlose Testversion innerhalb der IDE zur Verfügung gestellt.
Datenquelle: Offizielle Ankündigungen von Cursor und führende Tech-Medien, Stand: 20. März 2026. Aktuelle Ranglisten können unter tbench.ai oder auf der Website von Cursor eingesehen werden.








 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
 OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch
 Alibaba Super Cup: Qwen3.8-Max debütiert mit verbesserten Coding- und Bürotools
Alibaba hat offiziell Qwen3.8-Max vorgestellt, ein hochmodernes Foundation-Modell mit 2,4 Billionen Parametern. Diese bedeutende KI-Entwicklung bietet erhebliche Leistungssteigerungen in Kernbereichen wie Programmierung und professionelle Büroaufgabe

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai












