


 首页
xFusion 将企业级人工智能的应用范围从边缘工作站扩展至液冷数据中心
在 ISC 2026 大会上,xFusion 展示了可扩展的企业级 AI 计算模型,该模型将从边缘设备到数据中心的硬件连接起来。
在汉堡展会上,企业技术采购方寻求的是实用的生产级框架。硬件选型过程往往忽视了物理运行极限,而依赖公共API则会泄露专有商业数据。
xFusion的工程师们针对这一问题推出了四层硬件产品组合。该部署架构可按顺序扩展处理能力:从单台工作站、工作组集群、企业办公设备,直至设施级超级节点。
个人边缘处理设备
工程师和专业人员需要专用的本地资源来处理复杂的3D渲染和建筑模拟任务。他们在将工作负载提交至集中式计算集群之前,会先在本地处理海量数据集。
xFusion 提供 FusionXtation X3 8000 Gen2 边缘计算节点作为基础层。企业可将这些工作站部署给需要本地执行参数数量在 700 亿至 2000 亿之间的模型的工作人员。
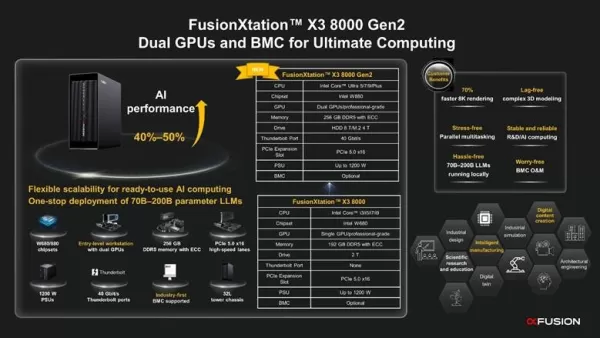
硬件配置采用英特尔酷睿Ultra处理器,搭配双专业级图形处理单元。内存配置包括最高256千兆字节的纠错DDR5内存,内部存储容量可达8太字节。
生产环境数据显示,与上一代硬件相比,8K渲染输出速度提升了70%,通用AI处理性能最高提升了50%。IT管理员可通过集成的基板管理控制器(BMC)进行远程管理。四个40千兆比特每秒的Thunderbolt端口负责外部数据传输。
工作组数据隔离设备
不受控的数据流会给受监管机构带来合规风险。外部应用程序市场会使企业网络暴露于恶意代码的威胁之下。开发团队必须安全地构建定制软件,以保护企业的知识产权。
xFusion 设计了 FusionXpark 设备,旨在满足这一团队级别的合规要求。该平台使工程部门能够在应用程序的初始设计阶段就符合监管标准。医学影像团队和金融建模人员可在与外部 API 完全隔离的环境中处理高度敏感的商业数据。
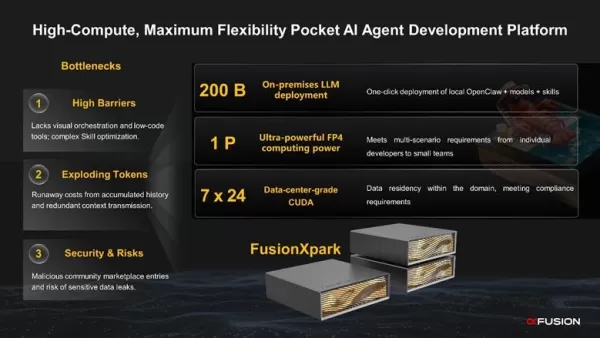
团队将两台独立的 FusionXpark 设备组合使用,可在原生 CUDA 环境中本地处理拥有 4,050 亿个参数的模型。该系统出厂时即预装 NVIDIA DGX OS。开发人员可立即访问所需的工具链。网络管理员可通过原生集成,将超载的处理需求安全地路由至 DGX Cloud。
企业令牌处理工具
高吞吐量的企业职能以难以维持的速度消耗着处理能力。冗余的上下文传输导致运营预算膨胀。
运营部门需要可预测的基础设施,以支持自动化的客户服务流程和复杂的财务审批。xFusion 推出的 TokenBox 是一款集中式企业处理设备。该设备通过单个本地部署,即可为整个公司提供令牌生成能力。
单个 TokenBox 节点具备运行 1.6 万亿参数模型的充足容量。这种部署模式避免了建设专用服务器机房所需的资本支出。
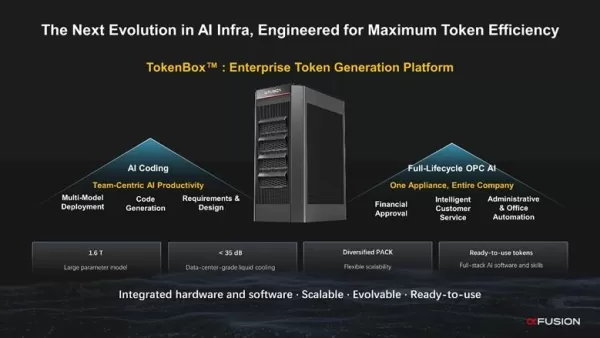
内部数据中心级液冷机制将运行中的噪音水平控制在35分贝以内,使设施管理人员能够将这些设备直接放置在普通办公环境中。预装的软件和技能可省去冗长的配置周期,从而加速投资回报。
数据中心计算引擎
要在跨国企业网络中扩展计算能力,需要先进的散热基础设施。最终部署层级完全专注于液冷机架和超级节点。
高密度基础设施套件可管理每机柜 240 千瓦的功率。硬件设计将原始电能直接转化为每秒浮点运算次数。自主研发的低损耗核心组件将单模块运营成本降低了 15%。
集中式企业集群依赖于集成在此超级节点架构中的高密度机架式硬件。FusionServer G6550 V8 推理服务器运行于此层级,最多可容纳十个双宽图形处理单元。
FusionPoD 液冷计算平台负责管理这些机架的热输出,实现了 1.06 的部分电源使用效率(PUE)。液冷回路通过石墨烯垫片和钻石冷板提取热量,其导热率可达每米开尔文 1200 瓦。
若无法持续输入数据,处理硬件将陷入停滞。 FusionOne DFS 存储解决方案为这些计算集群提供了基础数据架构。一个运行 72 个 NVMe 硬盘的三节点集群,可实现每秒 200 千兆字节的顺序读取带宽。该存储阵列可扩展至管理总容量达艾字节级,同时通过纠删码技术实现 94.1%的存储利用率。
负责评估基础设施部署框架的高管可直接访问 https://www.xfusion.com/en查阅产品技术规格。
相关文章
 Google AI Overview 推出热门新闻轮播,在摘要中嵌入实时突发新闻
2026年6月29日,Google 向部分用户推出了一项重要的搜索界面更新,在“AI 概览”模块中直接引入了“头条新闻”轮播功能。SEO 专家 Lily Ray 首先在 X 平台上发现了这一功能,这标志着 Google 在处理时效性查询方面的战略转变。此次更新旨在将静态的 AI 生成摘要与成熟媒体的实时报道相结合,确保用户在突发新闻事件中能够获取准确且不断更新的事实信息。此前,用户必须滚动经过大型的 AI 模块才能找到传统的新闻链接,这引发了业界关于 AI 分流出版商流量的担忧。新的设计在搜索结
如何针对谷歌日本和雅虎日本优化SEO
作为一名独立内容创作者,我经常需要处理来自各种在线来源的旧档案素材、用户生成视频片段以及压缩后的辅助镜头,而应对画质下降的问题一直让我头疼不已。 事实上,Wyzowl 最近的一份报告指出,89% 的视频营销人员认为视频能带来良好的投资回报率,这意味着观众对视频质量的期望比以往任何时候都更高。当你试图吸引观众注意力时,颗粒感强、像素化的画面已经无法满足需求了。最近,我决定测试AI Photo Gen
MiniMax 2.5 登顶全球使用量榜首,月营收超 1.5 亿美元;旗舰版 M3 预计上半年发布
中国大语言模型正以其在成本效益和工程卓越方面的声誉,在全球开发者生态系统中产生强劲势头。截至 2026 年 3 月 3 日,全球领先的 API 聚合平台 OpenRouter 的数据显示,国产模型呈现出前所未有的主导地位:MiniMax M2.5 位居全球调用量榜首,紧随其后的是 Kimi K2.5 和 GLM-5。这一“前三甲”阵容表明,中国提供商已通过更优的 AI 部署效率和强劲的开发者采用率,超越了国际竞争对手。七天内处理 3.07 万亿 Token:MiniMax 的快速扩张Min
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
在 ISC 2026 大会上,xFusion 展示了可扩展的企业级 AI 计算模型,该模型将从边缘设备到数据中心的硬件连接起来。
在汉堡展会上,企业技术采购方寻求的是实用的生产级框架。硬件选型过程往往忽视了物理运行极限,而依赖公共API则会泄露专有商业数据。
xFusion的工程师们针对这一问题推出了四层硬件产品组合。该部署架构可按顺序扩展处理能力:从单台工作站、工作组集群、企业办公设备,直至设施级超级节点。
个人边缘处理设备
工程师和专业人员需要专用的本地资源来处理复杂的3D渲染和建筑模拟任务。他们在将工作负载提交至集中式计算集群之前,会先在本地处理海量数据集。
xFusion 提供 FusionXtation X3 8000 Gen2 边缘计算节点作为基础层。企业可将这些工作站部署给需要本地执行参数数量在 700 亿至 2000 亿之间的模型的工作人员。
硬件配置采用英特尔酷睿Ultra处理器,搭配双专业级图形处理单元。内存配置包括最高256千兆字节的纠错DDR5内存,内部存储容量可达8太字节。
生产环境数据显示,与上一代硬件相比,8K渲染输出速度提升了70%,通用AI处理性能最高提升了50%。IT管理员可通过集成的基板管理控制器(BMC)进行远程管理。四个40千兆比特每秒的Thunderbolt端口负责外部数据传输。
工作组数据隔离设备
不受控的数据流会给受监管机构带来合规风险。外部应用程序市场会使企业网络暴露于恶意代码的威胁之下。开发团队必须安全地构建定制软件,以保护企业的知识产权。
xFusion 设计了 FusionXpark 设备,旨在满足这一团队级别的合规要求。该平台使工程部门能够在应用程序的初始设计阶段就符合监管标准。医学影像团队和金融建模人员可在与外部 API 完全隔离的环境中处理高度敏感的商业数据。
团队将两台独立的 FusionXpark 设备组合使用,可在原生 CUDA 环境中本地处理拥有 4,050 亿个参数的模型。该系统出厂时即预装 NVIDIA DGX OS。开发人员可立即访问所需的工具链。网络管理员可通过原生集成,将超载的处理需求安全地路由至 DGX Cloud。
企业令牌处理工具
高吞吐量的企业职能以难以维持的速度消耗着处理能力。冗余的上下文传输导致运营预算膨胀。
运营部门需要可预测的基础设施,以支持自动化的客户服务流程和复杂的财务审批。xFusion 推出的 TokenBox 是一款集中式企业处理设备。该设备通过单个本地部署,即可为整个公司提供令牌生成能力。
单个 TokenBox 节点具备运行 1.6 万亿参数模型的充足容量。这种部署模式避免了建设专用服务器机房所需的资本支出。
内部数据中心级液冷机制将运行中的噪音水平控制在35分贝以内,使设施管理人员能够将这些设备直接放置在普通办公环境中。预装的软件和技能可省去冗长的配置周期,从而加速投资回报。
数据中心计算引擎
要在跨国企业网络中扩展计算能力,需要先进的散热基础设施。最终部署层级完全专注于液冷机架和超级节点。
高密度基础设施套件可管理每机柜 240 千瓦的功率。硬件设计将原始电能直接转化为每秒浮点运算次数。自主研发的低损耗核心组件将单模块运营成本降低了 15%。
集中式企业集群依赖于集成在此超级节点架构中的高密度机架式硬件。FusionServer G6550 V8 推理服务器运行于此层级,最多可容纳十个双宽图形处理单元。
FusionPoD 液冷计算平台负责管理这些机架的热输出,实现了 1.06 的部分电源使用效率(PUE)。液冷回路通过石墨烯垫片和钻石冷板提取热量,其导热率可达每米开尔文 1200 瓦。
若无法持续输入数据,处理硬件将陷入停滞。 FusionOne DFS 存储解决方案为这些计算集群提供了基础数据架构。一个运行 72 个 NVMe 硬盘的三节点集群,可实现每秒 200 千兆字节的顺序读取带宽。该存储阵列可扩展至管理总容量达艾字节级,同时通过纠删码技术实现 94.1%的存储利用率。
负责评估基础设施部署框架的高管可直接访问 https://www.xfusion.com/en查阅产品技术规格。








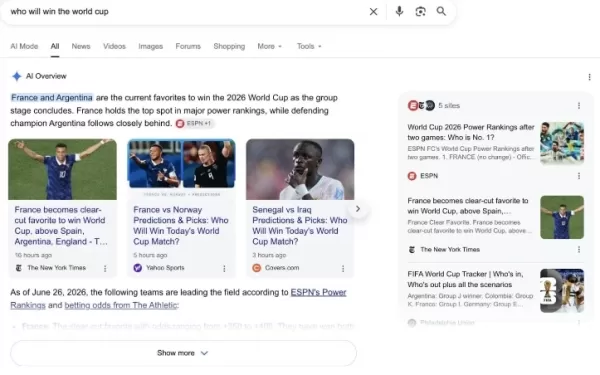 Google AI Overview 推出热门新闻轮播,在摘要中嵌入实时突发新闻
2026年6月29日,Google 向部分用户推出了一项重要的搜索界面更新,在“AI 概览”模块中直接引入了“头条新闻”轮播功能。SEO 专家 Lily Ray 首先在 X 平台上发现了这一功能,这标志着 Google 在处理时效性查询方面的战略转变。此次更新旨在将静态的 AI 生成摘要与成熟媒体的实时报道相结合,确保用户在突发新闻事件中能够获取准确且不断更新的事实信息。此前,用户必须滚动经过大型的 AI 模块才能找到传统的新闻链接,这引发了业界关于 AI 分流出版商流量的担忧。新的设计在搜索结
 如何针对谷歌日本和雅虎日本优化SEO
作为一名独立内容创作者,我经常需要处理来自各种在线来源的旧档案素材、用户生成视频片段以及压缩后的辅助镜头,而应对画质下降的问题一直让我头疼不已。 事实上,Wyzowl 最近的一份报告指出,89% 的视频营销人员认为视频能带来良好的投资回报率,这意味着观众对视频质量的期望比以往任何时候都更高。当你试图吸引观众注意力时,颗粒感强、像素化的画面已经无法满足需求了。最近,我决定测试AI Photo Gen
 MiniMax 2.5 登顶全球使用量榜首,月营收超 1.5 亿美元;旗舰版 M3 预计上半年发布
中国大语言模型正以其在成本效益和工程卓越方面的声誉,在全球开发者生态系统中产生强劲势头。截至 2026 年 3 月 3 日,全球领先的 API 聚合平台 OpenRouter 的数据显示,国产模型呈现出前所未有的主导地位:MiniMax M2.5 位居全球调用量榜首,紧随其后的是 Kimi K2.5 和 GLM-5。这一“前三甲”阵容表明,中国提供商已通过更优的 AI 部署效率和强劲的开发者采用率,超越了国际竞争对手。七天内处理 3.07 万亿 Token:MiniMax 的快速扩张Min
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












