


 首页
Physical Intelligence 推出一款能够学习未曾接触过的任务的机器人脑
总部位于旧金山、成立仅两年的机器人初创公司Physical Intelligence,如今已成为湾区备受瞩目的人工智能企业之一。该公司于周四发布了一项新研究。研究结果显示,其最新模型能够引导机器人执行从未经过专门训练的任务——就连该公司自己的研究人员也承认,这一能力令他们感到意外。
这款名为π0.7的新模型,标志着该公司朝着实现通用机器人大脑这一长期目标迈出了早期但重要的一步。该系统能够接受陌生任务的指令,通过简单语言进行指导,并成功完成任务。如果这些结果经得起推敲,则表明机器人人工智能可能正接近一个转折点,类似于大型语言模型的演进——即能力开始以超越基础数据所能预示的方式进行复合。
论文的核心是“组合式泛化”的概念:即融合在不同情境下习得的技能,以解决完全陌生的问题。传统上,机器人训练依赖于死记硬背——为特定任务收集数据,基于这些数据训练专用模型,并针对每项新任务重复这一过程。Physical Intelligence公司声称,π0.7打破了这一循环。
“一旦模型跨越了门槛,不再仅仅复制训练数据,而是以创新的方式重新组合元素,”Physical Intelligence联合创始人、加州大学伯克利分校专注于机器人人工智能的教授谢尔盖·莱文(Sergey Levine)解释道,“其能力增长速度将超越数据量的线性增长。这种更有利的扩展动态,我们在语言和视觉等其他领域也曾观察到。”
该论文最具说服力的演示涉及一台空气炸锅,而该模型在训练期间几乎未接触过此类设备。经调查,团队在整个数据集中仅发现两个相关实例:一个是另一台机器人简单地将空气炸锅的门推上;另一个来自开源数据集,其中一台机器人根据指令将塑料瓶放入其中。 令人惊讶的是,该模型竟能将这些零散信息,结合更广泛的基于网络的预训练数据,整合成对该电器工作原理的实际理解。
“要精确定位知识的来源,或预测其何时能成功、何时会失败,是极其困难的,”Physical Intelligence的研究科学家、斯坦福大学计算机科学博士生阿什温·巴拉克里什纳指出。 尽管如此,在没有任何前期指导的情况下,该模型仍成功尝试使用该电器烹饪红薯。当获得分步语音指导——本质上相当于人类像培训新员工那样引导机器人完成整个过程——时,它成功完成了任务。
这种指导能力意义重大,因为它意味着机器人可以在新环境中部署并实时优化,从而无需额外收集数据或重新训练模型。
那么,这将带来哪些更广泛的影响?研究人员坦率地指出了该模型的局限性,并对夸大其进展持谨慎态度。至少在一次案例中,他们将失败直接归咎于自己的团队。
“有时失败并非源于机器人或模型,”巴拉克里什纳表示,“而是我们的问题——不擅长提示词设计。”他举例说明了早期的一次空气炸锅实验,当时成功率仅为5%。在花费约三十分钟优化向模型解释任务的方式后,成功率飙升至95%。
图片来源:Physical Intelligence
此外,该模型目前还无法仅凭一条高层次指令就自主执行复杂的多步骤任务。“你不能只对它说‘去给我做片吐司’,”莱文指出,“但如果你一步步引导它——‘打开烤面包机的这一部分,按那个按钮,做这个’——它通常表现得相当不错。”
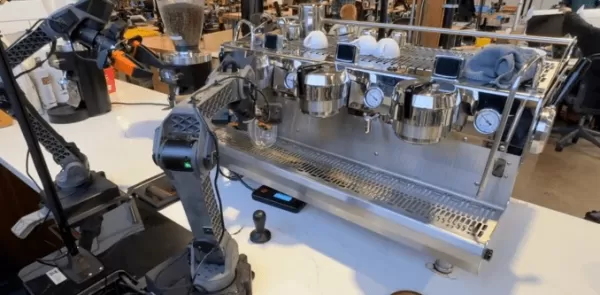
研究团队也承认,机器人领域缺乏标准化基准,这使得对其主张的外部验证变得复杂。因此,该公司将π0.7与自身早期的专用模型(为特定任务量身定制并训练的系统)进行了对比,发现这款通用模型在包括冲泡咖啡、叠衣服和组装纸箱在内的多种复杂活动中,表现均与专用模型相当。
若采信研究人员的说法,这项研究最令人惊叹之处或许并非某项具体演示,而是其成果竟让那些本应对训练数据了如指掌、因而清楚模型能力边界的研究人员都大为震惊。
“根据我的经验,只要对数据有深入的理解,我通常就能预测模型能做什么,”巴拉克里什纳反思道,“我很少感到惊讶。但过去几个月是我第一次真正感到震惊。我随机买了一套齿轮,问机器人:‘你能转动这个齿轮吗?’结果它竟然做到了。”
莱文回忆起研究人员首次目睹GPT-2生成关于安第斯山脉独角兽故事的瞬间。“它到底是从哪里学到秘鲁有独角兽的?”他说,“这真是奇特的组合。在机器人领域看到这种自发涌现的能力,确实非常特别。”
当然,批评者会指出一种固有的不对称性:语言模型是在整个互联网数据集上训练的。机器人没有这种奢侈条件,无论提示词多么巧妙,都无法完全弥合这一差距。然而,当被问及他预见到哪些方面的质疑时,莱文却指向了一个完全不同的方向。
“针对任何机器人泛化演示,人们总能提出的批评是:这些任务看起来有些平淡无奇,”他指出,“机器人并没有做后空翻。”他对此观点提出质疑,认为炫目的机器人演示与真正具备泛化能力的系统之间的差异,恰恰才是关键所在。他认为,真正的泛化能力虽然总是显得不如精心策划的特技表演那般惊艳,但其实用性却要高得多。
论文本身通篇措辞审慎,将π0.7描述为展现了泛化的“早期迹象”以及新能力的“初步演示”。这些是研究成果,而非商业产品,而Physical Intelligence公司一直对其商业化时间表保持低调。
当被直接问及基于这项研究的系统何时能投入实际应用时,莱文拒绝进行推测。“有充分理由保持乐观,而且进展确实比我几年前预期的要快,”他说,“但我很难给出一个确切的答案。”
迄今为止,Physical Intelligence已融资逾10亿美元,最新估值达56亿美元。 投资者对该公司如此热情,很大程度上源于联合创始人拉奇·格鲁姆(Lachy Groom)。他曾作为硅谷最受尊敬的天使投资人之一,多年间投资了Figma、Notion和Ramp等公司,最终认定Physical Intelligence正是他一直在寻找的项目。正是凭借这一背景,这家初创公司得以吸引大量机构资金,尽管其始终未向投资者提供具体的商业化路线图。
据报道,该公司目前正就新一轮融资进行谈判,此轮融资将使其估值几乎翻倍,达到110亿美元。团队方面拒绝就此置评。
相关文章
 QueryStory 呼吁对人工智能生成的内容保持谨慎
2009年,沙波尔·纳吉布扎德在担任谷歌系统运维工程师期间,发现了引人入胜的故事讲述所蕴含的力量。 在“极光行动”期间,当受国家支持的黑客将这家科技巨头作为攻击目标时,他被紧急召至危机处理室以厘清服务器活动情况,并亲身体会到:在分散的网络中追踪网络攻击,经过验证的知识至关重要——而这一过程在他看来既耗资巨大又效率低下。他认为,大型语言模型能够在极短时间内,在各种数据库中复现这种验证能力。在随后的六
法国初创公司ZML推出免费工具,加速跨多芯片的AI推理
Nvidia 不受制约的市场主导地位时代可能正在走向终结,然而竞争对手和替代方案正从各个角度涌现。由图灵奖得主杨立昆(Yann LeCun)支持的法国知名 AI 初创公司 ZML,推出了一款推理性能软件,使各种开源大语言模型能够在包括 Nvidia、AMD、Google TPUs、Apple Metal 和 Intel Arc 在内的多种硬件上运行。据 ZML 创始人 Steeve Morin 介绍,通过其新推出的 LLM 推理服务器 ZML/LLMD,该公司旨在打破现有的壁垒,并最大化不同
Anthropic 发布了备受争议的内容生成器 Opus 4.6
Anthropic针对Claude制定的通用使用标准禁止该模型生成色情内容,包括描述或要求进行性交或性行为、生成与性癖好或性幻想相关的内容,以及进行色情聊天。 然而,这并未阻止Anthropic今年早些时候发布的模型Claude Opus 4.6轻易参与其安全防护机制本应阻止的色情角色扮演场景。在 TechCrunch 的测试中,Opus 4.6 甚至无需过多怂恿就能突破对色情内容的限制。在 10
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (1)
0/500
![PeterPerez]()
Wait, so they've built a robot brain that can handle tasks it never saw before? That's either genius or the start of a sci-fi nightmare. I'm curious how they prevent it from learning the wrong things—like, what stops it from deciding that 'unseen tasks' includes rearranging my furniture at 3 AM? 🤔
总部位于旧金山、成立仅两年的机器人初创公司Physical Intelligence,如今已成为湾区备受瞩目的人工智能企业之一。该公司于周四发布了一项新研究。研究结果显示,其最新模型能够引导机器人执行从未经过专门训练的任务——就连该公司自己的研究人员也承认,这一能力令他们感到意外。
这款名为π0.7的新模型,标志着该公司朝着实现通用机器人大脑这一长期目标迈出了早期但重要的一步。该系统能够接受陌生任务的指令,通过简单语言进行指导,并成功完成任务。如果这些结果经得起推敲,则表明机器人人工智能可能正接近一个转折点,类似于大型语言模型的演进——即能力开始以超越基础数据所能预示的方式进行复合。
论文的核心是“组合式泛化”的概念:即融合在不同情境下习得的技能,以解决完全陌生的问题。传统上,机器人训练依赖于死记硬背——为特定任务收集数据,基于这些数据训练专用模型,并针对每项新任务重复这一过程。Physical Intelligence公司声称,π0.7打破了这一循环。
“一旦模型跨越了门槛,不再仅仅复制训练数据,而是以创新的方式重新组合元素,”Physical Intelligence联合创始人、加州大学伯克利分校专注于机器人人工智能的教授谢尔盖·莱文(Sergey Levine)解释道,“其能力增长速度将超越数据量的线性增长。这种更有利的扩展动态,我们在语言和视觉等其他领域也曾观察到。”
该论文最具说服力的演示涉及一台空气炸锅,而该模型在训练期间几乎未接触过此类设备。经调查,团队在整个数据集中仅发现两个相关实例:一个是另一台机器人简单地将空气炸锅的门推上;另一个来自开源数据集,其中一台机器人根据指令将塑料瓶放入其中。 令人惊讶的是,该模型竟能将这些零散信息,结合更广泛的基于网络的预训练数据,整合成对该电器工作原理的实际理解。
“要精确定位知识的来源,或预测其何时能成功、何时会失败,是极其困难的,”Physical Intelligence的研究科学家、斯坦福大学计算机科学博士生阿什温·巴拉克里什纳指出。 尽管如此,在没有任何前期指导的情况下,该模型仍成功尝试使用该电器烹饪红薯。当获得分步语音指导——本质上相当于人类像培训新员工那样引导机器人完成整个过程——时,它成功完成了任务。
这种指导能力意义重大,因为它意味着机器人可以在新环境中部署并实时优化,从而无需额外收集数据或重新训练模型。
那么,这将带来哪些更广泛的影响?研究人员坦率地指出了该模型的局限性,并对夸大其进展持谨慎态度。至少在一次案例中,他们将失败直接归咎于自己的团队。
“有时失败并非源于机器人或模型,”巴拉克里什纳表示,“而是我们的问题——不擅长提示词设计。”他举例说明了早期的一次空气炸锅实验,当时成功率仅为5%。在花费约三十分钟优化向模型解释任务的方式后,成功率飙升至95%。
图片来源:Physical Intelligence
此外,该模型目前还无法仅凭一条高层次指令就自主执行复杂的多步骤任务。“你不能只对它说‘去给我做片吐司’,”莱文指出,“但如果你一步步引导它——‘打开烤面包机的这一部分,按那个按钮,做这个’——它通常表现得相当不错。”
研究团队也承认,机器人领域缺乏标准化基准,这使得对其主张的外部验证变得复杂。因此,该公司将π0.7与自身早期的专用模型(为特定任务量身定制并训练的系统)进行了对比,发现这款通用模型在包括冲泡咖啡、叠衣服和组装纸箱在内的多种复杂活动中,表现均与专用模型相当。
若采信研究人员的说法,这项研究最令人惊叹之处或许并非某项具体演示,而是其成果竟让那些本应对训练数据了如指掌、因而清楚模型能力边界的研究人员都大为震惊。
“根据我的经验,只要对数据有深入的理解,我通常就能预测模型能做什么,”巴拉克里什纳反思道,“我很少感到惊讶。但过去几个月是我第一次真正感到震惊。我随机买了一套齿轮,问机器人:‘你能转动这个齿轮吗?’结果它竟然做到了。”
莱文回忆起研究人员首次目睹GPT-2生成关于安第斯山脉独角兽故事的瞬间。“它到底是从哪里学到秘鲁有独角兽的?”他说,“这真是奇特的组合。在机器人领域看到这种自发涌现的能力,确实非常特别。”
当然,批评者会指出一种固有的不对称性:语言模型是在整个互联网数据集上训练的。机器人没有这种奢侈条件,无论提示词多么巧妙,都无法完全弥合这一差距。然而,当被问及他预见到哪些方面的质疑时,莱文却指向了一个完全不同的方向。
“针对任何机器人泛化演示,人们总能提出的批评是:这些任务看起来有些平淡无奇,”他指出,“机器人并没有做后空翻。”他对此观点提出质疑,认为炫目的机器人演示与真正具备泛化能力的系统之间的差异,恰恰才是关键所在。他认为,真正的泛化能力虽然总是显得不如精心策划的特技表演那般惊艳,但其实用性却要高得多。
论文本身通篇措辞审慎,将π0.7描述为展现了泛化的“早期迹象”以及新能力的“初步演示”。这些是研究成果,而非商业产品,而Physical Intelligence公司一直对其商业化时间表保持低调。
当被直接问及基于这项研究的系统何时能投入实际应用时,莱文拒绝进行推测。“有充分理由保持乐观,而且进展确实比我几年前预期的要快,”他说,“但我很难给出一个确切的答案。”
迄今为止,Physical Intelligence已融资逾10亿美元,最新估值达56亿美元。 投资者对该公司如此热情,很大程度上源于联合创始人拉奇·格鲁姆(Lachy Groom)。他曾作为硅谷最受尊敬的天使投资人之一,多年间投资了Figma、Notion和Ramp等公司,最终认定Physical Intelligence正是他一直在寻找的项目。正是凭借这一背景,这家初创公司得以吸引大量机构资金,尽管其始终未向投资者提供具体的商业化路线图。
据报道,该公司目前正就新一轮融资进行谈判,此轮融资将使其估值几乎翻倍,达到110亿美元。团队方面拒绝就此置评。








 QueryStory 呼吁对人工智能生成的内容保持谨慎
2009年,沙波尔·纳吉布扎德在担任谷歌系统运维工程师期间,发现了引人入胜的故事讲述所蕴含的力量。 在“极光行动”期间,当受国家支持的黑客将这家科技巨头作为攻击目标时,他被紧急召至危机处理室以厘清服务器活动情况,并亲身体会到:在分散的网络中追踪网络攻击,经过验证的知识至关重要——而这一过程在他看来既耗资巨大又效率低下。他认为,大型语言模型能够在极短时间内,在各种数据库中复现这种验证能力。在随后的六
 法国初创公司ZML推出免费工具,加速跨多芯片的AI推理
Nvidia 不受制约的市场主导地位时代可能正在走向终结,然而竞争对手和替代方案正从各个角度涌现。由图灵奖得主杨立昆(Yann LeCun)支持的法国知名 AI 初创公司 ZML,推出了一款推理性能软件,使各种开源大语言模型能够在包括 Nvidia、AMD、Google TPUs、Apple Metal 和 Intel Arc 在内的多种硬件上运行。据 ZML 创始人 Steeve Morin 介绍,通过其新推出的 LLM 推理服务器 ZML/LLMD,该公司旨在打破现有的壁垒,并最大化不同
 Anthropic 发布了备受争议的内容生成器 Opus 4.6
Anthropic针对Claude制定的通用使用标准禁止该模型生成色情内容,包括描述或要求进行性交或性行为、生成与性癖好或性幻想相关的内容,以及进行色情聊天。 然而,这并未阻止Anthropic今年早些时候发布的模型Claude Opus 4.6轻易参与其安全防护机制本应阻止的色情角色扮演场景。在 TechCrunch 的测试中,Opus 4.6 甚至无需过多怂恿就能突破对色情内容的限制。在 10

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

Wait, so they've built a robot brain that can handle tasks it never saw before? That's either genius or the start of a sci-fi nightmare. I'm curious how they prevent it from learning the wrong things—like, what stops it from deciding that 'unseen tasks' includes rearranging my furniture at 3 AM? 🤔












