


 首页
从 MIPS 到 exaflops,短短几十年:计算能力正在爆炸,将改变 AI
在最近的Nvidia GTC大会上,这家科技巨头公布了一项突破性成就:首个人单机架服务器系统能够达到一exaflop的性能。这是一个令人难以置信的每秒十亿亿次浮点运算(FLOPS)。这一壮举由Nvidia最新的GB200 NVL72系统驱动,该系统搭载了尖端的Blackwell图形处理单元(GPUs)。为了便于理解,这个系统可以装进一个标准的计算机机架,高度约6英尺,深度略超3英尺,宽度不到2英尺。
缩小exaflop:从Frontier到Blackwell
这一消息让我思考我们在短短几年内取得了多大的进步。全球首台exaflop级计算机“Frontier”于2022年在橡树岭国家实验室安装。由HPE制造并搭载AMD GPUs和CPUs,它占地足足74个机架。相比之下,Nvidia的新系统将73倍的性能压缩到单个机架中。这相当于三年内每年性能翻三倍!这充分证明了计算密度、能源效率和架构设计方面的惊人进步。
值得注意的是,虽然这两个系统都达到了exaflop的里程碑,但它们的设计用途不同。Nvidia的exaflop评级基于较低精度的数学运算——4位和8位浮点运算,非常适合AI工作负载,如训练和运行大型语言模型(LLMs)。这些计算更注重速度而非精度。另一方面,Frontier的exaflop评级来自64位双精度数学运算,这是科学模拟的金标准,精度至关重要。
我们进步神速
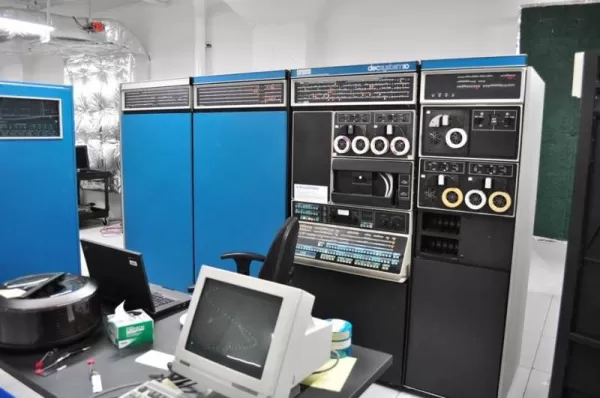
这种进步速度几乎令人难以置信,尤其是当我回想起自己计算职业生涯的早期。我的第一份工作是在DEC KL 1090上做程序员,这是DEC的PDP-10系列分时主机的组成部分。那台机器的运行速度仅为每秒180万条指令(MIPS)。它通过硬连线连接到阴极射线管(CRT)显示器,没有任何图形显示——只有屏幕上的文本。当然,那时也没有互联网。远程用户必须通过电话线使用最高速度为1200比特每秒的调制解调器连接。
计算能力提升5000亿倍
虽然MIPS和FLOPS的比较并非完全等同,但它让我们感受到计算能力的惊人飞跃。MIPS衡量整数处理速度,适用于通用计算和商业应用。而FLOPS则衡量浮点性能,对科学工作负载和现代AI背后的繁重计算至关重要,例如训练和运行机器学习(ML)模型所需的矩阵运算和线性代数。
以这些为粗略参考,Nvidia的新系统大约比老式DEC机器强大5000亿倍。这是计算能力在单一职业生涯中指数级增长的惊人例证。这让人不禁思考:如果我们在40年内取得了如此成就,未来五年会带来什么?
Nvidia已经给出了一些线索。在GTC大会上,他们分享了一份路线图,预测基于“Vera Rubin”Ultra架构的下一代全机架系统将提供当前Blackwell Ultra机架14倍的性能。未来一两年内,我们有望看到AI优化工作负载达到14到15 exaflops的性能。
这不仅仅关乎原始性能。将如此强大的性能压缩到单个机架意味着更少的空间占用、更少的材料使用,以及可能更低的每运算能耗。不过,我们也不能忘记,这些系统的绝对能耗需求仍然巨大。
AI真的需要这么多计算能力吗?
虽然这些性能提升令人印象深刻,但AI行业现在正面临一个重大问题:我们到底需要多少计算能力,代价又是什么?建设大规模新AI数据中心的竞赛,受到exaflop级计算和日益强大的AI模型需求的推动。
最雄心勃勃的项目是耗资5000亿美元的Stargate项目,计划在美国建设20个数据中心,每个占地50万平方英尺。全球范围内还有一波其他超大规模项目正在进行或筹备中,各公司和国家竞相为未来AI工作负载建设基础设施。
一些分析师担心我们可能在过度建设。在中国DeepSeek发布的R1推理模型使用远少于同行的计算资源后,担忧进一步加剧。微软近期取消了与多家数据中心提供商的租约,引发了人们对其AI基础设施需求的重新思考。
然而,《The Register》指出,这种撤资可能更多是因为计划中的数据中心无法满足下一代AI系统的电力和冷却需求。AI模型已经开始挑战当前基础设施的极限。《MIT Technology Review》报道称,中国许多数据中心由于基于过时规格建设而陷入困境甚至失败。
AI推理需要更多FLOPS
推理模型通过称为推理的过程在运行时完成大部分繁重工作。这些模型支持一些最先进且资源密集的应用,如深度研究助手和新兴的代理AI系统。
尽管DeepSeek-R1最初让业界认为未来AI可能需要更少的计算能力,但Nvidia首席执行官黄仁勋强烈反驳了这一观点。在接受CNBC采访时,他表示相反的结论:“这与大家的结论完全相反。”他补充说,推理AI消耗的计算资源是非推理AI的100倍。
随着AI从推理模型发展到自主代理及更远领域,对计算能力的需求可能会再次激增。下一个突破可能出现在AI代理协调、融合模拟或大规模数字孪生等领域——这些都得益于我们刚刚见证的计算飞跃。
几乎与此同时,OpenAI宣布了400亿美元的新融资,这是科技行业有史以来最大的私募融资轮次。他们在博客中表示,这笔资金“使我们能够进一步推动AI研究的边界,扩展我们的计算基础设施,并为每周使用ChatGPT的5亿人提供越来越强大的工具。”
为什么如此多的资本流入AI?原因从竞争力到国家安全不一而足,但一个突出因素是:据麦肯锡估计,AI每年可为企业增加4.4万亿美元的利润。
接下来会怎样?无人知晓
信息系统的核心在于简化复杂性,无论是过去我用Fortran编写的紧急车辆路由系统,用COBOL构建的学生成绩报告工具,还是现代AI系统加速药物发现,目标始终如一:理解世界。
现在,随着强大AI的到来,我们正在跨越一个门槛。人类首次可能拥有足够的计算能力和智能来解决曾经遥不可及的问题。
《纽约时报》专栏作家Kevin Roose很好地捕捉了这一时刻:“每周,我都会遇到致力于AI的工程师和企业家,他们告诉我,变革——巨大的变革、震撼世界的变革、我们从未见过的变革——即将来临。”这还不包括每周涌现的突破。
就在过去几天,我们看到OpenAI的GPT-4o能够从文本生成几乎完美的图像,Google发布了可能是迄今最先进的推理模型Gemini 2.5 Pro,Runway推出了一款具有镜头间角色和场景一致性的视频模型,VentureBeat指出,这一点至今仍是大多数AI视频生成器的难题。
接下来会发生什么,真的无人能预测。我们不知道强大的AI会是突破还是崩溃,会帮助解决核聚变能源问题,还是带来新的生物风险。但随着未来五年越来越多的FLOPS上线,有一点似乎是确定的:创新将快速而有力地到来。随着FLOPS的扩展,我们关于责任、监管和克制的对话也必须同步进行。
Gary Grossman是Edelman技术实践执行副总裁兼Edelman AI卓越中心的全球负责人。
相关文章
 OneRail 利用英伟达人工智能优化实时“最后一公里”配送
OneRail推出了一款基于Nvidia技术的人工智能驱动配送平台,旨在协助零售商、批发商和分销商为单个订单确定最高效的配送方式。据 OneRail 介绍,该系统名为 OmniSTAR,可评估各种配送渠道——包括自有车队、快递员、包裹服务及其他物流模式——以确定既能满足服务水平协议(SLA),又最具成本效益的解决方案。该平台将英伟达的 cuOpt 决策优化引擎和 cuDF 数据处理软件与 OneR
苹果新任硬件主管约翰·特努斯主导未来产品愿景
正在加载播放器…苹果公司的特纳斯时代已正式开启。蒂姆·库克本周卸任首席执行官职务,将领导权移交给前硬件负责人约翰·特纳斯。特纳斯在首份备忘录中承诺“下周将有一场重磅发布会”,这意味着下一场iPhone活动将在他尚未完全安顿下来之前就摆在他面前。然而,库克并未完全隐退:他仍担任执行主席,专注于政策关系,这些关系最近将一些小问题(如地图标签)变成了公众平衡的难题。这一过渡引发了一个关键问题:特纳斯时代意味着什么,股东将给予他多大的空间来应对这一挑战?在本期TechCrunch的Equity播客
Groq 筹集 3.5 亿美元,以推动其从 AI 芯片向“新云”(neocloud)的战略转型
AI基础设施公司Groq已获得3.5亿美元的新融资,标志着其从专业芯片开发商向提供强大GPU和AI基础设施服务的“新云”提供商的持续转型。由Disruptive Technologies领投,Nvidia预计也将参与,本轮融资将Groq的估值定为35亿美元。这一数字较去年9月Nvidia通过许可协议收购该公司创始人兼首席执行官Jonathan Ross及核心团队成员时记录的69亿美元估值大幅下跌。公司发言人向TechCrunch澄清,估值降低并不构成“降价融资”(down round)。相反
相关专题推荐
音乐创作
 用于混音制作、采样准备及卡拉OK母带处理的 AI 声部分离工具
2026年最新、最优秀且评分最高的AI音轨分离工具汇总,专为混音制作、采样准备以及卡拉OK音频处理而设计。这些功能强大的创新工具经过实际测试,能够实现精准的音频分离,显著提升工作效率。XIX.AI每周都会更新免费的付费产品对比指南,帮助您找到最适合自身需求的工具。立即探索,发挥您的AI优势。
 8 个工具
 xix.ai
数据分析
用于收入看板、转化漏斗分析及产品指标分析的 AI SQL 助手
2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai
音乐创作
最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

 评论 (7)
0/500
![BrianDavis]()
One exaflop in a single rack? That's insane 🤯. But honestly, I'm more worried about the power consumption—those GB200 chips must drink electricity like it's happy hour. Still, if this means better AI reasoning without hallucinations, sign me up. Just hope we don't end up with Skynet running on Nvidia hardware.
![RichardThomas]()
Uau, um exaflop em um único rack?! 🤯 Lembro que há alguns anos discutíamos petaflops como algo futurista. Agora a NVIDIA já alcançou esse marco. É incrível ver como a computação avança exponencialmente, mas também me pergunto: quem, além de grandes corporações e governos, terá acesso real a esse poder? A democratização da IA ainda parece distante quando o hardware requer investimentos astronômicos. Será que vamos ver aplicações práticas disso no dia a dia ou ficará restrito a pesquisa de ponta?
![StevenAllen]()
와, 단일 랙에서 익사플롭 성능이라니... 엔비디아는 정말 멈출 줄 모르네요. 🤯 AI 학습에 이 속도라면 곧 개인 맞춤형 AI 보조자가 현실화되겠어요. 근데 이런 연산력이 기후변화에 미치는 영향도 함께 생각해 봐야 할 것 같아요. GPU 클러스터 전력 소비량이 벌써 걱정되네요.
![JackMoore]()
Mind-blowing speed! Nvidia's exaflop system is a game-changer for AI. Can't wait to see what crazy innovations come next! 🚀
![StephenRoberts]()
Mind-blowing speed! Nvidia’s exaflop system is a game-changer for AI. Can’t wait to see what crazy applications come out of this! 🚀
![MarkGonzalez]()
Mind blown! An exaflop in a single rack? Nvidia's pushing AI into hyperspace. Can't wait to see what crazy applications come next. 🚀
在最近的Nvidia GTC大会上,这家科技巨头公布了一项突破性成就:首个人单机架服务器系统能够达到一exaflop的性能。这是一个令人难以置信的每秒十亿亿次浮点运算(FLOPS)。这一壮举由Nvidia最新的GB200 NVL72系统驱动,该系统搭载了尖端的Blackwell图形处理单元(GPUs)。为了便于理解,这个系统可以装进一个标准的计算机机架,高度约6英尺,深度略超3英尺,宽度不到2英尺。
缩小exaflop:从Frontier到Blackwell
这一消息让我思考我们在短短几年内取得了多大的进步。全球首台exaflop级计算机“Frontier”于2022年在橡树岭国家实验室安装。由HPE制造并搭载AMD GPUs和CPUs,它占地足足74个机架。相比之下,Nvidia的新系统将73倍的性能压缩到单个机架中。这相当于三年内每年性能翻三倍!这充分证明了计算密度、能源效率和架构设计方面的惊人进步。
值得注意的是,虽然这两个系统都达到了exaflop的里程碑,但它们的设计用途不同。Nvidia的exaflop评级基于较低精度的数学运算——4位和8位浮点运算,非常适合AI工作负载,如训练和运行大型语言模型(LLMs)。这些计算更注重速度而非精度。另一方面,Frontier的exaflop评级来自64位双精度数学运算,这是科学模拟的金标准,精度至关重要。
我们进步神速
这种进步速度几乎令人难以置信,尤其是当我回想起自己计算职业生涯的早期。我的第一份工作是在DEC KL 1090上做程序员,这是DEC的PDP-10系列分时主机的组成部分。那台机器的运行速度仅为每秒180万条指令(MIPS)。它通过硬连线连接到阴极射线管(CRT)显示器,没有任何图形显示——只有屏幕上的文本。当然,那时也没有互联网。远程用户必须通过电话线使用最高速度为1200比特每秒的调制解调器连接。
计算能力提升5000亿倍
虽然MIPS和FLOPS的比较并非完全等同,但它让我们感受到计算能力的惊人飞跃。MIPS衡量整数处理速度,适用于通用计算和商业应用。而FLOPS则衡量浮点性能,对科学工作负载和现代AI背后的繁重计算至关重要,例如训练和运行机器学习(ML)模型所需的矩阵运算和线性代数。
以这些为粗略参考,Nvidia的新系统大约比老式DEC机器强大5000亿倍。这是计算能力在单一职业生涯中指数级增长的惊人例证。这让人不禁思考:如果我们在40年内取得了如此成就,未来五年会带来什么?
Nvidia已经给出了一些线索。在GTC大会上,他们分享了一份路线图,预测基于“Vera Rubin”Ultra架构的下一代全机架系统将提供当前Blackwell Ultra机架14倍的性能。未来一两年内,我们有望看到AI优化工作负载达到14到15 exaflops的性能。
这不仅仅关乎原始性能。将如此强大的性能压缩到单个机架意味着更少的空间占用、更少的材料使用,以及可能更低的每运算能耗。不过,我们也不能忘记,这些系统的绝对能耗需求仍然巨大。
AI真的需要这么多计算能力吗?
虽然这些性能提升令人印象深刻,但AI行业现在正面临一个重大问题:我们到底需要多少计算能力,代价又是什么?建设大规模新AI数据中心的竞赛,受到exaflop级计算和日益强大的AI模型需求的推动。
最雄心勃勃的项目是耗资5000亿美元的Stargate项目,计划在美国建设20个数据中心,每个占地50万平方英尺。全球范围内还有一波其他超大规模项目正在进行或筹备中,各公司和国家竞相为未来AI工作负载建设基础设施。
一些分析师担心我们可能在过度建设。在中国DeepSeek发布的R1推理模型使用远少于同行的计算资源后,担忧进一步加剧。微软近期取消了与多家数据中心提供商的租约,引发了人们对其AI基础设施需求的重新思考。
然而,《The Register》指出,这种撤资可能更多是因为计划中的数据中心无法满足下一代AI系统的电力和冷却需求。AI模型已经开始挑战当前基础设施的极限。《MIT Technology Review》报道称,中国许多数据中心由于基于过时规格建设而陷入困境甚至失败。
AI推理需要更多FLOPS
推理模型通过称为推理的过程在运行时完成大部分繁重工作。这些模型支持一些最先进且资源密集的应用,如深度研究助手和新兴的代理AI系统。
尽管DeepSeek-R1最初让业界认为未来AI可能需要更少的计算能力,但Nvidia首席执行官黄仁勋强烈反驳了这一观点。在接受CNBC采访时,他表示相反的结论:“这与大家的结论完全相反。”他补充说,推理AI消耗的计算资源是非推理AI的100倍。
随着AI从推理模型发展到自主代理及更远领域,对计算能力的需求可能会再次激增。下一个突破可能出现在AI代理协调、融合模拟或大规模数字孪生等领域——这些都得益于我们刚刚见证的计算飞跃。
几乎与此同时,OpenAI宣布了400亿美元的新融资,这是科技行业有史以来最大的私募融资轮次。他们在博客中表示,这笔资金“使我们能够进一步推动AI研究的边界,扩展我们的计算基础设施,并为每周使用ChatGPT的5亿人提供越来越强大的工具。”
为什么如此多的资本流入AI?原因从竞争力到国家安全不一而足,但一个突出因素是:据麦肯锡估计,AI每年可为企业增加4.4万亿美元的利润。
接下来会怎样?无人知晓
信息系统的核心在于简化复杂性,无论是过去我用Fortran编写的紧急车辆路由系统,用COBOL构建的学生成绩报告工具,还是现代AI系统加速药物发现,目标始终如一:理解世界。
现在,随着强大AI的到来,我们正在跨越一个门槛。人类首次可能拥有足够的计算能力和智能来解决曾经遥不可及的问题。
《纽约时报》专栏作家Kevin Roose很好地捕捉了这一时刻:“每周,我都会遇到致力于AI的工程师和企业家,他们告诉我,变革——巨大的变革、震撼世界的变革、我们从未见过的变革——即将来临。”这还不包括每周涌现的突破。
就在过去几天,我们看到OpenAI的GPT-4o能够从文本生成几乎完美的图像,Google发布了可能是迄今最先进的推理模型Gemini 2.5 Pro,Runway推出了一款具有镜头间角色和场景一致性的视频模型,VentureBeat指出,这一点至今仍是大多数AI视频生成器的难题。
接下来会发生什么,真的无人能预测。我们不知道强大的AI会是突破还是崩溃,会帮助解决核聚变能源问题,还是带来新的生物风险。但随着未来五年越来越多的FLOPS上线,有一点似乎是确定的:创新将快速而有力地到来。随着FLOPS的扩展,我们关于责任、监管和克制的对话也必须同步进行。
Gary Grossman是Edelman技术实践执行副总裁兼Edelman AI卓越中心的全球负责人。








 OneRail 利用英伟达人工智能优化实时“最后一公里”配送
OneRail推出了一款基于Nvidia技术的人工智能驱动配送平台,旨在协助零售商、批发商和分销商为单个订单确定最高效的配送方式。据 OneRail 介绍,该系统名为 OmniSTAR,可评估各种配送渠道——包括自有车队、快递员、包裹服务及其他物流模式——以确定既能满足服务水平协议(SLA),又最具成本效益的解决方案。该平台将英伟达的 cuOpt 决策优化引擎和 cuDF 数据处理软件与 OneR
 苹果新任硬件主管约翰·特努斯主导未来产品愿景
正在加载播放器…苹果公司的特纳斯时代已正式开启。蒂姆·库克本周卸任首席执行官职务,将领导权移交给前硬件负责人约翰·特纳斯。特纳斯在首份备忘录中承诺“下周将有一场重磅发布会”,这意味着下一场iPhone活动将在他尚未完全安顿下来之前就摆在他面前。然而,库克并未完全隐退:他仍担任执行主席,专注于政策关系,这些关系最近将一些小问题(如地图标签)变成了公众平衡的难题。这一过渡引发了一个关键问题:特纳斯时代意味着什么,股东将给予他多大的空间来应对这一挑战?在本期TechCrunch的Equity播客
 Groq 筹集 3.5 亿美元,以推动其从 AI 芯片向“新云”(neocloud)的战略转型
AI基础设施公司Groq已获得3.5亿美元的新融资,标志着其从专业芯片开发商向提供强大GPU和AI基础设施服务的“新云”提供商的持续转型。由Disruptive Technologies领投,Nvidia预计也将参与,本轮融资将Groq的估值定为35亿美元。这一数字较去年9月Nvidia通过许可协议收购该公司创始人兼首席执行官Jonathan Ross及核心团队成员时记录的69亿美元估值大幅下跌。公司发言人向TechCrunch澄清,估值降低并不构成“降价融资”(down round)。相反
2026年最新、最优秀且评分最高的AI音轨分离工具汇总,专为混音制作、采样准备以及卡拉OK音频处理而设计。这些功能强大的创新工具经过实际测试,能够实现精准的音频分离,显著提升工作效率。XIX.AI每周都会更新免费的付费产品对比指南,帮助您找到最适合自身需求的工具。立即探索,发挥您的AI优势。
8 个工具
xix.ai

2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

One exaflop in a single rack? That's insane 🤯. But honestly, I'm more worried about the power consumption—those GB200 chips must drink electricity like it's happy hour. Still, if this means better AI reasoning without hallucinations, sign me up. Just hope we don't end up with Skynet running on Nvidia hardware.
Uau, um exaflop em um único rack?! 🤯 Lembro que há alguns anos discutíamos petaflops como algo futurista. Agora a NVIDIA já alcançou esse marco. É incrível ver como a computação avança exponencialmente, mas também me pergunto: quem, além de grandes corporações e governos, terá acesso real a esse poder? A democratização da IA ainda parece distante quando o hardware requer investimentos astronômicos. Será que vamos ver aplicações práticas disso no dia a dia ou ficará restrito a pesquisa de ponta?
와, 단일 랙에서 익사플롭 성능이라니... 엔비디아는 정말 멈출 줄 모르네요. 🤯 AI 학습에 이 속도라면 곧 개인 맞춤형 AI 보조자가 현실화되겠어요. 근데 이런 연산력이 기후변화에 미치는 영향도 함께 생각해 봐야 할 것 같아요. GPU 클러스터 전력 소비량이 벌써 걱정되네요.
Mind-blowing speed! Nvidia's exaflop system is a game-changer for AI. Can't wait to see what crazy innovations come next! 🚀
Mind-blowing speed! Nvidia’s exaflop system is a game-changer for AI. Can’t wait to see what crazy applications come out of this! 🚀
Mind blown! An exaflop in a single rack? Nvidia's pushing AI into hyperspace. Can't wait to see what crazy applications come next. 🚀












