


 首页
专家强调了众包AI基准的严重缺陷
人工智能实验室日益倾向于使用众包基准测试平台,如Chatbot Arena,来评估其最新模型的能力。然而,一些专家认为这种方法引发了重大的伦理和学术问题。
近年来,像OpenAI、Google和Meta这样的主要参与者利用这些平台,让用户评估即将推出的模型性能。在这些平台上的高分常常被实验室用来证明其模型的进步。然而,这种方法并非没有批评者。
对众包基准测试的批评
华盛顿大学语言学教授、合著《The AI Con》的Emily Bender对这类基准测试的有效性表示担忧,特别是Chatbot Arena。该平台让志愿者比较两个匿名模型的响应,并选择他们更喜欢的一个。Bender认为,一个有效的基准测试必须测量具体的内容,并展示结构效度,即测量应准确反映被评估的结构。她指出,Chatbot Arena缺乏证据证明用户对某个输出的偏好与任何定义的标准真正相关。
人工智能公司Lesan的联合创始人、分布式人工智能研究所研究员Asmelash Teka Hadgu表示,这些基准测试被人工智能实验室用来夸大其模型的声明。他提到最近Meta的Llama 4 Maverick模型事件,Meta微调了一个在Chatbot Arena表现良好的版本,但选择了发布一个效果较差的版本。Hadgu主张基准测试应是动态的,分布在多个独立实体中,并由使用这些模型的专业人士针对教育和医疗等领域的具体用例进行定制。
对公平报酬和更广泛评估方法的要求
Hadgu和阿斯彭研究所新兴与智能技术倡议前负责人Kristine Gloria认为,评估者应为其工作获得报酬,这与常常具有剥削性的数据标注行业类似。Gloria认为众包基准测试有价值,类似于公民科学倡议,但强调基准测试不应是评估的唯一指标,尤其是在行业创新快速发展的背景下。
Gray Swan AI的首席执行官Matt Fredrikson,该公司进行众包红队测试活动,承认这些平台对希望学习和实践新技能的志愿者具有吸引力。然而,他强调公共基准测试无法取代付费私人评估提供的更深入评估。Fredrikson建议开发者还应依赖内部基准测试、算法红队以及聘请的专家,他们可以提供更开放和领域特定的见解。
行业对基准测试的看法
模型市场OpenRouter的首席执行官Alex Atallah和加州大学伯克利分校人工智能博士生、LMArena(管理Chatbot Arena)的创始人之一Wei-Lin Chiang认为,仅靠开放测试和基准测试是不够的。Chiang强调,LMArena的目标是为社区提供一个可信、开放的空间,以了解不同人工智能模型的社区偏好。
针对Maverick基准测试的争议,Chiang澄清此类事件并非由于Chatbot Arena设计上的缺陷,而是实验室对其政策的误解。LMArena此后更新了其政策,以确保公平和可重复的评估。Chiang强调,该平台的社区不仅仅是一群志愿者或测试者,而是一个提供人工智能模型集体反馈的参与群体。
围绕众包基准测试平台使用的持续争论凸显了对人工智能模型评估需要更细致的方法,结合公众输入和严格的专业评估,以确保准确性和公平性。
相关文章
 Besxar利用SpaceX火箭建造轨道半导体工厂
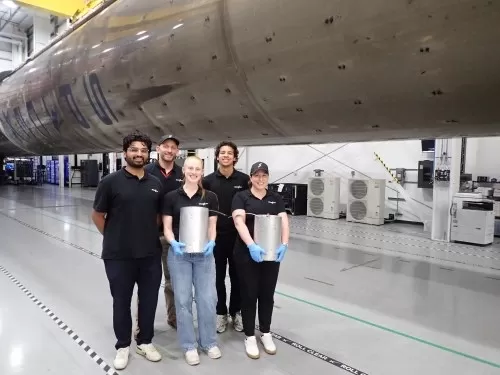
目前,太空制造及将产品运回地球主要依赖于几种有限的方式:等待进入国际空间站,或者与少数能够发射从轨道运回有效载荷的航天器的初创公司合作。然而,往返于太空与地球之间最频繁的飞行器是SpaceX的“猎鹰9号”助推器,它去年完成了163次此类任务,今年已飞行超过100次。一家新创公司声称,已与马斯克的公司达成协议,计划利用多次助推器飞行任务,打造一座轨道半导体工厂的原型。由前OpenAI员工阿什莉·皮利
梁文峰谈开源:6倍利润无需加班,100倍收益与开源挂钩
在近期 DeepSeek 投资者交流会议内部讨论泄露后,创始人梁文锋阐明了其开源策略背后的战略考量。他明确表示:“我们肯定会开源,包括我们最强大的模型”,并指出将专有模型保持封闭并没有带来任何明显的优势。这是他首次从财务角度阐述开源举措与商业成功之间的联系。开源可保留 6 倍回报,但可能限制 100 倍的上涨空间梁文锋勾勒出一个清晰的财务框架:投资回收期为十个月,收益率约为初始利润的六倍,开源并未扰乱其核心商业模式。然而,追求 100 倍的回报可能会因开源而受阻,因为竞争对手可能以五分之一的成本
如何修复常见的Android电池耗电问题?
您的智能手机不断出现故障。屏幕毫无预警地破裂。电池续航一夜之间消失殆尽。充电功能完全失效。音频突然中断。维修费用迅速累积。自己动手修复(DIY)可以处理大多数问题,无需聘请技术人员。具备基础知识并拥有合适的工具即可完成修复。在开始之前确定问题所在切勿猜测设备出了什么故障。正确的诊断可以节省时间和金钱。软件故障经常模仿硬件故障。手机运行缓慢可能只需要重启,而非昂贵的维修。您的第一步决定了整个维修过程。电池耗电快源于多种原因。后台应用持续消耗电量。软件漏洞会增加使用量。硬件故障可能是真正的罪魁祸首。
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (17)
0/500
![EricDavis]()
這篇文章點出了一個關鍵問題:眾包評測雖然快速,但真的能反映AI模型的真實能力嗎?專家們的擔憂很有道理,學術嚴謹性和倫理風險確實需要更嚴格的把關。希望業界能盡快建立更可靠的評估標準,而不是一味追求排行榜上的名次。🤔
![AlbertScott]()
Crowdsourced AI benchmarks sound cool, but experts pointing out ethical issues makes me wonder if we're rushing too fast. 🤔 Are we sacrificing quality for hype?
![JonathanAllen]()
Estou acompanhando o debate sobre benchmarks de IA crowdsourced e, honestamente, é uma bagunça. Os especialistas têm razão ao apontar as falhas, mas qual é a alternativa? É como tentar consertar um barco que vaza com mais buracos. Ainda assim, é uma leitura interessante e certamente faz você pensar sobre o futuro da ética em IA. Experimente se você gosta desse tipo de coisa! 😅
![AlbertWalker]()
Nossa, benchmarks de IA por multidão? Parece legal, mas com falhas éticas? Tô pensando se isso não atrapalha a inovação. As big techs precisam resolver isso logo! 🚀
![RogerRodriguez]()
I've been following the debate on crowdsourced AI benchmarks and honestly, it's a mess. Experts are right to point out the flaws, but what's the alternative? It's like trying to fix a leaky boat with more holes. Still, it's an interesting read and definitely makes you think about the future of AI ethics. Give it a go if you're into that kinda stuff! 😅
![JonathanAllen]()
Intéressant, mais inquiétant ! Les benchmarks par crowdsourcing, c’est innovant, mais les failles éthiques me font réfléchir. Les géants comme Google vont devoir être transparents. 🧐
人工智能实验室日益倾向于使用众包基准测试平台,如Chatbot Arena,来评估其最新模型的能力。然而,一些专家认为这种方法引发了重大的伦理和学术问题。
近年来,像OpenAI、Google和Meta这样的主要参与者利用这些平台,让用户评估即将推出的模型性能。在这些平台上的高分常常被实验室用来证明其模型的进步。然而,这种方法并非没有批评者。
对众包基准测试的批评
华盛顿大学语言学教授、合著《The AI Con》的Emily Bender对这类基准测试的有效性表示担忧,特别是Chatbot Arena。该平台让志愿者比较两个匿名模型的响应,并选择他们更喜欢的一个。Bender认为,一个有效的基准测试必须测量具体的内容,并展示结构效度,即测量应准确反映被评估的结构。她指出,Chatbot Arena缺乏证据证明用户对某个输出的偏好与任何定义的标准真正相关。
人工智能公司Lesan的联合创始人、分布式人工智能研究所研究员Asmelash Teka Hadgu表示,这些基准测试被人工智能实验室用来夸大其模型的声明。他提到最近Meta的Llama 4 Maverick模型事件,Meta微调了一个在Chatbot Arena表现良好的版本,但选择了发布一个效果较差的版本。Hadgu主张基准测试应是动态的,分布在多个独立实体中,并由使用这些模型的专业人士针对教育和医疗等领域的具体用例进行定制。
对公平报酬和更广泛评估方法的要求
Hadgu和阿斯彭研究所新兴与智能技术倡议前负责人Kristine Gloria认为,评估者应为其工作获得报酬,这与常常具有剥削性的数据标注行业类似。Gloria认为众包基准测试有价值,类似于公民科学倡议,但强调基准测试不应是评估的唯一指标,尤其是在行业创新快速发展的背景下。
Gray Swan AI的首席执行官Matt Fredrikson,该公司进行众包红队测试活动,承认这些平台对希望学习和实践新技能的志愿者具有吸引力。然而,他强调公共基准测试无法取代付费私人评估提供的更深入评估。Fredrikson建议开发者还应依赖内部基准测试、算法红队以及聘请的专家,他们可以提供更开放和领域特定的见解。
行业对基准测试的看法
模型市场OpenRouter的首席执行官Alex Atallah和加州大学伯克利分校人工智能博士生、LMArena(管理Chatbot Arena)的创始人之一Wei-Lin Chiang认为,仅靠开放测试和基准测试是不够的。Chiang强调,LMArena的目标是为社区提供一个可信、开放的空间,以了解不同人工智能模型的社区偏好。
针对Maverick基准测试的争议,Chiang澄清此类事件并非由于Chatbot Arena设计上的缺陷,而是实验室对其政策的误解。LMArena此后更新了其政策,以确保公平和可重复的评估。Chiang强调,该平台的社区不仅仅是一群志愿者或测试者,而是一个提供人工智能模型集体反馈的参与群体。
围绕众包基准测试平台使用的持续争论凸显了对人工智能模型评估需要更细致的方法,结合公众输入和严格的专业评估,以确保准确性和公平性。








 Besxar利用SpaceX火箭建造轨道半导体工厂
目前,太空制造及将产品运回地球主要依赖于几种有限的方式:等待进入国际空间站,或者与少数能够发射从轨道运回有效载荷的航天器的初创公司合作。然而,往返于太空与地球之间最频繁的飞行器是SpaceX的“猎鹰9号”助推器,它去年完成了163次此类任务,今年已飞行超过100次。一家新创公司声称,已与马斯克的公司达成协议,计划利用多次助推器飞行任务,打造一座轨道半导体工厂的原型。由前OpenAI员工阿什莉·皮利
 梁文峰谈开源:6倍利润无需加班,100倍收益与开源挂钩
在近期 DeepSeek 投资者交流会议内部讨论泄露后,创始人梁文锋阐明了其开源策略背后的战略考量。他明确表示:“我们肯定会开源,包括我们最强大的模型”,并指出将专有模型保持封闭并没有带来任何明显的优势。这是他首次从财务角度阐述开源举措与商业成功之间的联系。开源可保留 6 倍回报,但可能限制 100 倍的上涨空间梁文锋勾勒出一个清晰的财务框架:投资回收期为十个月,收益率约为初始利润的六倍,开源并未扰乱其核心商业模式。然而,追求 100 倍的回报可能会因开源而受阻,因为竞争对手可能以五分之一的成本
 如何修复常见的Android电池耗电问题?
您的智能手机不断出现故障。屏幕毫无预警地破裂。电池续航一夜之间消失殆尽。充电功能完全失效。音频突然中断。维修费用迅速累积。自己动手修复(DIY)可以处理大多数问题,无需聘请技术人员。具备基础知识并拥有合适的工具即可完成修复。在开始之前确定问题所在切勿猜测设备出了什么故障。正确的诊断可以节省时间和金钱。软件故障经常模仿硬件故障。手机运行缓慢可能只需要重启,而非昂贵的维修。您的第一步决定了整个维修过程。电池耗电快源于多种原因。后台应用持续消耗电量。软件漏洞会增加使用量。硬件故障可能是真正的罪魁祸首。

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

這篇文章點出了一個關鍵問題:眾包評測雖然快速,但真的能反映AI模型的真實能力嗎?專家們的擔憂很有道理,學術嚴謹性和倫理風險確實需要更嚴格的把關。希望業界能盡快建立更可靠的評估標準,而不是一味追求排行榜上的名次。🤔
Crowdsourced AI benchmarks sound cool, but experts pointing out ethical issues makes me wonder if we're rushing too fast. 🤔 Are we sacrificing quality for hype?
Estou acompanhando o debate sobre benchmarks de IA crowdsourced e, honestamente, é uma bagunça. Os especialistas têm razão ao apontar as falhas, mas qual é a alternativa? É como tentar consertar um barco que vaza com mais buracos. Ainda assim, é uma leitura interessante e certamente faz você pensar sobre o futuro da ética em IA. Experimente se você gosta desse tipo de coisa! 😅
Nossa, benchmarks de IA por multidão? Parece legal, mas com falhas éticas? Tô pensando se isso não atrapalha a inovação. As big techs precisam resolver isso logo! 🚀
I've been following the debate on crowdsourced AI benchmarks and honestly, it's a mess. Experts are right to point out the flaws, but what's the alternative? It's like trying to fix a leaky boat with more holes. Still, it's an interesting read and definitely makes you think about the future of AI ethics. Give it a go if you're into that kinda stuff! 😅
Intéressant, mais inquiétant ! Les benchmarks par crowdsourcing, c’est innovant, mais les failles éthiques me font réfléchir. Les géants comme Google vont devoir être transparents. 🧐












