


 首页
ChatGPT的Images 2.0模型在文本生成方面表现出色
就在几年前,区分人工制作的图像和AI生成的图像还相对容易。那时,如果让图像模型生成一份墨西哥餐厅的菜单,结果往往是些怪诞的、虚构的菜品,比如“enchuita”、“churiros”、“burrto”或“margartas”。
如今,当我向全新的ChatGPT Images 2.0模型请求一份墨西哥菜单时,它生成的内容完全可以直接用于真实餐厅,顾客恐怕也难以察觉任何破绽。(尽管一份售价13.50美元的酸橘汁腌鱼,或许仍会让人对鱼的品质产生疑问。)
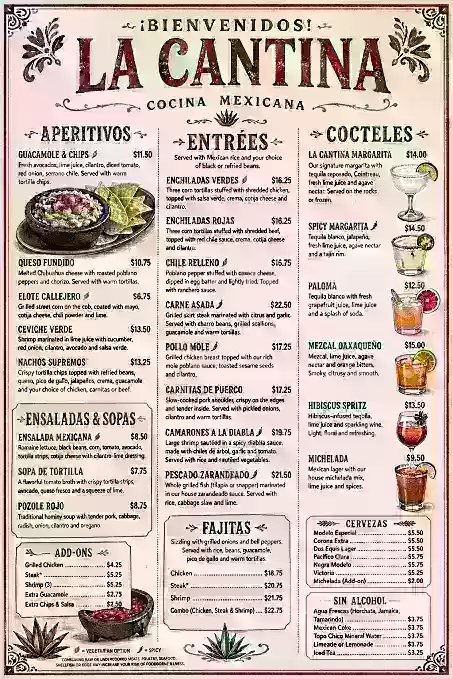
图片来源:ChatGPT Images 2.0
作为对比,这是两年前我从 DALL-E 3 获得的结果。(当时 ChatGPT 还未具备图像生成能力):
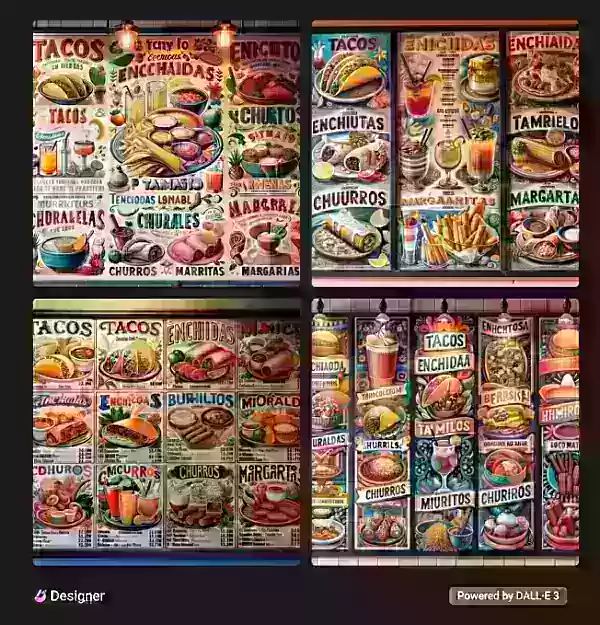
图片来源:Microsoft Designer (DALL-E 3)
从历史上看,AI图像生成器在拼写方面一直存在显著困难。这主要是因为它们通常依赖扩散模型,该模型通过随机噪声来重建图像。
“扩散模型……是在重构给定的输入,”Lesan AI创始人兼首席执行官Asmelash Teka Hadgu在2024年向TechCrunch解释道,“我们可以将图像上的文字视为一个非常微小的组成部分,因此图像生成器会优先学习占据更多像素的视觉模式。”
此后,研究人员开始探索其他图像生成方法,例如自回归模型。这些模型通过逐步预测图像应呈现的样貌,其运作方式更接近大型语言模型(LLMs)。
遗憾的是,OpenAI在本周的新闻发布会上拒绝回答关于ChatGPT Images 2.0具体模型架构的问题。
不过,该公司明确表示,新模型具备“思考能力”。这使其能够搜索网络、根据单一提示生成多张图片,并审查自身生成的内容。这些功能使Images 2.0能够制作多维度的营销材料,以及多格漫画。
OpenAI还表示,Images 2.0在渲染非拉丁文字方面表现更佳,包括日语、韩语、印地语和孟加拉语。该模型的知识库更新截止至2025年12月,这可能会影响其生成与近期事件相关图像时的准确性。
OpenAI在新闻稿中指出:“Images 2.0在图像创作方面实现了前所未有的细节表现力和准确性。它不仅能构思更复杂的场景,还能有效实现这些构想。它能精准遵循指令,保留指定细节,并渲染出其他图像模型常难以处理的精细元素——例如小字、图标、UI组件、复杂构图以及细微的风格差异——且分辨率最高可达2K。”
这些先进功能意味着图像生成并非像向 ChatGPT 提问那样即时。不过,生成诸如多格漫画等复杂内容,仍只需几分钟。
从本周二起,所有 ChatGPT 和 Codex 用户均可使用 Images 2.0,付费订阅用户可生成更高级的输出内容。该公司还将发布 gpt-image-2 API,其定价将根据所需的输出质量和分辨率而定。
相关文章
 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
NEA的蒂芙尼·拉克:企业仍在努力应对人工智能的投资回报率
正在加载播放器…今年早些时候,“token最大化”(tokenmaxxing)在硅谷占据主导地位,首席执行官们敦促员工最大限度地利用人工智能。然而,这种热情很快遭遇了现实。据报道,Uber在几个月内就超出了其年度人工智能预算,一些公司跨部门削减了Claude许可证,而Meta则取消了内部绩效排名。NEA合伙人蒂芙尼·拉克(Tiffany Luck)每天都在应对这种兴奋与实际回报之间的差距。她此前曾成功说服企业电子商务是未来,如今她完全专注于人工智能,特别是其为消费者创造“神奇时刻”的潜力。
相关专题推荐
音乐创作
 最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
 8 个工具
 xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

 评论 (0)
0/500
就在几年前,区分人工制作的图像和AI生成的图像还相对容易。那时,如果让图像模型生成一份墨西哥餐厅的菜单,结果往往是些怪诞的、虚构的菜品,比如“enchuita”、“churiros”、“burrto”或“margartas”。
如今,当我向全新的ChatGPT Images 2.0模型请求一份墨西哥菜单时,它生成的内容完全可以直接用于真实餐厅,顾客恐怕也难以察觉任何破绽。(尽管一份售价13.50美元的酸橘汁腌鱼,或许仍会让人对鱼的品质产生疑问。)
图片来源:ChatGPT Images 2.0
作为对比,这是两年前我从 DALL-E 3 获得的结果。(当时 ChatGPT 还未具备图像生成能力):
图片来源:Microsoft Designer (DALL-E 3)
从历史上看,AI图像生成器在拼写方面一直存在显著困难。这主要是因为它们通常依赖扩散模型,该模型通过随机噪声来重建图像。
“扩散模型……是在重构给定的输入,”Lesan AI创始人兼首席执行官Asmelash Teka Hadgu在2024年向TechCrunch解释道,“我们可以将图像上的文字视为一个非常微小的组成部分,因此图像生成器会优先学习占据更多像素的视觉模式。”
此后,研究人员开始探索其他图像生成方法,例如自回归模型。这些模型通过逐步预测图像应呈现的样貌,其运作方式更接近大型语言模型(LLMs)。
遗憾的是,OpenAI在本周的新闻发布会上拒绝回答关于ChatGPT Images 2.0具体模型架构的问题。
不过,该公司明确表示,新模型具备“思考能力”。这使其能够搜索网络、根据单一提示生成多张图片,并审查自身生成的内容。这些功能使Images 2.0能够制作多维度的营销材料,以及多格漫画。
OpenAI还表示,Images 2.0在渲染非拉丁文字方面表现更佳,包括日语、韩语、印地语和孟加拉语。该模型的知识库更新截止至2025年12月,这可能会影响其生成与近期事件相关图像时的准确性。
OpenAI在新闻稿中指出:“Images 2.0在图像创作方面实现了前所未有的细节表现力和准确性。它不仅能构思更复杂的场景,还能有效实现这些构想。它能精准遵循指令,保留指定细节,并渲染出其他图像模型常难以处理的精细元素——例如小字、图标、UI组件、复杂构图以及细微的风格差异——且分辨率最高可达2K。”
这些先进功能意味着图像生成并非像向 ChatGPT 提问那样即时。不过,生成诸如多格漫画等复杂内容,仍只需几分钟。
从本周二起,所有 ChatGPT 和 Codex 用户均可使用 Images 2.0,付费订阅用户可生成更高级的输出内容。该公司还将发布 gpt-image-2 API,其定价将根据所需的输出质量和分辨率而定。








 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
 NEA的蒂芙尼·拉克:企业仍在努力应对人工智能的投资回报率
正在加载播放器…今年早些时候,“token最大化”(tokenmaxxing)在硅谷占据主导地位,首席执行官们敦促员工最大限度地利用人工智能。然而,这种热情很快遭遇了现实。据报道,Uber在几个月内就超出了其年度人工智能预算,一些公司跨部门削减了Claude许可证,而Meta则取消了内部绩效排名。NEA合伙人蒂芙尼·拉克(Tiffany Luck)每天都在应对这种兴奋与实际回报之间的差距。她此前曾成功说服企业电子商务是未来,如今她完全专注于人工智能,特别是其为消费者创造“神奇时刻”的潜力。

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai












