


 Maison
Le modèle Images 2.0 de ChatGPT excelle dans la génération de texte
Il y a encore quelques années, il était relativement facile de distinguer les images créées par l'homme de celles générées par l'IA. À l'époque, demander à un modèle d'image de créer un menu pour un restaurant mexicain donnait souvent lieu à des plats bizarres et inventés de toutes pièces, tels que « enchuita », « churiros », « burrto » ou « margartas ».
Aujourd’hui, lorsque je demande un menu de cuisine mexicaine au tout nouveau modèle ChatGPT Images 2.0, celui-ci produit quelque chose qui pourrait être utilisé immédiatement dans un vrai restaurant, sans que les clients ne remarquent quoi que ce soit d’anormal. (Même si un ceviche à 13,50 $ pourrait encore soulever quelques questions quant à la qualité du poisson).
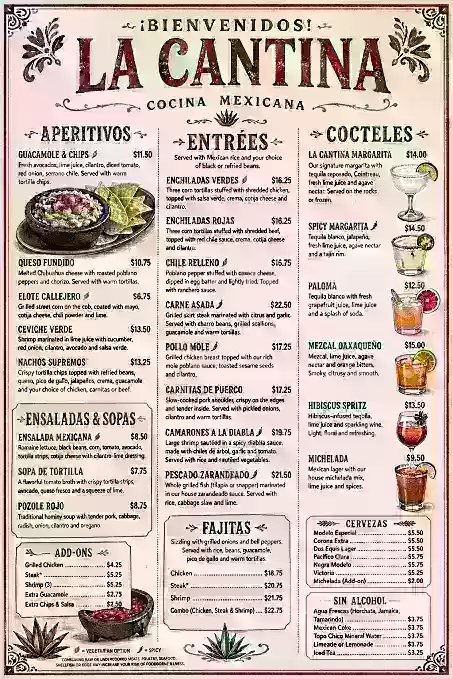
Crédits image : ChatGPT Images 2.0
À titre de comparaison, voici le résultat que j’ai obtenu avec DALL-E 3 il y a deux ans. (À l’époque, ChatGPT ne disposait pas de capacités de génération d’images) :
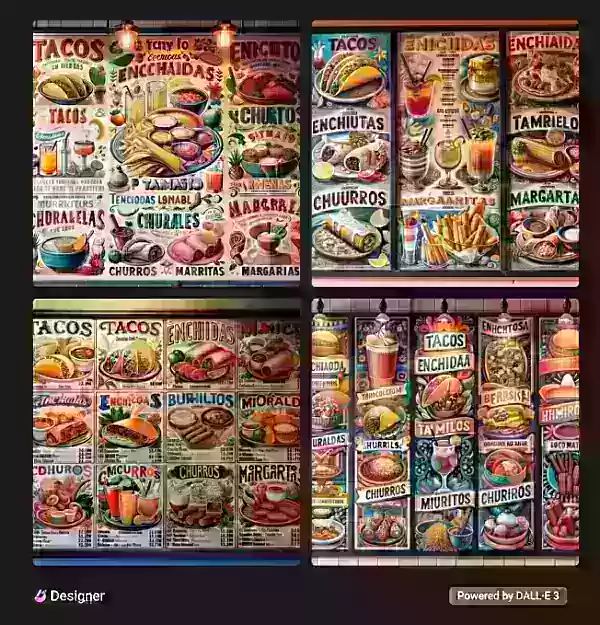
Crédits image : Microsoft Designer (DALL-E 3)
Historiquement, les générateurs d'images basés sur l'IA ont toujours rencontré d'importantes difficultés avec l'orthographe. Cela s'explique en grande partie par le fait qu'ils s'appuyaient généralement sur des modèles de diffusion, qui reconstruisent des images à partir de bruit aléatoire.
« Les modèles de diffusion [...] reconstruisent une entrée donnée », a expliqué Asmelash Teka Hadgu, fondateur et PDG de Lesan AI, à TechCrunch en 2024. « On peut considérer que le texte sur une image est un élément très mineur, donc le générateur d’images donne la priorité à l’apprentissage des motifs visuels qui occupent le plus de pixels. »
Depuis lors, les chercheurs ont exploré d’autres approches de la génération d’images, telles que les modèles autorégressifs. Ces modèles prédisent étape par étape à quoi une image devrait ressembler, fonctionnant de manière plus similaire aux grands modèles linguistiques (LLM).
Malheureusement, OpenAI a refusé de répondre à une question posée lors d’une conférence de presse cette semaine concernant l’architecture spécifique du modèle qui alimente ChatGPT Images 2.0.
La société a toutefois précisé que le nouveau modèle possédait des « capacités de réflexion ». Cela lui permet d’effectuer des recherches sur le Web, de créer plusieurs images à partir d’une seule invite et d’examiner ses propres résultats. Ces fonctionnalités permettent à Images 2.0 de produire des supports marketing dans différentes dimensions, ainsi que des bandes dessinées à plusieurs cases.
OpenAI indique également qu'Images 2.0 maîtrise mieux le rendu des scripts non latins, notamment le japonais, le coréen, l'hindi et le bengali. Les connaissances du modèle sont à jour jusqu'en décembre 2025, ce qui peut affecter sa précision lors de la génération d'images liées à des événements très récents.
« Images 2.0 offre un niveau de détail et de précision sans précédent dans la création d’images. Il est non seulement capable de conceptualiser des scènes plus complexes, mais aussi de concrétiser efficacement cette vision. Il suit les instructions avec précision, conserve les détails demandés et rend des éléments très fins qui posent souvent des difficultés à d’autres modèles d’image — tels que les petits textes, les icônes, les composants d’interface utilisateur, les compositions complexes et les nuances stylistiques subtiles — le tout à des résolutions allant jusqu’à 2K », a noté OpenAI dans un communiqué de presse.
Ces capacités avancées signifient que la génération d’images n’est pas aussi instantanée que de poser une question textuelle à ChatGPT. Cependant, la création de quelque chose de complexe, comme une bande dessinée en plusieurs cases, ne prend toujours que quelques minutes.
Tous les utilisateurs de ChatGPT et Codex auront accès à Images 2.0 à partir de mardi, les abonnés payants pouvant générer des résultats plus avancés. La société lancera également l’API gpt-image-2, dont les tarifs seront basés sur la qualité et la résolution souhaitées.
Article connexe
 OpenAI lance une version plus sûre de ChatGPT pour les adolescents, plusieurs années après qu’ils ont commencé à l’utiliser
À la suite d’une série de poursuites judiciaires liées à l’absence de protocoles de sécurité dans les chatbots basés sur l’IA — qui ont contribué à des suicides d’adolescents et à d’autres crises de s
Frontier AI Labs refuse de dévoiler ses stratégies de confinement des modèles indésirables
Des recherches récentes indiquent que très peu de grands laboratoires spécialisés dans l’IA ont publié ou présenté des plans d’intervention en cas de défaillance. Un plan d’intervention définit les pr
Le Tiffany Luck de NEA : les entreprises continuent de lutter pour justifier le retour sur investissement de l’IA
Chargement du lecteur…Plus tôt cette année, le « tokenmaxxing » a dominé la Silicon Valley, les PDG exhortant leurs employés à maximiser l’utilisation de l’IA. Cet enthousiasme a rapidement rencontré la réalité. Selon les informations rapportées, Ub
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
 9 outils
 xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai
Conception et art
Meilleurs outils d’idéation créative par IA pour les artistes : surmonter les blocages visuels
2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai
Composition musicale
Créateurs de musique par IA pour les pistes d'accompagnement TikTok, les fichiers audio Reels et la musique promotionnelle des créateurs
Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

 commentaires (0)
Il y a encore quelques années, il était relativement facile de distinguer les images créées par l'homme de celles générées par l'IA. À l'époque, demander à un modèle d'image de créer un menu pour un restaurant mexicain donnait souvent lieu à des plats bizarres et inventés de toutes pièces, tels que « enchuita », « churiros », « burrto » ou « margartas ».
Aujourd’hui, lorsque je demande un menu de cuisine mexicaine au tout nouveau modèle ChatGPT Images 2.0, celui-ci produit quelque chose qui pourrait être utilisé immédiatement dans un vrai restaurant, sans que les clients ne remarquent quoi que ce soit d’anormal. (Même si un ceviche à 13,50 $ pourrait encore soulever quelques questions quant à la qualité du poisson).
Crédits image : ChatGPT Images 2.0
À titre de comparaison, voici le résultat que j’ai obtenu avec DALL-E 3 il y a deux ans. (À l’époque, ChatGPT ne disposait pas de capacités de génération d’images) :
Crédits image : Microsoft Designer (DALL-E 3)
Historiquement, les générateurs d'images basés sur l'IA ont toujours rencontré d'importantes difficultés avec l'orthographe. Cela s'explique en grande partie par le fait qu'ils s'appuyaient généralement sur des modèles de diffusion, qui reconstruisent des images à partir de bruit aléatoire.
« Les modèles de diffusion [...] reconstruisent une entrée donnée », a expliqué Asmelash Teka Hadgu, fondateur et PDG de Lesan AI, à TechCrunch en 2024. « On peut considérer que le texte sur une image est un élément très mineur, donc le générateur d’images donne la priorité à l’apprentissage des motifs visuels qui occupent le plus de pixels. »
Depuis lors, les chercheurs ont exploré d’autres approches de la génération d’images, telles que les modèles autorégressifs. Ces modèles prédisent étape par étape à quoi une image devrait ressembler, fonctionnant de manière plus similaire aux grands modèles linguistiques (LLM).
Malheureusement, OpenAI a refusé de répondre à une question posée lors d’une conférence de presse cette semaine concernant l’architecture spécifique du modèle qui alimente ChatGPT Images 2.0.
La société a toutefois précisé que le nouveau modèle possédait des « capacités de réflexion ». Cela lui permet d’effectuer des recherches sur le Web, de créer plusieurs images à partir d’une seule invite et d’examiner ses propres résultats. Ces fonctionnalités permettent à Images 2.0 de produire des supports marketing dans différentes dimensions, ainsi que des bandes dessinées à plusieurs cases.
OpenAI indique également qu'Images 2.0 maîtrise mieux le rendu des scripts non latins, notamment le japonais, le coréen, l'hindi et le bengali. Les connaissances du modèle sont à jour jusqu'en décembre 2025, ce qui peut affecter sa précision lors de la génération d'images liées à des événements très récents.
« Images 2.0 offre un niveau de détail et de précision sans précédent dans la création d’images. Il est non seulement capable de conceptualiser des scènes plus complexes, mais aussi de concrétiser efficacement cette vision. Il suit les instructions avec précision, conserve les détails demandés et rend des éléments très fins qui posent souvent des difficultés à d’autres modèles d’image — tels que les petits textes, les icônes, les composants d’interface utilisateur, les compositions complexes et les nuances stylistiques subtiles — le tout à des résolutions allant jusqu’à 2K », a noté OpenAI dans un communiqué de presse.
Ces capacités avancées signifient que la génération d’images n’est pas aussi instantanée que de poser une question textuelle à ChatGPT. Cependant, la création de quelque chose de complexe, comme une bande dessinée en plusieurs cases, ne prend toujours que quelques minutes.
Tous les utilisateurs de ChatGPT et Codex auront accès à Images 2.0 à partir de mardi, les abonnés payants pouvant générer des résultats plus avancés. La société lancera également l’API gpt-image-2, dont les tarifs seront basés sur la qualité et la résolution souhaitées.








 OpenAI lance une version plus sûre de ChatGPT pour les adolescents, plusieurs années après qu’ils ont commencé à l’utiliser
À la suite d’une série de poursuites judiciaires liées à l’absence de protocoles de sécurité dans les chatbots basés sur l’IA — qui ont contribué à des suicides d’adolescents et à d’autres crises de s
 Frontier AI Labs refuse de dévoiler ses stratégies de confinement des modèles indésirables
Des recherches récentes indiquent que très peu de grands laboratoires spécialisés dans l’IA ont publié ou présenté des plans d’intervention en cas de défaillance. Un plan d’intervention définit les pr
 Le Tiffany Luck de NEA : les entreprises continuent de lutter pour justifier le retour sur investissement de l’IA
Chargement du lecteur…Plus tôt cette année, le « tokenmaxxing » a dominé la Silicon Valley, les PDG exhortant leurs employés à maximiser l’utilisation de l’IA. Cet enthousiasme a rapidement rencontré la réalité. Selon les informations rapportées, Ub

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai

Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai












