


 首頁
使用GPT-4的遞歸摘要:詳細概述
在當今快節奏的世界中,資訊豐富,濃縮長篇文章成簡潔摘要的技能比以往任何時候都更有價值。本篇部落格深入探討使用 GPT-4 進行遞迴摘要的迷人世界,提供如何有效縮短冗長文本而不失核心的詳細指南。無論你是學生、研究者,或只是喜歡保持資訊更新的人,你都會發現這種方法非常有用。讓我們一起來探索如何利用 GPT-4 的力量進行有效的文本摘要。
重點
- 遞迴摘要涉及將文本分解為較小的片段,並迭代地摘要這些片段以創建簡潔的概述。
- GPT-4 的廣泛上下文窗口有助於生成更準確且連貫的摘要。
- 詞元限制可能是一個障礙,需要策略性分割文本。
- 撰寫有效的提示詞對於引導 GPT-4 提取最相關的資訊至關重要。
- 此技術在摘要研究論文、法律文件和新聞文章中具有實際應用。
理解遞迴摘要
什麼是遞迴摘要?
遞迴摘要就像是一種濃縮長文本的魔法技巧。它涉及將冗長的文件分解成較小、易於消化的片段,摘要每個片段,然後將這些摘要合併成更高層次的概述。這個過程可以重複多次,直到達到所需的長度。想像處理一份100頁的報告;通過遞迴摘要,你可以創建一個易於管理的摘要,捕捉所有重點,而不會迷失在細節中。
當你處理的文檔超過語言模型(如 GPT-4)的詞元限制時,這種方法尤為出色。通過將任務分割成較小的步驟,你可以確保摘要過程既高效又準確。這就像解決一個大拼圖,逐片拼湊,確保最終圖像中包含每個重要細節。
為什麼使用 GPT-4 進行摘要?
由 OpenAI 開發的 GPT-4 在文本摘要方面是一款強大的工具。得益於其廣大的上下文窗口,它可以處理並保留輸入文本的大量資訊,從而生成更準確且連貫的摘要。它不僅僅是理解文本;GPT-4 能遵循指令並提取最相關的資訊,使其非常適合遞迴摘要的精確任務。
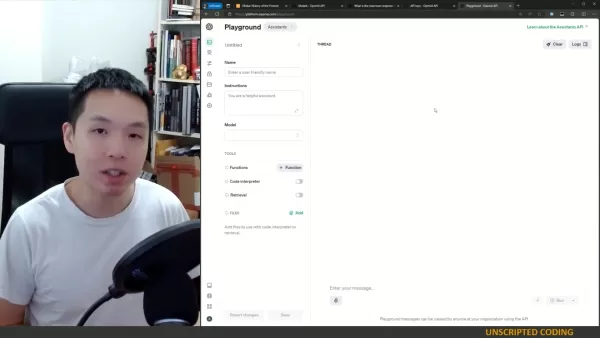
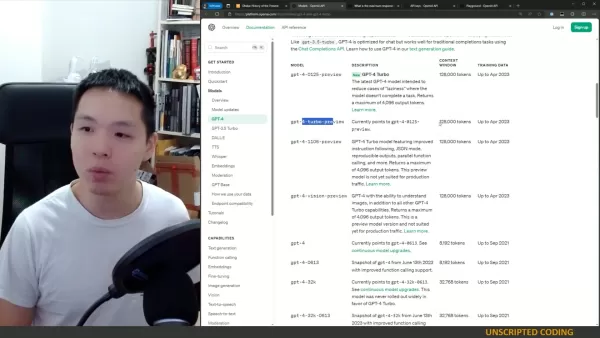
GPT-4 的魅力在於它適應不同寫作風格並處理複雜文本的能力。無論是科學論文還是法律文件,GPT-4 都能篩選內容並提取最重要的細節。有了最新的 GPT-4 Turbo 模型,你可以享受最多4096個輸出詞元,減少模型無法完成任務的可能性。
克服詞元限制
詞元限制的挑戰
使用像 GPT-4 這樣的語言模型進行摘要的最大障礙之一是詞元限制。這些模型一次只能處理一定數量的詞元,當處理非常大的文檔時,這可能是一個真正的挑戰。如果你的文檔超過詞元限制,你需要將其分解成較小、易於管理的片段。
將文本分割成可管理的片段
為了充分利用 GPT-4 進行摘要,你需要將文本分割成適合詞元限制的可管理片段。以下是幫助你做到這一點的逐步方法:
- 確定詞元限制:找出你使用的 GPT-4 模型的最大詞元限制。
- 分割文本:根據段落、章節或篇章將文件分解成較小的部分。
- 對每個片段進行詞元計數:使用分詞器計算每個片段的詞元數量。
- 調整片段大小:如果某個片段超過詞元限制,進一步分割直到所有片段都在可接受範圍內。
通過遵循這些步驟,你可以確保每個片段都在 GPT-4 的詞元限制內,從而實現有效的遞迴摘要。無論是按段落、章節還是篇章分割,目標是保持連貫性同時遵守詞元限制。
有效摘要的策略
有效摘要的重點在於從每個文本片段中提取最相關的資訊,同時保持在詞元限制內。一個有效的策略是專注於識別和保留概括主要觀點和支持論點的關鍵句子。你也可以使用提取式摘要技術,直接從原始文本中複製重要的短語和句子。這對於技術性或學術性內容尤其有用,因為精確的語言至關重要。
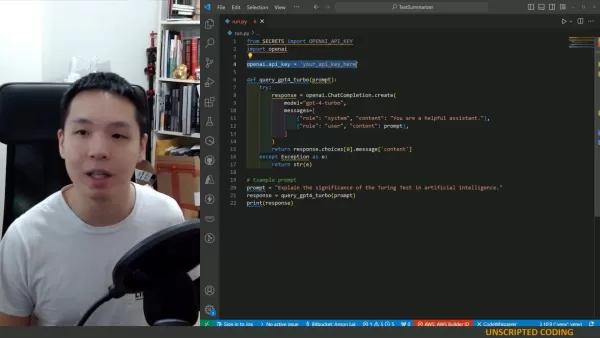
以下是一個簡單的 Python 函數,幫助你將文本分割成片段:
textdef split_text_into_chunks(text, chunk_size=800):
words = text.split()
chunks = [' '.join(words[i:i+chunk_size]) for i in range(0, len(words), chunk_size)]
return chunks
此函數按單詞分割文本,但如果文本中有可用的章節或篇章,你也可以使用這些來分割。
使用 GPT-4 進行遞迴摘要的逐步指南
設置環境
在開始遞迴摘要之前,確保你有權訪問 OpenAI API 和 GPT-4 模型。你需要一個 API 密鑰和 OpenAI Python 庫。
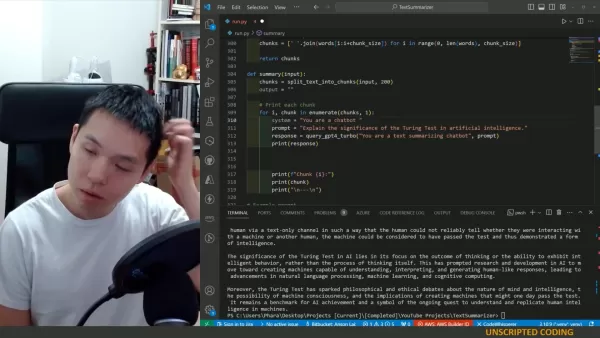
以下是如何設置環境的步驟:
- 安裝 OpenAI 庫:使用 pip install openai 安裝 OpenAI 庫。
- 導入必要模組:導入 openai 和其他文本處理所需的模組。
- 使用 OpenAI 進行身份驗證:設置你的 API 密鑰以進行 OpenAI API 身份驗證。
編寫遞迴摘要函數
現在,讓我們創建一個函數,用於遞迴摘要文本片段。以下是一個示例函數:
textdef summary(input_text):
chunks = split_text_into_chunks(input_text, 800)
output = ""
for i, chunk in enumerate(chunks, 1):
system = "你是一個遞迴摘要文本的聊天機器人。你將處理一篇長篇文章,並逐段摘要。請考慮你已經摘要的內容,以創建一個具有統一風格的連貫摘要。你目前正在處理第 " + str(i) + " 段。到目前為止,你的摘要是:" + output
prompt = "請為文章的以下段落添加摘要:" + chunk
response = query_gpt4_turbo(system, prompt)
output = output + " " + response
print(response)
return output
測試與迭代
實現該函數後,使用各種文章進行測試,檢視其表現如何。你可能需要迭代提示詞和片段大小以優化結果。始終評估摘要的連貫性、準確性和相關性。測試和迭代是完善遞迴摘要過程的關鍵步驟,確保摘要滿足你的需求。
遞迴摘要的優點與缺點
優點
- 可處理超過詞元限制的超大文檔。
- 通過迭代摘要保持連貫性。
- 提供調整摘要長度的靈活性。
缺點
- 需要仔細規劃和提示工程。
- 對於極長的文本可能耗時。
- 與全文分析相比,可能失去一些細微差別。
常見問題 (FAQ)
最大詞元長度是多少?
GPT-4 Turbo 最多返回4096個詞元。
哪些模型可用於遞迴摘要?
GPT-4 和其他具有大上下文窗口的模型適合用於遞迴摘要。
遞迴摘要是什麼意思?
它意味著每個摘要都會考慮後續摘要,確保在單一風格提示下的一致性。
如果文本超過128,000個詞元怎麼辦?
使用此方法和代碼將文本分解成片段,逐步進行摘要。
相關問題
如何提升 GPT-4 摘要的質量?
要提升 GPT-4 摘要的質量,專注於優化提示詞和片段大小。清晰、具體的提示詞引導 GPT-4 提取相關資訊,而適當的片段大小確保模型能有效處理每個文本片段。在編輯器中實現之前,先在試驗場測試也有助益。優化你的提示詞和片段大小,並使用代碼編輯器高效實現和測試系統。記住,測試是關鍵!
相關文章
 前OpenAI首席科學家Ilya的SSI首次釋出模型
AI 取得了另一項重大里程碑。在從 OpenAI 離職後,前首席科學家伊利亞·蘇茨克弗(Ilya Sutskever)創立了 Safe Superintelligence Inc.(SSI),該公司最近公佈了其首個模型的詳細資訊。海外社交媒體上的報道指出,該團隊正在利用 TTT(測試時訓練)開發一個緊湊的推理引擎,這是他們在追求安全超級智慧過程中的關鍵進展。這種新穎的架構專注於使模型能夠“學習如何學習”。與在推理過程中保持引數靜態的傳統大型語言模型不同,該引擎在處理現實世界任務時會動態更新特定
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日,AI應用開發平臺Lovable宣佈參與丹麥硬體初創公司Atech的80萬美元種子輪融資。該輪由Lovable領投,吸引了包括a16z Scout Fund、Sequoia Scout Fund以及Nordic Makers在內的頂級風險投資機構。此次投資標誌著Lovable將“Vibe Coding”概念從純軟體開發戰略擴充套件至硬體工程領域。Atech旨在透過AI驅動的互動式平臺簡化複雜的硬體原型製作。使用者購買基礎硬體套件,並透過AI聊天機器人以自然語言描述其設計概念;系統
Anthropic 將 Claude AI 編碼工具擴充套件至日本,以推動海外增長
Anthropic,一家美國知名的人工智慧公司,正加強其全球推廣力度。週三,該公司在東京舉辦了一場大型開發者活動“Code with Claude”,吸引了近500名軟體工程師參加。該舉措旨在積極將Claude AI工具及相關產品引入日本市場,強調其自主編碼能力在提升企業生產力方面的核心優勢。強調自動化程式碼生成在活動中,Anthropic展示了其先進的自主編碼系統,該系統能夠獨立處理複雜的程式設計任務並最佳化現有程式碼結構。隨著全球對高效開發工具的需求不斷增長,Anthropic希望透過此類活動加強
相關專題推薦
聊天機器人
 最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
 12 個工具
 xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
數據分析
最佳人工智慧資料清洗工具:快速處理缺失值與重複資料
2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai
設計與藝術
最佳AI創意構思工具,助力藝術家突破視覺瓶頸
2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

 評論 (18)
0/500
![BruceMiller]()
Les résumés récursifs, c'est vraiment la solution face à l'infobésité ? L'article est clair, mais je me demande si cette technique ne risque pas de trop simplifier certains sujets complexes. Après tout, la nuance se perd parfois quand on raccourcit trop. Ça pourrait être problématique pour les nouvelles scientifiques ou politiques.
![RonaldHernández]()
This recursive summarization stuff with GPT-4 is wild! It’s like teaching a super-smart robot to shrink novels into tweets. I wonder how it handles super technical papers though? 🤔
![JohnRoberts]()
This recursive summarization thing with GPT-4 sounds like a game-changer! I love how it can boil down massive articles into bite-sized nuggets. Makes me wonder if I’ll ever read a full article again 😂. Anyone tried this in their workflow yet?
![GeorgeTaylor]()
A Sumarização Recursiva com GPT-4 é incrível! É como mágica como ele consegue pegar um artigo longo e reduzi-lo ao essencial. Usei no trabalho e economizou muito tempo. Só queria que fosse um pouco mais amigável, a interface pode ser confusa. Ainda assim, é uma ferramenta revolucionária! 🌟
![FrankSmith]()
¡La Sumarización Recursiva con GPT-4 es impresionante! Es muy útil para condensar artículos largos, aunque a veces las summaries pierden un poco del sabor original. Aún así, es una gran herramienta para quien necesita captar rápidamente la esencia de textos extensos. ¡Pruébalo! 📚
![MatthewGonzalez]()
A Sumarização Recursiva com GPT-4 é incrível! É super útil para condensar artigos longos, mas às vezes os resumos perdem um pouco do sabor original. Ainda assim, é uma ótima ferramenta para quem precisa captar rapidamente a essência de textos extensos. Experimente! 📚
在當今快節奏的世界中,資訊豐富,濃縮長篇文章成簡潔摘要的技能比以往任何時候都更有價值。本篇部落格深入探討使用 GPT-4 進行遞迴摘要的迷人世界,提供如何有效縮短冗長文本而不失核心的詳細指南。無論你是學生、研究者,或只是喜歡保持資訊更新的人,你都會發現這種方法非常有用。讓我們一起來探索如何利用 GPT-4 的力量進行有效的文本摘要。
重點
- 遞迴摘要涉及將文本分解為較小的片段,並迭代地摘要這些片段以創建簡潔的概述。
- GPT-4 的廣泛上下文窗口有助於生成更準確且連貫的摘要。
- 詞元限制可能是一個障礙,需要策略性分割文本。
- 撰寫有效的提示詞對於引導 GPT-4 提取最相關的資訊至關重要。
- 此技術在摘要研究論文、法律文件和新聞文章中具有實際應用。
理解遞迴摘要
什麼是遞迴摘要?
遞迴摘要就像是一種濃縮長文本的魔法技巧。它涉及將冗長的文件分解成較小、易於消化的片段,摘要每個片段,然後將這些摘要合併成更高層次的概述。這個過程可以重複多次,直到達到所需的長度。想像處理一份100頁的報告;通過遞迴摘要,你可以創建一個易於管理的摘要,捕捉所有重點,而不會迷失在細節中。
當你處理的文檔超過語言模型(如 GPT-4)的詞元限制時,這種方法尤為出色。通過將任務分割成較小的步驟,你可以確保摘要過程既高效又準確。這就像解決一個大拼圖,逐片拼湊,確保最終圖像中包含每個重要細節。
為什麼使用 GPT-4 進行摘要?
由 OpenAI 開發的 GPT-4 在文本摘要方面是一款強大的工具。得益於其廣大的上下文窗口,它可以處理並保留輸入文本的大量資訊,從而生成更準確且連貫的摘要。它不僅僅是理解文本;GPT-4 能遵循指令並提取最相關的資訊,使其非常適合遞迴摘要的精確任務。
GPT-4 的魅力在於它適應不同寫作風格並處理複雜文本的能力。無論是科學論文還是法律文件,GPT-4 都能篩選內容並提取最重要的細節。有了最新的 GPT-4 Turbo 模型,你可以享受最多4096個輸出詞元,減少模型無法完成任務的可能性。
克服詞元限制
詞元限制的挑戰
使用像 GPT-4 這樣的語言模型進行摘要的最大障礙之一是詞元限制。這些模型一次只能處理一定數量的詞元,當處理非常大的文檔時,這可能是一個真正的挑戰。如果你的文檔超過詞元限制,你需要將其分解成較小、易於管理的片段。
將文本分割成可管理的片段
為了充分利用 GPT-4 進行摘要,你需要將文本分割成適合詞元限制的可管理片段。以下是幫助你做到這一點的逐步方法:
- 確定詞元限制:找出你使用的 GPT-4 模型的最大詞元限制。
- 分割文本:根據段落、章節或篇章將文件分解成較小的部分。
- 對每個片段進行詞元計數:使用分詞器計算每個片段的詞元數量。
- 調整片段大小:如果某個片段超過詞元限制,進一步分割直到所有片段都在可接受範圍內。
通過遵循這些步驟,你可以確保每個片段都在 GPT-4 的詞元限制內,從而實現有效的遞迴摘要。無論是按段落、章節還是篇章分割,目標是保持連貫性同時遵守詞元限制。
有效摘要的策略
有效摘要的重點在於從每個文本片段中提取最相關的資訊,同時保持在詞元限制內。一個有效的策略是專注於識別和保留概括主要觀點和支持論點的關鍵句子。你也可以使用提取式摘要技術,直接從原始文本中複製重要的短語和句子。這對於技術性或學術性內容尤其有用,因為精確的語言至關重要。
以下是一個簡單的 Python 函數,幫助你將文本分割成片段:
def split_text_into_chunks(text, chunk_size=800):
    words = text.split()
    chunks = [' '.join(words[i:i+chunk_size]) for i in range(0, len(words), chunk_size)]
    return chunks
此函數按單詞分割文本,但如果文本中有可用的章節或篇章,你也可以使用這些來分割。
使用 GPT-4 進行遞迴摘要的逐步指南
設置環境
在開始遞迴摘要之前,確保你有權訪問 OpenAI API 和 GPT-4 模型。你需要一個 API 密鑰和 OpenAI Python 庫。
以下是如何設置環境的步驟:
- 安裝 OpenAI 庫:使用 pip install openai 安裝 OpenAI 庫。
- 導入必要模組:導入 openai 和其他文本處理所需的模組。
- 使用 OpenAI 進行身份驗證:設置你的 API 密鑰以進行 OpenAI API 身份驗證。
編寫遞迴摘要函數
現在,讓我們創建一個函數,用於遞迴摘要文本片段。以下是一個示例函數:
def summary(input_text):
    chunks = split_text_into_chunks(input_text, 800)
    output = ""
    for i, chunk in enumerate(chunks, 1):
        system = "你是一個遞迴摘要文本的聊天機器人。你將處理一篇長篇文章,並逐段摘要。請考慮你已經摘要的內容,以創建一個具有統一風格的連貫摘要。你目前正在處理第 " + str(i) + " 段。到目前為止,你的摘要是:" + output
        prompt = "請為文章的以下段落添加摘要:" + chunk
        response = query_gpt4_turbo(system, prompt)
        output = output + " " + response
        print(response)
    return output
測試與迭代
實現該函數後,使用各種文章進行測試,檢視其表現如何。你可能需要迭代提示詞和片段大小以優化結果。始終評估摘要的連貫性、準確性和相關性。測試和迭代是完善遞迴摘要過程的關鍵步驟,確保摘要滿足你的需求。
遞迴摘要的優點與缺點
優點
- 可處理超過詞元限制的超大文檔。
- 通過迭代摘要保持連貫性。
- 提供調整摘要長度的靈活性。
缺點
- 需要仔細規劃和提示工程。
- 對於極長的文本可能耗時。
- 與全文分析相比,可能失去一些細微差別。
常見問題 (FAQ)
最大詞元長度是多少?
GPT-4 Turbo 最多返回4096個詞元。
哪些模型可用於遞迴摘要?
GPT-4 和其他具有大上下文窗口的模型適合用於遞迴摘要。
遞迴摘要是什麼意思?
它意味著每個摘要都會考慮後續摘要,確保在單一風格提示下的一致性。
如果文本超過128,000個詞元怎麼辦?
使用此方法和代碼將文本分解成片段,逐步進行摘要。
相關問題
如何提升 GPT-4 摘要的質量?
要提升 GPT-4 摘要的質量,專注於優化提示詞和片段大小。清晰、具體的提示詞引導 GPT-4 提取相關資訊,而適當的片段大小確保模型能有效處理每個文本片段。在編輯器中實現之前,先在試驗場測試也有助益。優化你的提示詞和片段大小,並使用代碼編輯器高效實現和測試系統。記住,測試是關鍵!








 前OpenAI首席科學家Ilya的SSI首次釋出模型
AI 取得了另一項重大里程碑。在從 OpenAI 離職後,前首席科學家伊利亞·蘇茨克弗(Ilya Sutskever)創立了 Safe Superintelligence Inc.(SSI),該公司最近公佈了其首個模型的詳細資訊。海外社交媒體上的報道指出,該團隊正在利用 TTT(測試時訓練)開發一個緊湊的推理引擎,這是他們在追求安全超級智慧過程中的關鍵進展。這種新穎的架構專注於使模型能夠“學習如何學習”。與在推理過程中保持引數靜態的傳統大型語言模型不同,該引擎在處理現實世界任務時會動態更新特定
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日,AI應用開發平臺Lovable宣佈參與丹麥硬體初創公司Atech的80萬美元種子輪融資。該輪由Lovable領投,吸引了包括a16z Scout Fund、Sequoia Scout Fund以及Nordic Makers在內的頂級風險投資機構。此次投資標誌著Lovable將“Vibe Coding”概念從純軟體開發戰略擴充套件至硬體工程領域。Atech旨在透過AI驅動的互動式平臺簡化複雜的硬體原型製作。使用者購買基礎硬體套件,並透過AI聊天機器人以自然語言描述其設計概念;系統
 Anthropic 將 Claude AI 編碼工具擴充套件至日本,以推動海外增長
Anthropic,一家美國知名的人工智慧公司,正加強其全球推廣力度。週三,該公司在東京舉辦了一場大型開發者活動“Code with Claude”,吸引了近500名軟體工程師參加。該舉措旨在積極將Claude AI工具及相關產品引入日本市場,強調其自主編碼能力在提升企業生產力方面的核心優勢。強調自動化程式碼生成在活動中,Anthropic展示了其先進的自主編碼系統,該系統能夠獨立處理複雜的程式設計任務並最佳化現有程式碼結構。隨著全球對高效開發工具的需求不斷增長,Anthropic希望透過此類活動加強

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

Les résumés récursifs, c'est vraiment la solution face à l'infobésité ? L'article est clair, mais je me demande si cette technique ne risque pas de trop simplifier certains sujets complexes. Après tout, la nuance se perd parfois quand on raccourcit trop. Ça pourrait être problématique pour les nouvelles scientifiques ou politiques.
This recursive summarization stuff with GPT-4 is wild! It’s like teaching a super-smart robot to shrink novels into tweets. I wonder how it handles super technical papers though? 🤔
This recursive summarization thing with GPT-4 sounds like a game-changer! I love how it can boil down massive articles into bite-sized nuggets. Makes me wonder if I’ll ever read a full article again 😂. Anyone tried this in their workflow yet?
A Sumarização Recursiva com GPT-4 é incrível! É como mágica como ele consegue pegar um artigo longo e reduzi-lo ao essencial. Usei no trabalho e economizou muito tempo. Só queria que fosse um pouco mais amigável, a interface pode ser confusa. Ainda assim, é uma ferramenta revolucionária! 🌟
¡La Sumarización Recursiva con GPT-4 es impresionante! Es muy útil para condensar artículos largos, aunque a veces las summaries pierden un poco del sabor original. Aún así, es una gran herramienta para quien necesita captar rápidamente la esencia de textos extensos. ¡Pruébalo! 📚
A Sumarização Recursiva com GPT-4 é incrível! É super útil para condensar artigos longos, mas às vezes os resumos perdem um pouco do sabor original. Ainda assim, é uma ótima ferramenta para quem precisa captar rapidamente a essência de textos extensos. Experimente! 📚












