


 首頁
MiniMax 釋出 M3,一款超越 GPT-5.5 的國產 AI 大模型
中國的AI領域迎來了重大技術飛躍,隨著稀宇科技(Xiyu Technology)最新大型語言模型MiniMax M3的正式推出。這一先進系統結合了最先進的編碼能力,並支援高達100萬token的超長上下文視窗。值得注意的是,它原生支援多模態輸入,包括影象和影片處理,以及計算機桌面互動,使其成為中國首個整合這三項關鍵能力的開源模型。
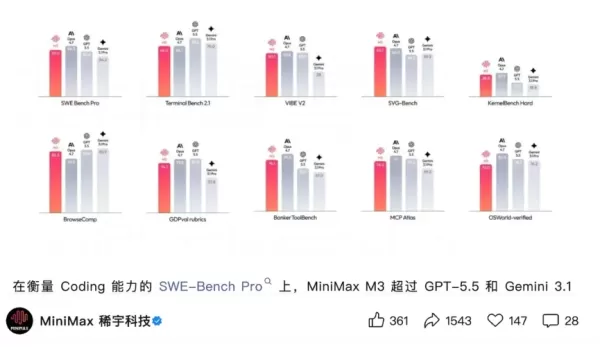
標準化基準測試中的卓越表現
在嚴格的SWE-Bench Pro程式設計評估中,MiniMax M3獲得了59.0%的分數,超越了GPT-5.5和Gemini 3.1 Pro,同時緊追頂級模型Opus 4.7。該模型在AI代理能力的Claw-Eval測試中也展示了優越的效能,並在OmniDocBench多模態文件理解基準測試中取得了領先分數。
先進架構提升效率
推動這一效能的是M3採用的新型稀疏注意力架構(MSA)。在處理100萬token的超長上下文時,與上一代模型相比,該設計將單個token的計算量減少了一半。因此,該模型的解析速度提升了9倍以上,答案生成速度提升了15倍以上。API現已上線,官方團隊承諾在10天內向全球開發者釋出模型權重和技術報告。
相關文章
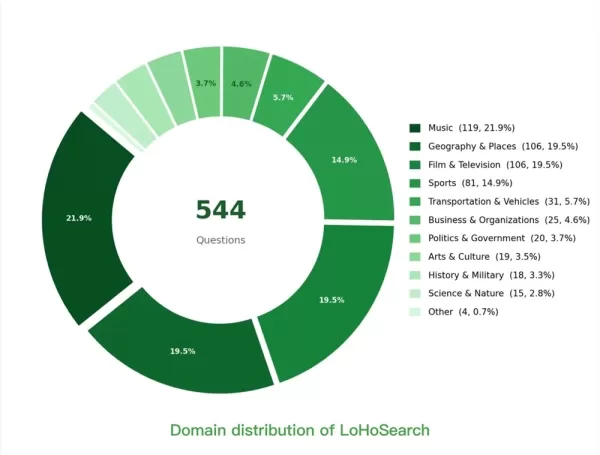
 Meitun LongCat 推出 LoHoSearch,而 BrowseComp 的得分已跌至 30% 以下
過去一年中,搜尋智慧體(Search Agent)的能力在很大程度上由 BrowseComp 基準測試所定義。然而,該基準測試正逐漸失去其相關性——它在短短十個月內將模型效能從 30% 提升至 90%,但其價值正在迅速衰減。7 月 17 日,美團旗下 LongCat 推出了更為嚴格的評估標準 LoHoSearch,旨在重新激發搜尋智慧體開發領域的實質性進展。LoHoSearch 的挑戰並非人工構建,而是從包含 762 萬個實體的維基百科知識圖譜中自動生成。由於這些任務是機器生成的,它們達到了人類
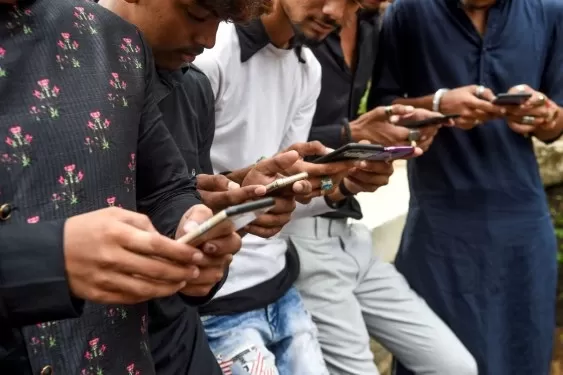
印度要求來電顯示應用程式與電信運營商共享垃圾資料
印度擴大了其反垃圾簡訊法規,要求來電顯示和電話管理應用程式與電信運營商共享使用者垃圾報告,這一舉措導致知名垃圾阻止應用程式提供商 Truecaller 將該政策標記為反競爭。週五,印度電信監管機構印度電信管理局(TRAI)更新了規範商業通訊的規則。這些更新強制要求允許使用者將電話標記為垃圾或 junk 的來電 ID 和電話管理應用程式,將這些報告傳輸到由電信運營商運營的基於區塊鏈的平臺。該平臺監控商業通訊並執行反垃圾協議。根據 TRAI 的說法,這一修改旨在擴大可用於打擊垃圾簡訊傳送者的垃圾報告
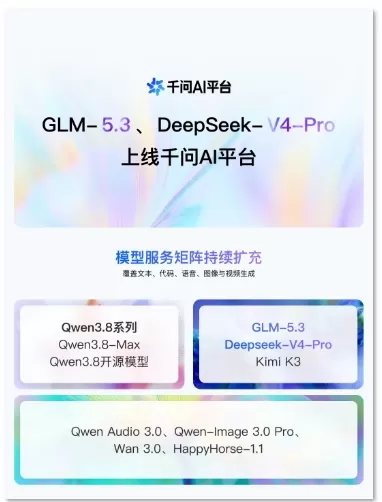
Qwen AI 平臺透過正式釋出 GLM-5.3 和 DeepSeek-V4-Pro,進一步擴充套件其模型矩陣
阿里雲通義千問 AI 平臺(MaaS)近期進一步擴充了模型服務矩陣,接入了智譜的旗艦大模型 GLM-5.3,並正式釋出了 DeepSeek-V4-Pro。相關的 API 服務現已面向公眾開放,使開發者能夠快速接入並利用這些模型能力。這兩款新推出的模型專為程式設計和智慧體核心應用場景設計。GLM-5.3 基於智譜最新技術成果構建,顯著提升了程式設計能力、長週期任務執行以及網路安全防護水平。與此同時,DeepSeek-V4-Pro 專注於增強智慧體互動體驗,使其成為程式碼開發及多步複雜任務處理的理想選擇。目前
相關專題推薦
音樂創作
 用於生成歌詞與旋律構思的 AI 歌曲創作工具
2026年最新、最優秀、評分最高的用於生成歌詞與旋律靈感的AI作曲工具現已在XIX.AI上亮相!這份精心挑選的合集彙集了諸多功能強大且具有顛覆性意義的工具,它們均經過嚴格的實際應用測試,能夠提供精準的歌詞與旋律建議。您可以檢視免費版本與付費版本的對比資訊、詳細的排名資料,還能發現那些能顯著提升您創作效率的必備工具。立即探索,找到最適合您需求的方案吧!
 8 個工具
 xix.ai
健康與養生
ChatGPT 餐食規劃應用程式:用於追蹤營養素攝取、製作購物清單及每週備餐
2026 年最新最佳 ChatGPT 餐點規劃應用程式:精選高評價、必試且功能強大的革命性工具,助您追蹤宏量營養素、管理購物清單及進行每週備餐。XIX.AI 根據實際測試結果提供每週更新的排行榜,其中包含免費版與付費版的詳細比較資訊。立即發現最適合您的工具,提升工作效率,並解鎖您的 AI 優勢。現在就來探索吧!
9 個工具
xix.ai
視頻創作
適用於短片內容的 AI 影片腳本工具
2026 年最新、最受好評的短影片 AI 腳本工具!XIX.AI 精心精選了一系列強大且顛覆業界的必試工具,這些工具均經過嚴格的實戰測試。 您將在此找到每週更新的詳細排行榜、免費與付費版本的比較資訊,以及有助於提升工作效率、在創作高品質短影片內容時發揮 AI 優勢的專業見解。立即探索,找出最適合您的工具!
10 個工具
xix.ai
漫畫創作
適用於分鏡式敘事的 AI 漫畫分格工具
2026 年最新最佳 AI 漫畫分鏡工具,專為分鏡式敘事而設計!這份精心精選的頂級工具合集,匯集了強大且顛覆業界的解決方案,能協助創作者提升寫作效率並突破創作瓶頸。 您將在此找到詳盡的免費版與付費版比較、實際測試結果以及官方排名,助您做出明智選擇。XIX.AI 亦提供專家見解。立即探索,發掘能讓生動故事栩栩如生的完美工具!238 個字元
9 個工具
xix.ai
視頻創作
最佳用於短影片內容的AI影片生成工具
2026 年最新、最佳、最受好評的 AI 短影片生成工具已上線,收錄於 XIX.AI 精選合集。這些強大的變革性工具經過嚴格的真實世界測試,提供全面的免費與付費對比及詳細排名,助您找到完美選項。無論您需要快速製作高質量短影片,還是提升各項任務的生產力,這些必試方案均能帶來卓越成果。立即探索,發現您的理想工具,釋放 AI 優勢。
9 個工具
xix.ai
設計與藝術
最佳 AI 繪畫生成工具:探索靈感板、風格及視覺方向
2026年最新最佳AI藝術生成工具排行榜為您呈現了那些評分最高的工具,它們能夠幫助您打造令人驚歎的構思板、探索多種不同的風格,並確定視覺創作方向。XIX.AI精心整理了一份包含經過嚴格實際測試、具備強大功能且能帶來顛覆性體驗的工具清單。您還可以檢視免費版與付費版的對比資訊,從而找到最適合提升創意工作流程的工具。立即探索,讓AI助力您的藝術創作更上一層樓。
10 個工具
xix.ai

 評論 (0)
0/500
中國的AI領域迎來了重大技術飛躍,隨著稀宇科技(Xiyu Technology)最新大型語言模型MiniMax M3的正式推出。這一先進系統結合了最先進的編碼能力,並支援高達100萬token的超長上下文視窗。值得注意的是,它原生支援多模態輸入,包括影象和影片處理,以及計算機桌面互動,使其成為中國首個整合這三項關鍵能力的開源模型。
標準化基準測試中的卓越表現
在嚴格的SWE-Bench Pro程式設計評估中,MiniMax M3獲得了59.0%的分數,超越了GPT-5.5和Gemini 3.1 Pro,同時緊追頂級模型Opus 4.7。該模型在AI代理能力的Claw-Eval測試中也展示了優越的效能,並在OmniDocBench多模態文件理解基準測試中取得了領先分數。
先進架構提升效率
推動這一效能的是M3採用的新型稀疏注意力架構(MSA)。在處理100萬token的超長上下文時,與上一代模型相比,該設計將單個token的計算量減少了一半。因此,該模型的解析速度提升了9倍以上,答案生成速度提升了15倍以上。API現已上線,官方團隊承諾在10天內向全球開發者釋出模型權重和技術報告。








 Meitun LongCat 推出 LoHoSearch,而 BrowseComp 的得分已跌至 30% 以下
過去一年中,搜尋智慧體(Search Agent)的能力在很大程度上由 BrowseComp 基準測試所定義。然而,該基準測試正逐漸失去其相關性——它在短短十個月內將模型效能從 30% 提升至 90%,但其價值正在迅速衰減。7 月 17 日,美團旗下 LongCat 推出了更為嚴格的評估標準 LoHoSearch,旨在重新激發搜尋智慧體開發領域的實質性進展。LoHoSearch 的挑戰並非人工構建,而是從包含 762 萬個實體的維基百科知識圖譜中自動生成。由於這些任務是機器生成的,它們達到了人類
 印度要求來電顯示應用程式與電信運營商共享垃圾資料
印度擴大了其反垃圾簡訊法規,要求來電顯示和電話管理應用程式與電信運營商共享使用者垃圾報告,這一舉措導致知名垃圾阻止應用程式提供商 Truecaller 將該政策標記為反競爭。週五,印度電信監管機構印度電信管理局(TRAI)更新了規範商業通訊的規則。這些更新強制要求允許使用者將電話標記為垃圾或 junk 的來電 ID 和電話管理應用程式,將這些報告傳輸到由電信運營商運營的基於區塊鏈的平臺。該平臺監控商業通訊並執行反垃圾協議。根據 TRAI 的說法,這一修改旨在擴大可用於打擊垃圾簡訊傳送者的垃圾報告
 Qwen AI 平臺透過正式釋出 GLM-5.3 和 DeepSeek-V4-Pro,進一步擴充套件其模型矩陣
阿里雲通義千問 AI 平臺(MaaS)近期進一步擴充了模型服務矩陣,接入了智譜的旗艦大模型 GLM-5.3,並正式釋出了 DeepSeek-V4-Pro。相關的 API 服務現已面向公眾開放,使開發者能夠快速接入並利用這些模型能力。這兩款新推出的模型專為程式設計和智慧體核心應用場景設計。GLM-5.3 基於智譜最新技術成果構建,顯著提升了程式設計能力、長週期任務執行以及網路安全防護水平。與此同時,DeepSeek-V4-Pro 專注於增強智慧體互動體驗,使其成為程式碼開發及多步複雜任務處理的理想選擇。目前

2026年最新、最優秀、評分最高的用於生成歌詞與旋律靈感的AI作曲工具現已在XIX.AI上亮相!這份精心挑選的合集彙集了諸多功能強大且具有顛覆性意義的工具,它們均經過嚴格的實際應用測試,能夠提供精準的歌詞與旋律建議。您可以檢視免費版本與付費版本的對比資訊、詳細的排名資料,還能發現那些能顯著提升您創作效率的必備工具。立即探索,找到最適合您需求的方案吧!
8 個工具
xix.ai

2026 年最新最佳 ChatGPT 餐點規劃應用程式:精選高評價、必試且功能強大的革命性工具,助您追蹤宏量營養素、管理購物清單及進行每週備餐。XIX.AI 根據實際測試結果提供每週更新的排行榜,其中包含免費版與付費版的詳細比較資訊。立即發現最適合您的工具,提升工作效率,並解鎖您的 AI 優勢。現在就來探索吧!
9 個工具
xix.ai

2026 年最新、最受好評的短影片 AI 腳本工具!XIX.AI 精心精選了一系列強大且顛覆業界的必試工具,這些工具均經過嚴格的實戰測試。 您將在此找到每週更新的詳細排行榜、免費與付費版本的比較資訊,以及有助於提升工作效率、在創作高品質短影片內容時發揮 AI 優勢的專業見解。立即探索,找出最適合您的工具!
10 個工具
xix.ai

2026 年最新最佳 AI 漫畫分鏡工具,專為分鏡式敘事而設計!這份精心精選的頂級工具合集,匯集了強大且顛覆業界的解決方案,能協助創作者提升寫作效率並突破創作瓶頸。 您將在此找到詳盡的免費版與付費版比較、實際測試結果以及官方排名,助您做出明智選擇。XIX.AI 亦提供專家見解。立即探索,發掘能讓生動故事栩栩如生的完美工具!238 個字元
9 個工具
xix.ai

2026 年最新、最佳、最受好評的 AI 短影片生成工具已上線,收錄於 XIX.AI 精選合集。這些強大的變革性工具經過嚴格的真實世界測試,提供全面的免費與付費對比及詳細排名,助您找到完美選項。無論您需要快速製作高質量短影片,還是提升各項任務的生產力,這些必試方案均能帶來卓越成果。立即探索,發現您的理想工具,釋放 AI 優勢。
9 個工具
xix.ai

2026年最新最佳AI藝術生成工具排行榜為您呈現了那些評分最高的工具,它們能夠幫助您打造令人驚歎的構思板、探索多種不同的風格,並確定視覺創作方向。XIX.AI精心整理了一份包含經過嚴格實際測試、具備強大功能且能帶來顛覆性體驗的工具清單。您還可以檢視免費版與付費版的對比資訊,從而找到最適合提升創意工作流程的工具。立即探索,讓AI助力您的藝術創作更上一層樓。
10 個工具
xix.ai












