


 首頁
前 OpenAI 研究員田永龍將加入騰訊「混元」多模態團隊
人工智慧產業傳出重大人事異動:前 OpenAI 研究員田永龍已加入騰訊。據悉,他將領導騰訊混元的多模態模型研發方向,重點聚焦於視覺語言模型(VLMs)。儘管尚未獲得官方證實,但這則消息已引起廣泛關注。 若消息屬實,田永龍將繼姚順宇之後,成為最新加入騰訊混元團隊的核心研究人才。
田永龍的加入,彰顯了騰訊對多模態大型模型的持續投入。他與騰訊現任首席人工智慧科學家姚順宇曾於 OpenAI 共事,共同見證了 GPT 及多模態技術的發展歷程。 田博士擁有深厚的電腦視覺背景,他先後獲得清華大學學士學位、香港中文大學 MMLab 碩士學位,以及麻省理工學院(MIT)博士學位。 他的研究軌跡顯示出從傳統視覺辨識向生成式模型與表徵學習的明確轉變,其研究成果在 Google Scholar 上獲得近 30,000 次引用。
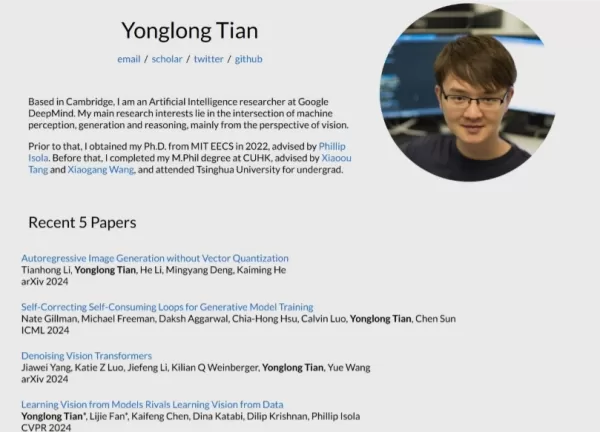
在學術方面,田先生做出了顯著貢獻。他提出的「監督式對比學習(Supervised Contrastive Learning)」將對比學習延伸至監督式情境,對視覺預訓練模型的設計產生了重大影響。 近期,他在自迴歸圖像生成領域的研究——尤其是「Fluid」系列——展現了連續標記在視覺品質方面的優勢,為大型模型生成開闢了新途徑。加入騰訊之前,他曾任職於 Google Research 和 Google DeepMind,其後以技術人員身分加入 OpenAI。
此次聘任是騰訊混元多模態團隊近期組織重組與人才戰略的關鍵環節。自 2025 年 4 月騰訊正式成立大語言模型部與多模態模型部以來,該團隊便持續積極擴編。 多位來自微軟、阿里巴巴及清華大學的資深研究人員已相繼加入,旨在解決過往資源分散的問題,並建立更具競爭力的多模態研發體系。
隨著田先生等頂尖人才的加入,騰訊混元在多模態與視覺感知領域的研究能力有望進一步強化。作為人工智慧產業的重要參與者,騰訊持續的人才招募行動,彰顯了其對提升混元模型多模態能力的深層戰略承諾。
相關文章
 Instinct 在群聊中推出 AI 智慧體,包括與非使用者的群聊
Instinct,這家在最新一輪融資後估值達100億美元的AI智慧體,正拓展至群聊領域。該公司於週一宣佈,使用者可將該智慧體新增到與朋友的對話中,在旅行規劃、獲取活動門票、管理夢幻體育聯盟、組織拼車或協調感恩節聚餐等場景中提供幫助。值得注意的是,該公司表示,即使使用者的親友未加入Instinct,與AI智慧體的群聊功能依然可用。透過此次釋出,Instinct在與其主要競爭對手(如Meta的Muse)的競爭中進一步邁進。儘管Meta的舊版應用Meta AI可新增到WhatsApp、Messen
MiniMax 釋出 H3 多模態模型,將 15 秒 2K 音影片生成成本降至行業標準的三分之一以下
MiniMax 正式釋出了 MiniMax H3,這是一款通用多模態生成模型,旨在統一文字、影象、影片和音訊的理解與創作。透過彌合影片生成任務與模態之間的歷史鴻溝,此次釋出標誌著從專用工具向多功能一體化助手的關鍵轉變。根據官方規格,H3 原生支援雙通道音影片輸出,能夠生成長達 15 秒、解析度為 2K 的內容。早期邀請測試證實了其在指令遵循、品牌敘事以及影片到影片動作遷移等領域的商業級穩定性。該模型已部署於廣告、電子商務、遊戲和 UI 設計等多個領域。在技術層面,H3 利用上下文全表徵(Cont
世界銀行敦促新興經濟體跳過大型模型,專注於本地小工具
世界銀行最新報告為發展中國家規劃了一條務實的發展路徑:立即將人工智慧整合到公共管理和商業活動中,同時根據當地情況調整現有解決方案。無需在大型資料中心或基礎語言模型方面與富裕國家展開昂貴的競爭。與其將資源投入龐大的計算基礎設施,優先採用負擔得起且適應本地的人工智慧工具,才是提升醫療和教育水平的更可行路徑。這一指導方針基於緊迫的經濟現實。發展中國家目前正面臨三十年來最弱的平均增長率,但世界銀行認為,人工智慧可以成為恢復增長軌跡的催化劑。報告強調,人工智慧更有可能增強勞動力能力,而非取代他們,並設想
相關專題推薦
設計與藝術
 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
 10 個工具
 xix.ai
教育與學習
頂尖 AI 補習老師助您備考:練習數學、科學和英語
2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai
金融
用於個人財務管理的 AI 預算規劃工具
2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai
健康與養生
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai
數據分析
用於產品與營收分析的 AI SQL 協作助手
2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai
教育與學習
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

 評論 (0)
0/500
人工智慧產業傳出重大人事異動:前 OpenAI 研究員田永龍已加入騰訊。據悉,他將領導騰訊混元的多模態模型研發方向,重點聚焦於視覺語言模型(VLMs)。儘管尚未獲得官方證實,但這則消息已引起廣泛關注。 若消息屬實,田永龍將繼姚順宇之後,成為最新加入騰訊混元團隊的核心研究人才。
田永龍的加入,彰顯了騰訊對多模態大型模型的持續投入。他與騰訊現任首席人工智慧科學家姚順宇曾於 OpenAI 共事,共同見證了 GPT 及多模態技術的發展歷程。 田博士擁有深厚的電腦視覺背景,他先後獲得清華大學學士學位、香港中文大學 MMLab 碩士學位,以及麻省理工學院(MIT)博士學位。 他的研究軌跡顯示出從傳統視覺辨識向生成式模型與表徵學習的明確轉變,其研究成果在 Google Scholar 上獲得近 30,000 次引用。
在學術方面,田先生做出了顯著貢獻。他提出的「監督式對比學習(Supervised Contrastive Learning)」將對比學習延伸至監督式情境,對視覺預訓練模型的設計產生了重大影響。 近期,他在自迴歸圖像生成領域的研究——尤其是「Fluid」系列——展現了連續標記在視覺品質方面的優勢,為大型模型生成開闢了新途徑。加入騰訊之前,他曾任職於 Google Research 和 Google DeepMind,其後以技術人員身分加入 OpenAI。
此次聘任是騰訊混元多模態團隊近期組織重組與人才戰略的關鍵環節。自 2025 年 4 月騰訊正式成立大語言模型部與多模態模型部以來,該團隊便持續積極擴編。 多位來自微軟、阿里巴巴及清華大學的資深研究人員已相繼加入,旨在解決過往資源分散的問題,並建立更具競爭力的多模態研發體系。
隨著田先生等頂尖人才的加入,騰訊混元在多模態與視覺感知領域的研究能力有望進一步強化。作為人工智慧產業的重要參與者,騰訊持續的人才招募行動,彰顯了其對提升混元模型多模態能力的深層戰略承諾。








 Instinct 在群聊中推出 AI 智慧體,包括與非使用者的群聊
Instinct,這家在最新一輪融資後估值達100億美元的AI智慧體,正拓展至群聊領域。該公司於週一宣佈,使用者可將該智慧體新增到與朋友的對話中,在旅行規劃、獲取活動門票、管理夢幻體育聯盟、組織拼車或協調感恩節聚餐等場景中提供幫助。值得注意的是,該公司表示,即使使用者的親友未加入Instinct,與AI智慧體的群聊功能依然可用。透過此次釋出,Instinct在與其主要競爭對手(如Meta的Muse)的競爭中進一步邁進。儘管Meta的舊版應用Meta AI可新增到WhatsApp、Messen
 MiniMax 釋出 H3 多模態模型,將 15 秒 2K 音影片生成成本降至行業標準的三分之一以下
MiniMax 正式釋出了 MiniMax H3,這是一款通用多模態生成模型,旨在統一文字、影象、影片和音訊的理解與創作。透過彌合影片生成任務與模態之間的歷史鴻溝,此次釋出標誌著從專用工具向多功能一體化助手的關鍵轉變。根據官方規格,H3 原生支援雙通道音影片輸出,能夠生成長達 15 秒、解析度為 2K 的內容。早期邀請測試證實了其在指令遵循、品牌敘事以及影片到影片動作遷移等領域的商業級穩定性。該模型已部署於廣告、電子商務、遊戲和 UI 設計等多個領域。在技術層面,H3 利用上下文全表徵(Cont
 世界銀行敦促新興經濟體跳過大型模型,專注於本地小工具
世界銀行最新報告為發展中國家規劃了一條務實的發展路徑:立即將人工智慧整合到公共管理和商業活動中,同時根據當地情況調整現有解決方案。無需在大型資料中心或基礎語言模型方面與富裕國家展開昂貴的競爭。與其將資源投入龐大的計算基礎設施,優先採用負擔得起且適應本地的人工智慧工具,才是提升醫療和教育水平的更可行路徑。這一指導方針基於緊迫的經濟現實。發展中國家目前正面臨三十年來最弱的平均增長率,但世界銀行認為,人工智慧可以成為恢復增長軌跡的催化劑。報告強調,人工智慧更有可能增強勞動力能力,而非取代他們,並設想

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
10 個工具
xix.ai

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai












