


 首頁
CoGrader'AI 評分標準生成器旨在減輕教育工作者的評分負擔
在現今多變的教育環境中,教育工作者不斷尋找創新工具,以提高生產力和優化評分工作流程。CoGrader 的 AI 紅寶石生成器是一個突破性的解決方案,它能為教師提供高效的紅寶石創建功能。本指南展示了教育工作者如何利用 AI 技術開發評估工具,以減少工作量,同時保持評分的一致性。
主要功能
CoGrader 的 AI 紅寶石生成器透過智慧型自動化簡化評估設計。
教育工作者可以建立自訂的評量標準,或從廣泛的資料庫中選擇預先設計的範本。
該平台可根據詳細的作業要求和學習目標進行定制。
評量指標可適應各種評估格式,包括能力等級和數字評分系統。
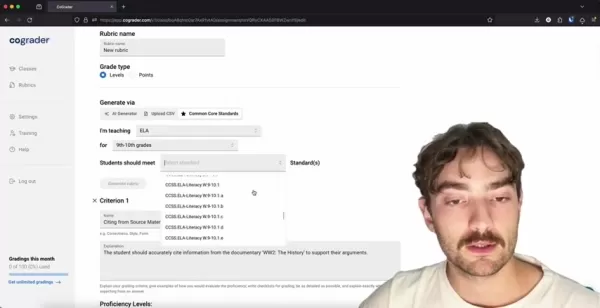
教師可以將評估與共同核心標準相結合,進行以課程為基礎的評估。
自動產生的評量標準包含每個成就等級的全面描述和回應範例。
系統支援 CSV 檔案匯入,以進行無縫的評量標準整合。
CoGrader 透過內建的回饋機制促進綜合評估。
該工具可確保對所有學生作品進行客觀、標準化的評估。
教育工作者可透過手動編輯功能維持完全控制,以獲得個人化的回饋。
探索 CoGrader 的 AI 紅寶石生成器
瞭解 CoGrader 的核心功能
CoGrader 是一個先進的教育平台,支援多樣化的評分與評估需求。AI Rubric Generator 是其基石功能,可讓教師快速建構量身打造的評估框架。
此智慧型工具可處理作業參數,以產生適應性的評分標準,節省教學時間,同時確保評估的可靠性。透過自動化的評量標準開發,CoGrader 可讓教育工作者專注於教學策略和學生互動。
為什麼有效的評量標準很重要?它們為學生的表現建立了透明的基準,創造了一個負責任的學習生態系統。結構完善的評量標準定義了具體的期望和評估標準,幫助學生理解評估參數。這種透明度鼓勵了學習者的自主性和學術責任感。紅寶石還能提供多種教學優勢:
- 提高效率:手動制定評量標準需要投入大量時間。像 CoGrader 這樣的人工智能增強型工具可以大大簡化這個過程。
- 評估可靠性:標準化的評量標準可減少評分的不一致和評量者的偏見。
- 期望明確:有組織的評量標準結構可明確傳達專案要求。
- 有針對性的評估:評量標準可提供重點、建設性的回饋,引導學生改進。
進入 CoGrader 平台介面
透過安全的登入認證存取平台,開始您的 CoGrader 體驗。
驗證後,導覽到您指定的班級,啟動評量指標生成。直觀的儀表板提供全面的作業監督和內容管理功能。完整的課程資訊可確保精確的評量標準客製化,讓 AI 符合特定的課程需求。
平台導覽要點:
- 帳戶存取:在 CoGrader 的驗證入口輸入您的憑證。
- 課程選擇:從您的活動課程列表中找出相關課程。
- 作業管理:透過儀表板介面檢閱現有評估或建立新評估。詳細的作業規格可產生最佳的評量品質。
補充教學資源
專業發展平台
這些教育網站強化評估方法和回饋實務:
- Cult of Pedagogy:提供實用的教學資源,包括評分策略和回饋模型。
- Edutopia:分享以研究為基礎的教育創新,包括評估的最佳實務。
- ASCD:提供以卓越教學與評估技巧為重點的專業學習材料。
- Faculty Focus:提供高等教育資源,包括分級最佳化策略。
- 大學教學中心:許多院校都設有教學支援中心,並提供評估研討會。
教學技術工具
- Turnitin:具有寫作評估功能的學術誠信平台。
- Grammarly:改善文法的寫作增強工具。
- Google Classroom:用於分發作業的數位學習環境。
全面的 Rubric 製作過程
啟動評量指標開發
在課程介面中選擇您的目標作業。
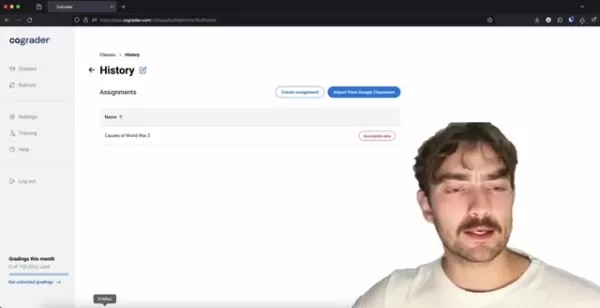
評估管理部分包含評量表設定選項,包括範本選擇和 AI 生成功能。選擇「產生新的評量標準」可啟動 CoGrader 的人工智慧架構。
實施步驟:
- 作業選擇:確定需要開發評量標準的特定評估。
- 紅寶石介面:在評量設定中找到紅寶石管理部分。
- 建立啟動:選擇產生新評量指標的選項。
最佳化紅寶石參數
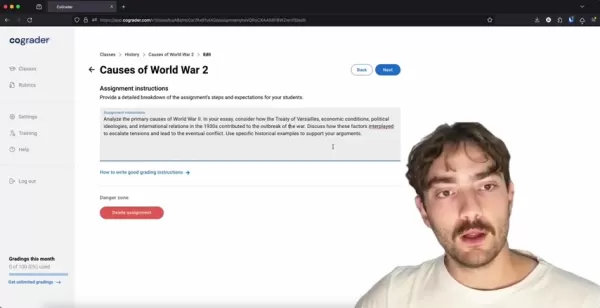
評量指標開發流程需要全面的作業細節。
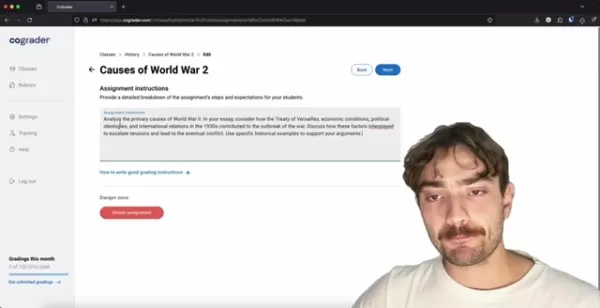
這些規格會引導人工智能產生相關的評量標準。精確的作業說明可以產生更高品質的評量標準。納入詳細的期望和概念框架,以提高評量標準的準確性。
作業描述最佳實務:
- 具體目標:定義可測量的學習成果。
- 元件要求:概述基本的評估要素。
- 術語精確度:包含特定學科的詞彙。
選擇評估架構
CoGrader 支援多種評量架構。
根據評估目標,在描述性能力等級或量化計分模型之間進行選擇。選擇取決於教學目標和評估偏好。
描述性評量表應用:
- 主觀評估情境
- 整體表現評估
- 創意表現專案
定量評量標准的應用:
- 客觀測量要求
- 特定標準評估
- 以知識為基礎的評估
強化量表規格
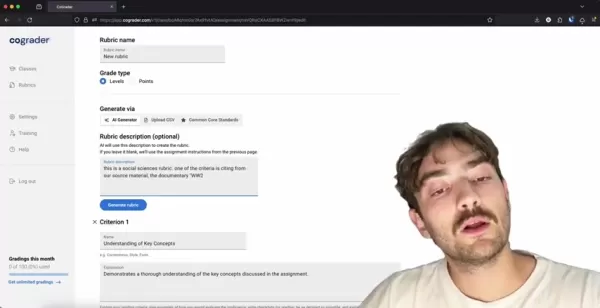
詳細的情境可以提高評量標準的品質。
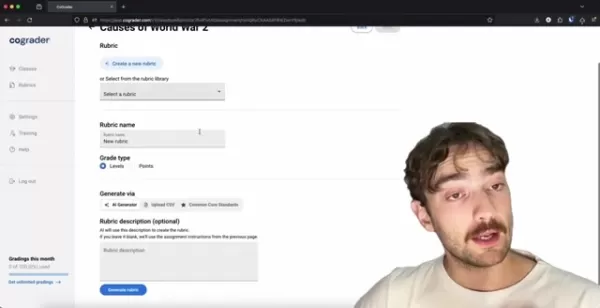
包括教學情境、特定科目要求和相關學術標準。全面的說明可確保評量標準與教學目標一致。
基本情境元素:
- 學科重點
- 發展程度
- 課程標準
- 評估目的
檢閱和改進已產生的評量標準
執行評量標準的產生,並進行全面的檢閱。
AI 會產生詳細的評量架構,並附有標準說明和表現範例。手動調整可確保完全符合教學目標。
評量指標檢閱元件:
- 評估維度
- 表現等級描述
- 標準說明
- 正面/負面範例
精準的評量指標客製化
AI 所產生的評量標準需要教育工作者加以改進。
調整評量維度、修改表現等級描述,並強化標準說明。持續的評量標準維護可保持評估的有效性。
自訂流程:
- 標準驗證
- 描述符改進
- 強化說明
- 資源整合
- 引用驗證
訂閱選項
靈活的授權結構
CoGrader 提供分層訂閱模式,以滿足不同機構的需求。
主要選擇考慮因素:
- 功能可及性
- 使用參數
- 可擴展性選項
- 試用可用性
平台評估
優勢
大幅降低評估工作量
確保評估統一性
提供實質的學生回饋
支援自適應性評量標準設計
與一般 LMS 平台整合
提供績效分析
促進差異化教學
注意事項
初始配置需要投入時間
可能會減少與學生的直接互動
必須減緩演算偏差
訂閱成本各異
取決於技術基礎架構
資料安全協定不可或缺
核心平台功能
自動化評估系統
CoGrader 的人工智能可分析學生提交的資料,產生有針對性的回饋,節省教育工作者的時間。
適應性評量框架
平台支援自訂評估設計,並可設定評估參數。
學習管理系統相容性
與主要學習管理系統的無縫整合簡化了評分工作流程。
分析報告
全面的績效追蹤讓您能根據資料做出教學決策。
教學應用
語言藝術實施
CoGrader 可有效評估作文品質、語法精確度和分析性寫作。
社會研究應用
此平台可評估研究品質、論據發展及歷史分析。
數學評估
CoGrader 分析解決問題的方法、運算的準確性和證明的建構。
常見問題
評分一致性保證
標準化的評分標準、自動回饋和分析追蹤可維持評估的可靠性。
LMS 相容性驗證
與 Canvas、Blackboard 和 Moodle 完全整合,確保運作的連續性。
學科適應性
平台的客製化架構支援各種學科。
相關注意事項
人工智能差異化
自適應學習系統可個人化內容傳送和教學步調。
實施挑戰
隱私權疑慮、演算法偏見和技術公平性是採用的障礙。
相關文章
 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
加州自動駕駛合規:罰單、地理圍欄與 100 萬英里的新時代
Guident 在南佛羅里達州營運一輛 AuveTech 接駁車,並運用其遠端監控技術,管理西棕櫚灘的一條四英里路線以及博卡拉頓的一條一英里路線。| 圖片來源:Guident加州正重新定義無人駕駛車輛的監管格局,從科技產業的「快速行動、打破常規」心態,轉向嚴格的問責制與嚴謹的行駛里程要求。Guident 執行董事長兼執行長哈羅德·布勞恩(Harold Braun)在《機器人報告》(The Robo
相關專題推薦
聊天機器人
 用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
 10 個工具
 xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

 評論 (2)
0/500
![RalphThomas]()
Honestly, as a student, I'm a bit torn. On one hand, anything that speeds up grading so teachers can focus more on actual teaching sounds fantastic. On the other, I hope it doesn't just standardize feedback into bland, generic comments. The human touch in grading matters, you know? 🤔 Let's see how this plays out in real classrooms.
![GeorgeTaylor]()
Quem dera isso existisse quando eu era aluno! 😅 Mas falando sério, automatizar rubricas parece uma ótima ideia pra dar feedback mais rápido. Ainda acho que a avaliação humana é importante pra certas coisas, como criatividade, mas pra corrigir tarefas mais mecânicas deve ser um alívio pros professores. Será que as escolas públicas conseguirão adotar?
在現今多變的教育環境中,教育工作者不斷尋找創新工具,以提高生產力和優化評分工作流程。CoGrader 的 AI 紅寶石生成器是一個突破性的解決方案,它能為教師提供高效的紅寶石創建功能。本指南展示了教育工作者如何利用 AI 技術開發評估工具,以減少工作量,同時保持評分的一致性。
主要功能
CoGrader 的 AI 紅寶石生成器透過智慧型自動化簡化評估設計。
教育工作者可以建立自訂的評量標準,或從廣泛的資料庫中選擇預先設計的範本。
該平台可根據詳細的作業要求和學習目標進行定制。
評量指標可適應各種評估格式,包括能力等級和數字評分系統。
教師可以將評估與共同核心標準相結合,進行以課程為基礎的評估。
自動產生的評量標準包含每個成就等級的全面描述和回應範例。
系統支援 CSV 檔案匯入,以進行無縫的評量標準整合。
CoGrader 透過內建的回饋機制促進綜合評估。
該工具可確保對所有學生作品進行客觀、標準化的評估。
教育工作者可透過手動編輯功能維持完全控制,以獲得個人化的回饋。
探索 CoGrader 的 AI 紅寶石生成器
瞭解 CoGrader 的核心功能
CoGrader 是一個先進的教育平台,支援多樣化的評分與評估需求。AI Rubric Generator 是其基石功能,可讓教師快速建構量身打造的評估框架。
此智慧型工具可處理作業參數,以產生適應性的評分標準,節省教學時間,同時確保評估的可靠性。透過自動化的評量標準開發,CoGrader 可讓教育工作者專注於教學策略和學生互動。
為什麼有效的評量標準很重要?它們為學生的表現建立了透明的基準,創造了一個負責任的學習生態系統。結構完善的評量標準定義了具體的期望和評估標準,幫助學生理解評估參數。這種透明度鼓勵了學習者的自主性和學術責任感。紅寶石還能提供多種教學優勢:
- 提高效率:手動制定評量標準需要投入大量時間。像 CoGrader 這樣的人工智能增強型工具可以大大簡化這個過程。
- 評估可靠性:標準化的評量標準可減少評分的不一致和評量者的偏見。
- 期望明確:有組織的評量標準結構可明確傳達專案要求。
- 有針對性的評估:評量標準可提供重點、建設性的回饋,引導學生改進。
進入 CoGrader 平台介面
透過安全的登入認證存取平台,開始您的 CoGrader 體驗。
驗證後,導覽到您指定的班級,啟動評量指標生成。直觀的儀表板提供全面的作業監督和內容管理功能。完整的課程資訊可確保精確的評量標準客製化,讓 AI 符合特定的課程需求。
平台導覽要點:
- 帳戶存取:在 CoGrader 的驗證入口輸入您的憑證。
- 課程選擇:從您的活動課程列表中找出相關課程。
- 作業管理:透過儀表板介面檢閱現有評估或建立新評估。詳細的作業規格可產生最佳的評量品質。
補充教學資源
專業發展平台
這些教育網站強化評估方法和回饋實務:
- Cult of Pedagogy:提供實用的教學資源,包括評分策略和回饋模型。
- Edutopia:分享以研究為基礎的教育創新,包括評估的最佳實務。
- ASCD:提供以卓越教學與評估技巧為重點的專業學習材料。
- Faculty Focus:提供高等教育資源,包括分級最佳化策略。
- 大學教學中心:許多院校都設有教學支援中心,並提供評估研討會。
教學技術工具
- Turnitin:具有寫作評估功能的學術誠信平台。
- Grammarly:改善文法的寫作增強工具。
- Google Classroom:用於分發作業的數位學習環境。
全面的 Rubric 製作過程
啟動評量指標開發
在課程介面中選擇您的目標作業。
評估管理部分包含評量表設定選項,包括範本選擇和 AI 生成功能。選擇「產生新的評量標準」可啟動 CoGrader 的人工智慧架構。
實施步驟:
- 作業選擇:確定需要開發評量標準的特定評估。
- 紅寶石介面:在評量設定中找到紅寶石管理部分。
- 建立啟動:選擇產生新評量指標的選項。
最佳化紅寶石參數
評量指標開發流程需要全面的作業細節。
這些規格會引導人工智能產生相關的評量標準。精確的作業說明可以產生更高品質的評量標準。納入詳細的期望和概念框架,以提高評量標準的準確性。
作業描述最佳實務:
- 具體目標:定義可測量的學習成果。
- 元件要求:概述基本的評估要素。
- 術語精確度:包含特定學科的詞彙。
選擇評估架構
CoGrader 支援多種評量架構。
根據評估目標,在描述性能力等級或量化計分模型之間進行選擇。選擇取決於教學目標和評估偏好。
描述性評量表應用:
- 主觀評估情境
- 整體表現評估
- 創意表現專案
定量評量標准的應用:
- 客觀測量要求
- 特定標準評估
- 以知識為基礎的評估
強化量表規格
詳細的情境可以提高評量標準的品質。
包括教學情境、特定科目要求和相關學術標準。全面的說明可確保評量標準與教學目標一致。
基本情境元素:
- 學科重點
- 發展程度
- 課程標準
- 評估目的
檢閱和改進已產生的評量標準
執行評量標準的產生,並進行全面的檢閱。
AI 會產生詳細的評量架構,並附有標準說明和表現範例。手動調整可確保完全符合教學目標。
評量指標檢閱元件:
- 評估維度
- 表現等級描述
- 標準說明
- 正面/負面範例
精準的評量指標客製化
AI 所產生的評量標準需要教育工作者加以改進。
調整評量維度、修改表現等級描述,並強化標準說明。持續的評量標準維護可保持評估的有效性。
自訂流程:
- 標準驗證
- 描述符改進
- 強化說明
- 資源整合
- 引用驗證
訂閱選項
靈活的授權結構
CoGrader 提供分層訂閱模式,以滿足不同機構的需求。
主要選擇考慮因素:
- 功能可及性
- 使用參數
- 可擴展性選項
- 試用可用性
平台評估
優勢
大幅降低評估工作量
確保評估統一性
提供實質的學生回饋
支援自適應性評量標準設計
與一般 LMS 平台整合
提供績效分析
促進差異化教學
注意事項
初始配置需要投入時間
可能會減少與學生的直接互動
必須減緩演算偏差
訂閱成本各異
取決於技術基礎架構
資料安全協定不可或缺
核心平台功能
自動化評估系統
CoGrader 的人工智能可分析學生提交的資料,產生有針對性的回饋,節省教育工作者的時間。
適應性評量框架
平台支援自訂評估設計,並可設定評估參數。
學習管理系統相容性
與主要學習管理系統的無縫整合簡化了評分工作流程。
分析報告
全面的績效追蹤讓您能根據資料做出教學決策。
教學應用
語言藝術實施
CoGrader 可有效評估作文品質、語法精確度和分析性寫作。
社會研究應用
此平台可評估研究品質、論據發展及歷史分析。
數學評估
CoGrader 分析解決問題的方法、運算的準確性和證明的建構。
常見問題
評分一致性保證
標準化的評分標準、自動回饋和分析追蹤可維持評估的可靠性。
LMS 相容性驗證
與 Canvas、Blackboard 和 Moodle 完全整合,確保運作的連續性。
學科適應性
平台的客製化架構支援各種學科。
相關注意事項
人工智能差異化
自適應學習系統可個人化內容傳送和教學步調。
實施挑戰
隱私權疑慮、演算法偏見和技術公平性是採用的障礙。








 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
 儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
加州自動駕駛合規:罰單、地理圍欄與 100 萬英里的新時代
Guident 在南佛羅里達州營運一輛 AuveTech 接駁車,並運用其遠端監控技術,管理西棕櫚灘的一條四英里路線以及博卡拉頓的一條一英里路線。| 圖片來源:Guident加州正重新定義無人駕駛車輛的監管格局,從科技產業的「快速行動、打破常規」心態,轉向嚴格的問責制與嚴謹的行駛里程要求。Guident 執行董事長兼執行長哈羅德·布勞恩(Harold Braun)在《機器人報告》(The Robo

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

Honestly, as a student, I'm a bit torn. On one hand, anything that speeds up grading so teachers can focus more on actual teaching sounds fantastic. On the other, I hope it doesn't just standardize feedback into bland, generic comments. The human touch in grading matters, you know? 🤔 Let's see how this plays out in real classrooms.
Quem dera isso existisse quando eu era aluno! 😅 Mas falando sério, automatizar rubricas parece uma ótima ideia pra dar feedback mais rápido. Ainda acho que a avaliação humana é importante pra certas coisas, como criatividade, mas pra corrigir tarefas mais mecânicas deve ser um alívio pros professores. Será que as escolas públicas conseguirão adotar?












