


 首頁
Anthropic 的 Mythos 重新定義了 Firefox 的網路安全策略
當 Anthropic 於四月推出其 Mythos 模型時,該公司也向軟體開發人員發出嚴正警告。該實驗室聲稱,該模型在識別軟體漏洞方面表現得如此出色,以致在模型公開發布前,已發現數千個必須修補的高嚴重性漏洞。
如今,專注於 Mozilla Firefox 瀏覽器的資安研究人員,正詳細剖析該流程在實際運作中的表現,以及 Mythos 的能力對軟體安全領域更廣泛的意義。
Mozilla 在週四發布的一篇貼文中指出,Mythos 已揭露大量高嚴重性漏洞,其中甚至包含某些潛藏在程式碼中長達十多年的隱藏缺陷。
這標誌著相較於僅六個月前人工智慧安全工具所能達成的成果,已取得重大飛躍。直到最近,人工智慧驅動的漏洞偵測工具仍存在嚴重限制,往往會因低品質報告和誤報而讓安全團隊不堪負荷。然而,Mozilla 的研究人員表示,最新一代的工具已達到轉捩點,特別是現在具自主性的系統能夠評估自身工作並過濾掉不良結果。
「這股勢頭在短短數月內為我們帶來的改變,其重要性再怎麼強調都不為過,」研究人員寫道。「首先,模型的能力大幅提升;其次,我們在運用這些模型的技術上也取得了顯著進步。」
圖片來源:Firefox
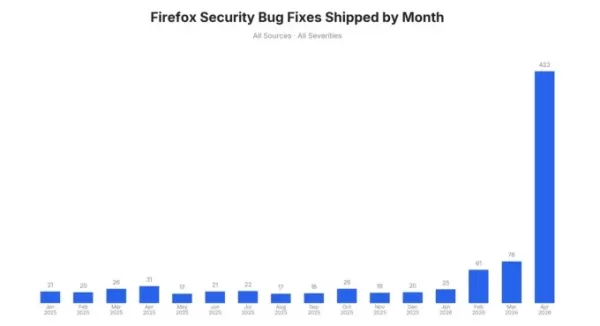
成果令人驚豔:2026年4月,Firefox 共發布了 423 項錯誤修復,相較於一年前同月的僅 31 項。研究人員還分享了其中 12 項錯誤的詳細資訊,範圍從兩項罕見的沙箱漏洞,到瀏覽器解析 HTML 元素時存在長達 15 年的錯誤。
「這些系統的表現其實是突然間變得非常出色,」Mozilla 傑出工程師 Brian Grinstead 向 TechCrunch 表示。「我們在自身的內部掃描中觀察到這一點,在外部的錯誤報告中看到這一點,更在業界各類訊號中都觀察到這一點。」
鑑於針對 Firefox「沙箱」系統的攻擊所需複雜度極高,該系統能協助發現此類漏洞的事實尤為值得注意。要找出沙箱漏洞,該模型必須為瀏覽器製作一個遭篡改的修補程式,然後在安裝新程式碼後,攻擊軟體中最安全的部分。發現並驗證此漏洞是一個精細且多步驟的過程,既需要創造力,也需高度精準。
為便於理解,Mozilla 的漏洞懸賞計畫針對 Firefox 沙箱漏洞的發現,提供研究人員最高 20,000 美元的獎勵——這是目前最高的獎金。儘管懸賞金額如此豐厚,Grinstead 表示 Mythos 發現的沙箱問題數量已遠超人類研究人員的歷史紀錄。「我們確實能發現這些漏洞,」他告訴 TechCrunch,「但數量遠不及我們運用這項技術所能發現的規模。」
值得注意的是,儘管人工智慧編碼工具的進展已有充分紀錄,Firefox 團隊目前仍未採用人工智慧來修復這些漏洞。該團隊確實會要求人工智慧為每個漏洞撰寫修補程式,但產出的程式碼通常無法直接部署,而是作為人類工程師的參考依據。
「針對本文中討論的漏洞,每個漏洞都由一名工程師撰寫修補程式,再由另一名工程師進行審查,」Grinstead 表示。「我們尚未發現這項工作可以自動化。」
人工智慧新興能力將如何重塑更廣泛的網路安全格局,目前仍不明朗。在 Mythos 預覽版發布一個月後,它發現的大部分漏洞很可能尚未修補,因此難以評估其全面影響。Anthropic 一直嚴格遵循負責任的披露規範,但惡意行為者很可能已在幕後使用類似技術,即使他們採用的模型較不先進。
Anthropic 執行長達里奧·阿莫迪(Dario Amodei)在近期一場活動中發言時,對新工具最終將有利於防禦方表達了樂觀態度。「如果我們處理得當,我們可能會比最初處於更有利的位置,因為我們修復了所有這些漏洞。可發現的漏洞數量是有限的,」阿莫迪表示。「所以我認為,在這個過程的另一端,會有一個更美好的世界。」
在考量過實際情況後,格林斯特德(Grinstead)提出了較為謹慎的觀點:「這對攻擊者和防禦者都有用,但擁有這項工具會讓優勢稍微偏向防禦方。現實來說,目前還沒有人知道確切的答案。」
相關文章
 Anthropic 推出 Opus 4.8,搭載全新的動態工作流程工具
Anthropic 於週四正式推出 Opus 4.8,這是其旗艦級公開模型的最新版本。此版本定價與前一版本相同,現已於所有平台上線。距離 Opus 4.7 發布僅隔 41 天,Anthropic 顯著加快了開發週期,遠快於近期 Sonnet 和 Haiku 版本所見的三個月及七個月間隔。此次快速更新很可能是為了回應 Opus 4.7 所獲得的冷淡反響,該版本曾讓許多使用者感到失望。與此同時,Ope
Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
Anthropic 推出 Fable:一款更實惠、限制更少的 AI 模型
Anthropic 於週二推出了 Fable 和 Mythos 5.1,提供了其最新 AI 技術的配對迭代版本。除了效能提升外,更新後的 Fable 版本還減少了令牌使用量,並收緊了安全過濾器,以最大限度地減少誤報限制。與其前身一樣,Mythos 5.1 僅限於專注於網路安全或生命科學的已驗證 Anthropic 合作伙伴。不受限制的 Fable 5.1 現在可透過雲平臺以及 Anthropic API 訪問。一項關鍵更新是採用了零資料保留策略,使客戶能夠在不洩露資料的情況下,將 Anthr
相關專題推薦
音樂創作
 用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
 8 個工具
 xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

 評論 (0)
0/500
當 Anthropic 於四月推出其 Mythos 模型時,該公司也向軟體開發人員發出嚴正警告。該實驗室聲稱,該模型在識別軟體漏洞方面表現得如此出色,以致在模型公開發布前,已發現數千個必須修補的高嚴重性漏洞。
如今,專注於 Mozilla Firefox 瀏覽器的資安研究人員,正詳細剖析該流程在實際運作中的表現,以及 Mythos 的能力對軟體安全領域更廣泛的意義。
Mozilla 在週四發布的一篇貼文中指出,Mythos 已揭露大量高嚴重性漏洞,其中甚至包含某些潛藏在程式碼中長達十多年的隱藏缺陷。
這標誌著相較於僅六個月前人工智慧安全工具所能達成的成果,已取得重大飛躍。直到最近,人工智慧驅動的漏洞偵測工具仍存在嚴重限制,往往會因低品質報告和誤報而讓安全團隊不堪負荷。然而,Mozilla 的研究人員表示,最新一代的工具已達到轉捩點,特別是現在具自主性的系統能夠評估自身工作並過濾掉不良結果。
「這股勢頭在短短數月內為我們帶來的改變,其重要性再怎麼強調都不為過,」研究人員寫道。「首先,模型的能力大幅提升;其次,我們在運用這些模型的技術上也取得了顯著進步。」
圖片來源:Firefox
成果令人驚豔:2026年4月,Firefox 共發布了 423 項錯誤修復,相較於一年前同月的僅 31 項。研究人員還分享了其中 12 項錯誤的詳細資訊,範圍從兩項罕見的沙箱漏洞,到瀏覽器解析 HTML 元素時存在長達 15 年的錯誤。
「這些系統的表現其實是突然間變得非常出色,」Mozilla 傑出工程師 Brian Grinstead 向 TechCrunch 表示。「我們在自身的內部掃描中觀察到這一點,在外部的錯誤報告中看到這一點,更在業界各類訊號中都觀察到這一點。」
鑑於針對 Firefox「沙箱」系統的攻擊所需複雜度極高,該系統能協助發現此類漏洞的事實尤為值得注意。要找出沙箱漏洞,該模型必須為瀏覽器製作一個遭篡改的修補程式,然後在安裝新程式碼後,攻擊軟體中最安全的部分。發現並驗證此漏洞是一個精細且多步驟的過程,既需要創造力,也需高度精準。
為便於理解,Mozilla 的漏洞懸賞計畫針對 Firefox 沙箱漏洞的發現,提供研究人員最高 20,000 美元的獎勵——這是目前最高的獎金。儘管懸賞金額如此豐厚,Grinstead 表示 Mythos 發現的沙箱問題數量已遠超人類研究人員的歷史紀錄。「我們確實能發現這些漏洞,」他告訴 TechCrunch,「但數量遠不及我們運用這項技術所能發現的規模。」
值得注意的是,儘管人工智慧編碼工具的進展已有充分紀錄,Firefox 團隊目前仍未採用人工智慧來修復這些漏洞。該團隊確實會要求人工智慧為每個漏洞撰寫修補程式,但產出的程式碼通常無法直接部署,而是作為人類工程師的參考依據。
「針對本文中討論的漏洞,每個漏洞都由一名工程師撰寫修補程式,再由另一名工程師進行審查,」Grinstead 表示。「我們尚未發現這項工作可以自動化。」
人工智慧新興能力將如何重塑更廣泛的網路安全格局,目前仍不明朗。在 Mythos 預覽版發布一個月後,它發現的大部分漏洞很可能尚未修補,因此難以評估其全面影響。Anthropic 一直嚴格遵循負責任的披露規範,但惡意行為者很可能已在幕後使用類似技術,即使他們採用的模型較不先進。
Anthropic 執行長達里奧·阿莫迪(Dario Amodei)在近期一場活動中發言時,對新工具最終將有利於防禦方表達了樂觀態度。「如果我們處理得當,我們可能會比最初處於更有利的位置,因為我們修復了所有這些漏洞。可發現的漏洞數量是有限的,」阿莫迪表示。「所以我認為,在這個過程的另一端,會有一個更美好的世界。」
在考量過實際情況後,格林斯特德(Grinstead)提出了較為謹慎的觀點:「這對攻擊者和防禦者都有用,但擁有這項工具會讓優勢稍微偏向防禦方。現實來說,目前還沒有人知道確切的答案。」








 Anthropic 推出 Opus 4.8,搭載全新的動態工作流程工具
Anthropic 於週四正式推出 Opus 4.8,這是其旗艦級公開模型的最新版本。此版本定價與前一版本相同,現已於所有平台上線。距離 Opus 4.7 發布僅隔 41 天,Anthropic 顯著加快了開發週期,遠快於近期 Sonnet 和 Haiku 版本所見的三個月及七個月間隔。此次快速更新很可能是為了回應 Opus 4.7 所獲得的冷淡反響,該版本曾讓許多使用者感到失望。與此同時,Ope
 Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
 Anthropic 推出 Fable:一款更實惠、限制更少的 AI 模型
Anthropic 於週二推出了 Fable 和 Mythos 5.1,提供了其最新 AI 技術的配對迭代版本。除了效能提升外,更新後的 Fable 版本還減少了令牌使用量,並收緊了安全過濾器,以最大限度地減少誤報限制。與其前身一樣,Mythos 5.1 僅限於專注於網路安全或生命科學的已驗證 Anthropic 合作伙伴。不受限制的 Fable 5.1 現在可透過雲平臺以及 Anthropic API 訪問。一項關鍵更新是採用了零資料保留策略,使客戶能夠在不洩露資料的情況下,將 Anthr

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai












