


 Дом
Вероятно, будут привлечены 9 миллионов долларов на создание более надежных ИИ-систем.
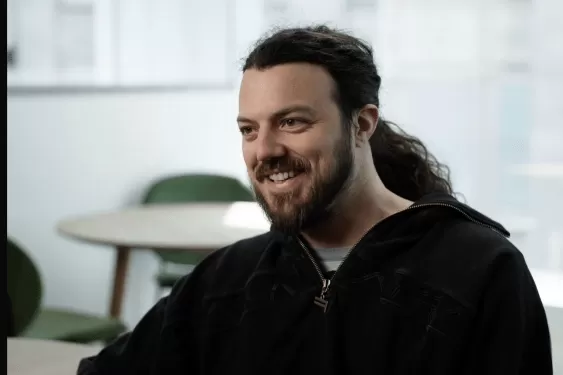
Несмотря на рост мощности больших языковых моделей, галлюцинации остаются серьёзной проблемой. Даже самые современные модели выдают ошибки, и хотя существуют методы их обнаружения, индустрия всё ещё работает над оптимизацией наилучших подходов.
Компания Probably, которая недавно получила 9 миллионов долларов в виде стартового финансирования от Andreessen Horowitz, стремится разработать более надёжный метод обнаружения ошибок.
Основатель компании Питер Элиас (на фото выше) объясняет, что миссия компании — не допускать появления галлюцинаций и фактических ошибок у пользователей, стремясь к точности 99,99%, характерной для детерминистических систем — уровню, которого гораздо сложнее достичь с помощью искусственного интеллекта. По его словам, для реализации этой цели при использовании больших языковых моделей необходимо пересмотреть основные предположения в области инжиниринга ИИ.
Первоначальным продуктом Probably является инструмент для работы с данными, предназначенный для быстрого получения ответов на основе сложных наборов данных. Каждый результат сопровождается ссылкой и записью этапов его формирования — практика, которая всё чаще становится стандартом в инструментах ИИ.
Чтобы предотвратить появление ошибок в этих кратких сводках, компания создала сложную систему поддержки, которую Элиас называет «скафандром для работы с данными». Первоначальные ответы большой языковой модели проверяются детерминистической системой, отвергающей любые результаты, не соответствующие исходному набору данных. Модель обучалась с учётом этого верификатора, а вся система оптимизирована с точки зрения скорости и точности, как утверждает компания.
«Мы поняли, что чем лучше разработана эта система поддержки, тем меньшей мощности требует модель», — говорит Элиас. «Если достаточно точно сформулировать контекст, модели не приходится усиленно стараться для получения правильных результатов. По сути, речь идёт о снижении неоднозначности».
Благодаря этому инструмент Probably может работать с гораздо более простыми моделями ИИ. Элиас отмечает, что текущая версия использует модель, «на четыре класса слабее передовых моделей», что позволяет ей работать на локальном оборудовании — на персональном компьютере, а не в центре обработки данных — тем самым значительно снижая затраты на токены, связанные с использованием ИИ.
Такой подход особенно актуален сейчас, когда стоимость токенов растёт, а многие клиенты пересматривают свои бюджеты на ИИ. Видение Элиаса выходит за рамки работы с данными; тот же двигатель можно адаптировать для таких областей, как бухгалтерский учёт или медицинские услуги — по его словам, «для любых задач, требующих высокой точности».
«Удивительно, что крупные лаборатории ИИ даже не пытались применить этот подход», — говорит Элиас. «У них есть стимулы не делать этого, поскольку они получают прибыль от необходимости постоянных корректировок».
Связанная статья
 Завершилась конференция TechCrunch Disrupt 2026
Настал последний день TechCrunch Disrupt 2026, который станет кульминацией насыщенной недели. В третий день в выставочном центре Moscone West в Сан-Франциско, где собрались более 10 000 основателей ст
QueryStory призывает к осторожности в отношении контента, сгенерированного искусственным интеллектом
В 2009 году Шапор Нагибзаде, работая инженером по системному администрированию в Google, открыл для себя силу убедительного повествования. Во время операции «Аврора», когда хакеры, действующие по зака
Разработка кода для ИИ обошлась в 12,15 млн юаней, что на 860 % превысило бюджет: внутренний инцидент в Amazon заставил забить тревогу по поводу затрат компаний на ИИ
Недавно американские СМИ сообщили о значительном превышении бюджета на проекты в области искусственного интеллекта в компании Amazon, где использование инженером модели Claude Sonnet от Anthropic для
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (0)
Несмотря на рост мощности больших языковых моделей, галлюцинации остаются серьёзной проблемой. Даже самые современные модели выдают ошибки, и хотя существуют методы их обнаружения, индустрия всё ещё работает над оптимизацией наилучших подходов.
Компания Probably, которая недавно получила 9 миллионов долларов в виде стартового финансирования от Andreessen Horowitz, стремится разработать более надёжный метод обнаружения ошибок.
Основатель компании Питер Элиас (на фото выше) объясняет, что миссия компании — не допускать появления галлюцинаций и фактических ошибок у пользователей, стремясь к точности 99,99%, характерной для детерминистических систем — уровню, которого гораздо сложнее достичь с помощью искусственного интеллекта. По его словам, для реализации этой цели при использовании больших языковых моделей необходимо пересмотреть основные предположения в области инжиниринга ИИ.
Первоначальным продуктом Probably является инструмент для работы с данными, предназначенный для быстрого получения ответов на основе сложных наборов данных. Каждый результат сопровождается ссылкой и записью этапов его формирования — практика, которая всё чаще становится стандартом в инструментах ИИ.
Чтобы предотвратить появление ошибок в этих кратких сводках, компания создала сложную систему поддержки, которую Элиас называет «скафандром для работы с данными». Первоначальные ответы большой языковой модели проверяются детерминистической системой, отвергающей любые результаты, не соответствующие исходному набору данных. Модель обучалась с учётом этого верификатора, а вся система оптимизирована с точки зрения скорости и точности, как утверждает компания.
«Мы поняли, что чем лучше разработана эта система поддержки, тем меньшей мощности требует модель», — говорит Элиас. «Если достаточно точно сформулировать контекст, модели не приходится усиленно стараться для получения правильных результатов. По сути, речь идёт о снижении неоднозначности».
Благодаря этому инструмент Probably может работать с гораздо более простыми моделями ИИ. Элиас отмечает, что текущая версия использует модель, «на четыре класса слабее передовых моделей», что позволяет ей работать на локальном оборудовании — на персональном компьютере, а не в центре обработки данных — тем самым значительно снижая затраты на токены, связанные с использованием ИИ.
Такой подход особенно актуален сейчас, когда стоимость токенов растёт, а многие клиенты пересматривают свои бюджеты на ИИ. Видение Элиаса выходит за рамки работы с данными; тот же двигатель можно адаптировать для таких областей, как бухгалтерский учёт или медицинские услуги — по его словам, «для любых задач, требующих высокой точности».
«Удивительно, что крупные лаборатории ИИ даже не пытались применить этот подход», — говорит Элиас. «У них есть стимулы не делать этого, поскольку они получают прибыль от необходимости постоянных корректировок».








 Завершилась конференция TechCrunch Disrupt 2026
Настал последний день TechCrunch Disrupt 2026, который станет кульминацией насыщенной недели. В третий день в выставочном центре Moscone West в Сан-Франциско, где собрались более 10 000 основателей ст
 QueryStory призывает к осторожности в отношении контента, сгенерированного искусственным интеллектом
В 2009 году Шапор Нагибзаде, работая инженером по системному администрированию в Google, открыл для себя силу убедительного повествования. Во время операции «Аврора», когда хакеры, действующие по зака
 Разработка кода для ИИ обошлась в 12,15 млн юаней, что на 860 % превысило бюджет: внутренний инцидент в Amazon заставил забить тревогу по поводу затрат компаний на ИИ
Недавно американские СМИ сообщили о значительном превышении бюджета на проекты в области искусственного интеллекта в компании Amazon, где использование инженером модели Claude Sonnet от Anthropic для

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai












